-
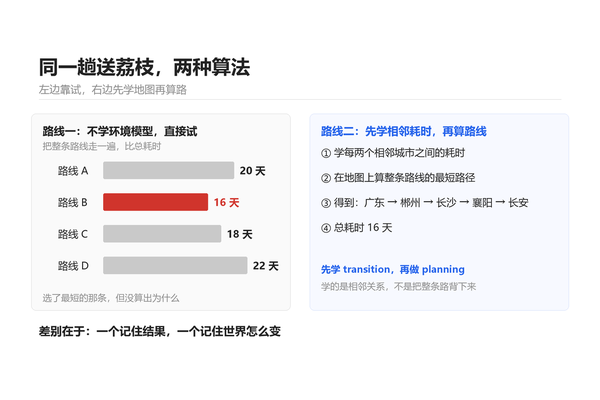 世界模型不画未来,只算抓不抓得住:千诀比LeCun早一年
千诀科技 10 月 20 日在南京发布预测式世界模型 Polibrain:它不生成未来画面,只在任务相关的潜在表征空间里预测影响行动的状态。创始人高海川用「有地图能推路径,有路径推不出地图」作比。千诀联合清华 2025 年那篇 ICML 论文,早于 LeCun 团队 2026 年 5 月的同方向研究约一年。文中也列了三处作者自陈的局限。
-
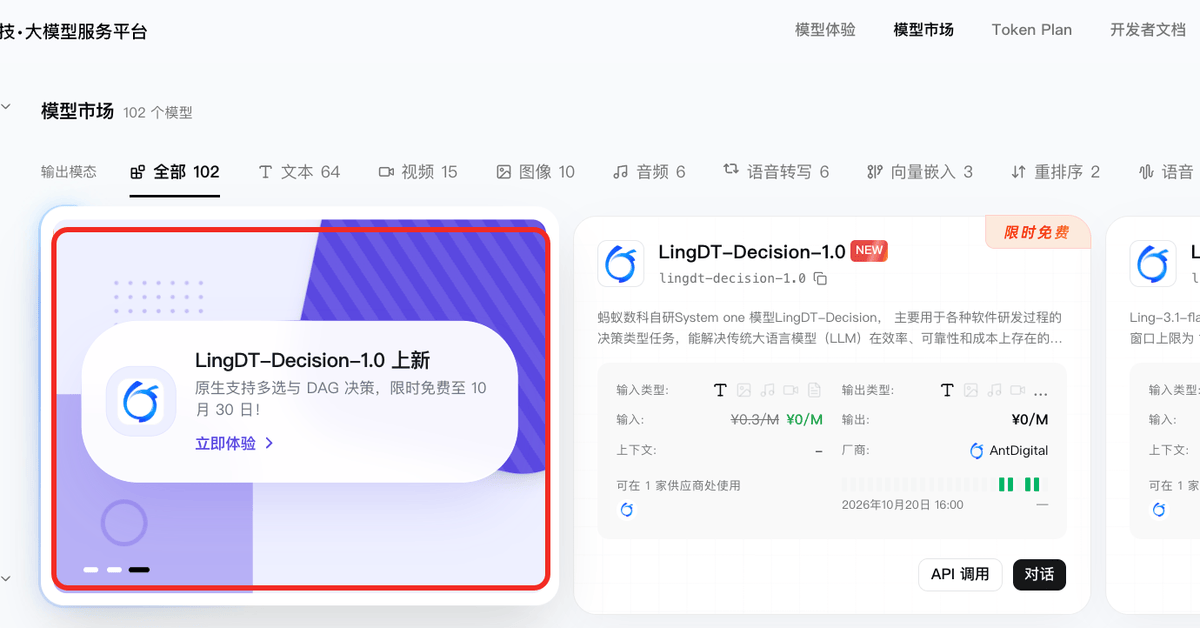 蚂蚁发了个不会写话的模型:Token 少 90%,快 10 倍
蚂蚁数科 10 月 22 日发布决策模型 LingDT-Decision-1.0,有 4B 与 27B 两个版本,已在自建平台限时免费。它不生成句子,只在给定选项里挑一个,官方称相比大语言模型 Token 消耗降低超 90%、响应时效提升 10 倍。本文把这个数字的对比基线逐条拆开,并指出报道没提的一个细节:4B 版本在同尺寸组里其实排第二,只差 0.07 分。
-
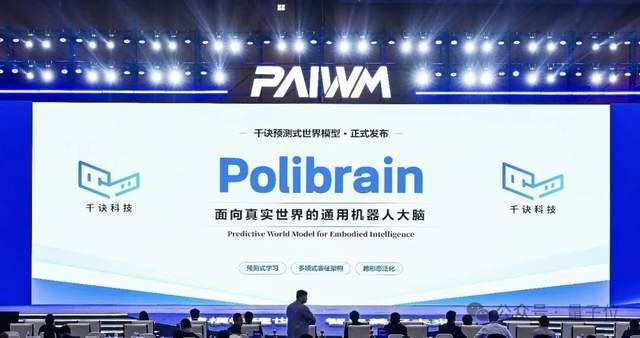 机器人捡垃圾前,先给自己画了张地图
千诀科技 2026 年 10 月 20 日在南京物理 AI 与世界模型大会上发布预测式世界模型 Polibrain。核心比喻是:有了地图可以推出最短路径,但有了路径反推不出地图。文中还原了「主人出门拿走钥匙」被误当因果的例子,也写清边界——报道明确说这套机制在复杂场景是否可靠还需更完整的实测数据,抓取成功率等指标没有公开。
-
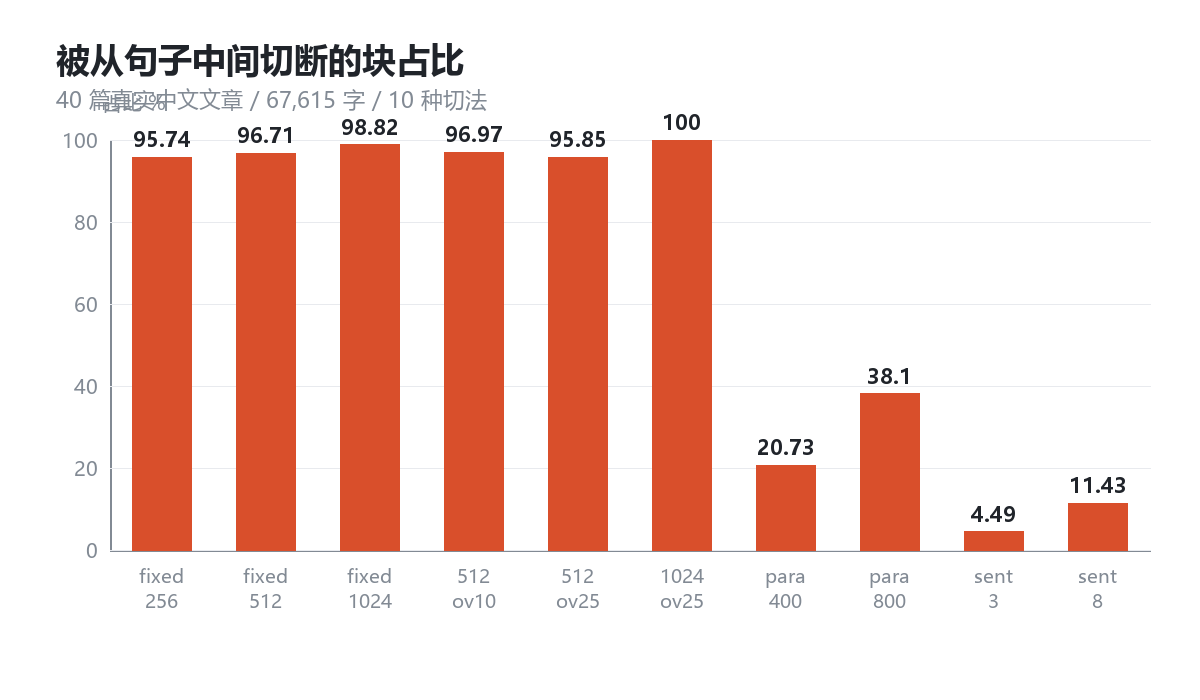 25%重叠多出28%重复字符,召回反而降了
拿 40 篇真实中文文章、共 67,615 字,用 10 种切法各切一遍,量三件事:块被从句子中间切断的比例、切片总量多出来的重复字符、以及检索时正确的块能不能排到第一。固定字数切块九成五以上断在半句话上;加 25% 重叠让重复字符涨到 28.27%,R@1 反而从 91.15% 降到 89.17%;按段落切的 para_800 拿到最高的 93.33%。
-
 一个汉字占几个 token:我把两万个汉字挨个数了一遍
把 CJK 基本区 20,992 个汉字逐个送进分词器:旧分词器里只有 2.6% 能压进一个 token,平均每字 2.357 个;换成新分词器是 12.0%、1.922 个。再用自己写的六篇文章实测,一个汉字 1.575 个 token,换分词器省 26%。六篇 16,201 个 token 里有 4,975 个是「半个字」。
-
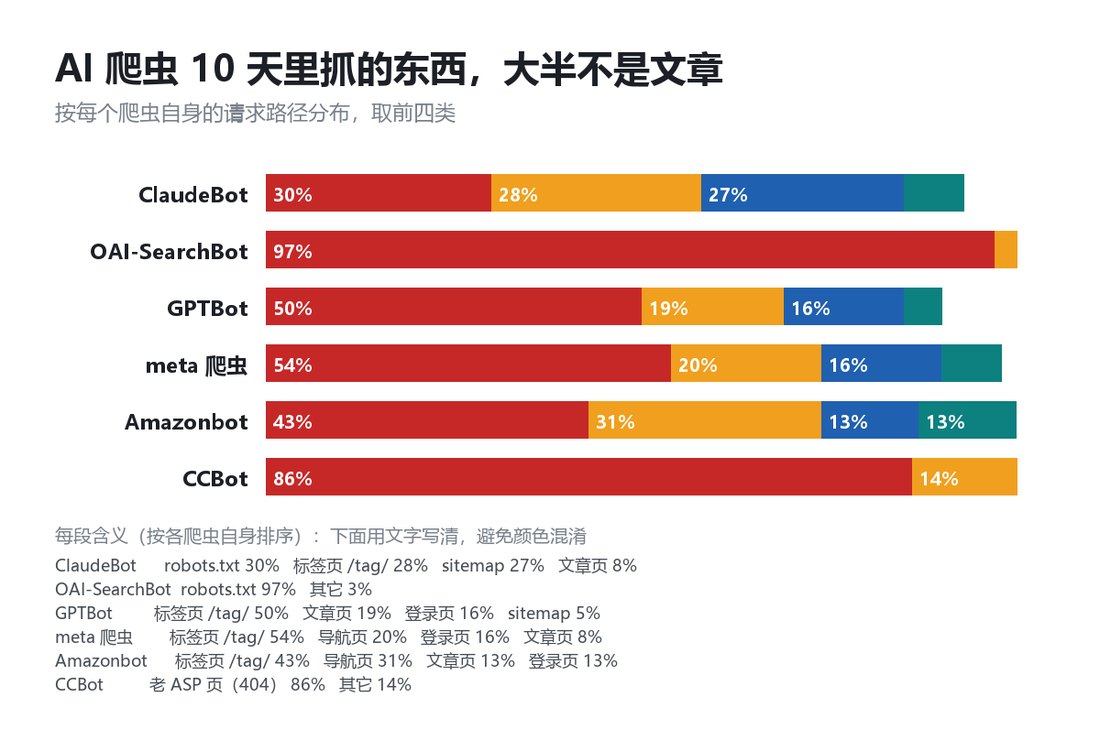 AI 爬虫在我站上待了 10 天,真正读到文章的不到一成
Anthropic 的 ClaudeBot 来了 472 次,其中 57% 在读 robots.txt 和 sitemap.xml,落到文章页的只有 8%。OpenAI 的 OAI-SearchBot 更极端:29 次请求里 28 次在读 robots.txt。Common Crawl 的 CCBot 有 86% 在抓一个早就下线的老路径。
-
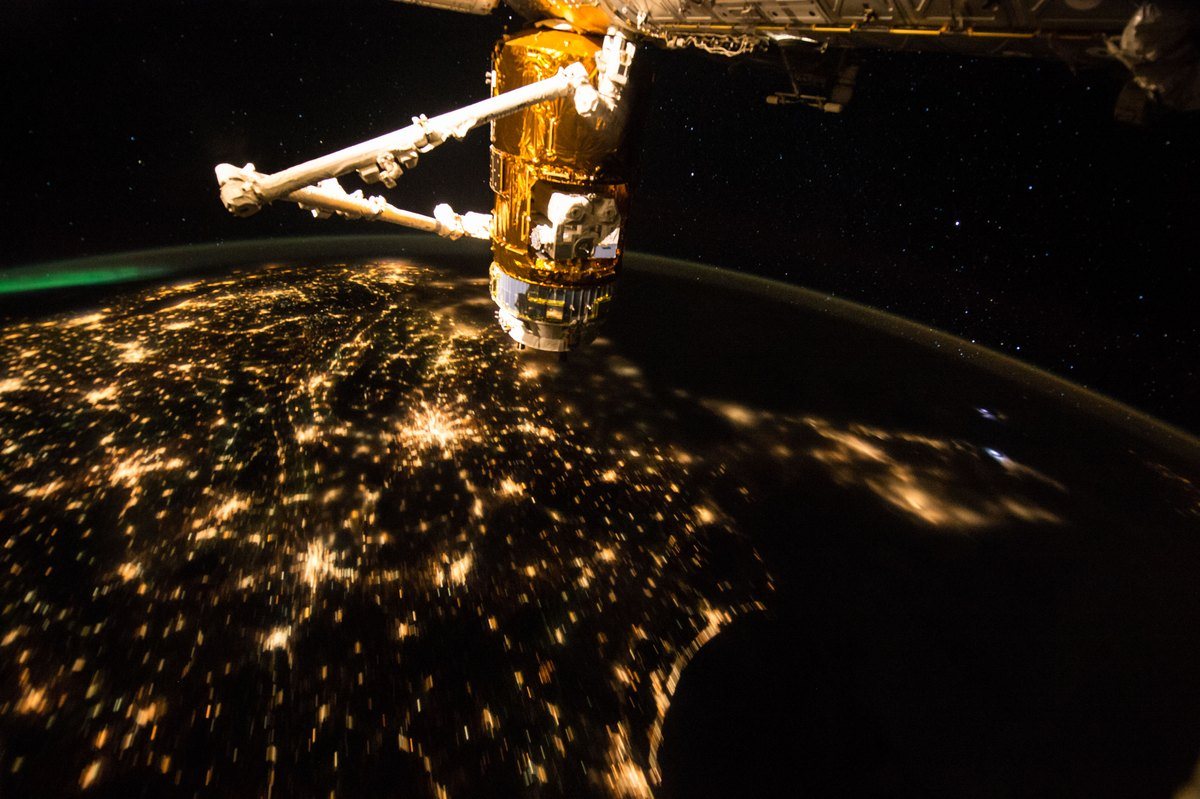 AI 看图到底看清了多少:我把这张照片缩了 6 遍
一张 NASA 拍的 1616 万像素太空照片,进模型前被缩成 224×224,只剩原来 0.31% 的像素。我把同一张图缩成六个尺寸问同一个问题:112 像素时背景的地球夜景彻底消失,56 像素时它把这张太空照片说成了昆虫。
-
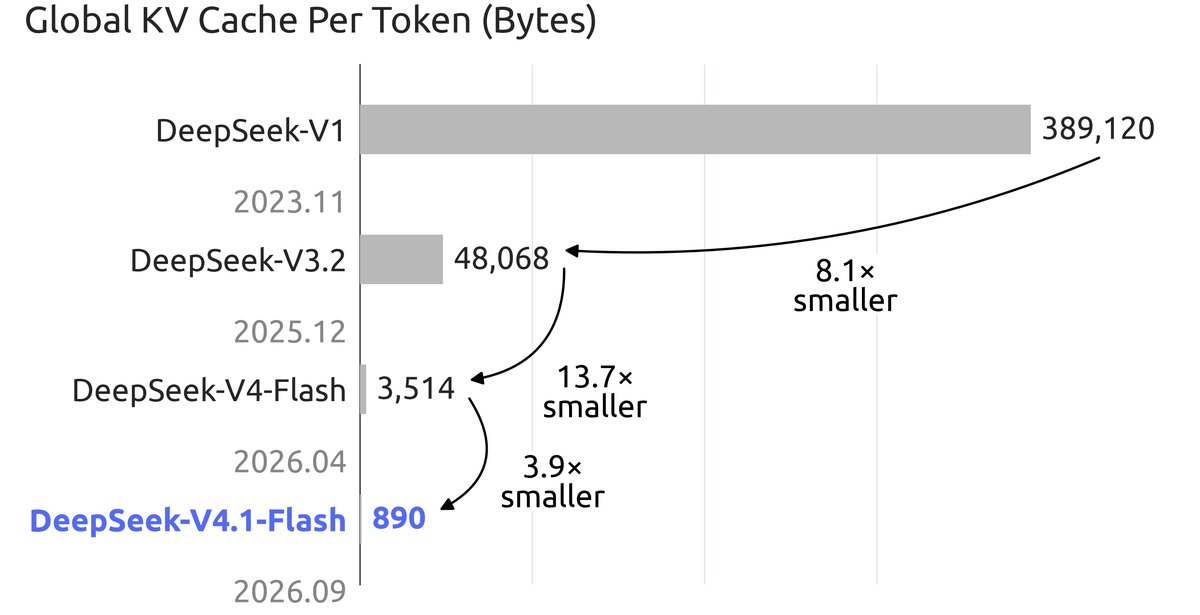 5520 亿把 1.6 万亿顶掉了,DeepSeek 换掉了自家旗舰
DeepSeek 9 月 10 日发布 V4.1 Flash,并在 4 天后把请求从自家旗舰 V4 Pro 转到它身上。被顶掉的旗舰骨干参数 1.6T,顶上来的这个只有 552B。官方给的理由不是更聪明,而是每 token 的全局 KV 缓存从 3514 字节压到 890 字节,对 HBM 的需求只剩四分之一。同时它输在哪几项也写在评测表上:世界知识、多语、纯数学、长文本理解。
-
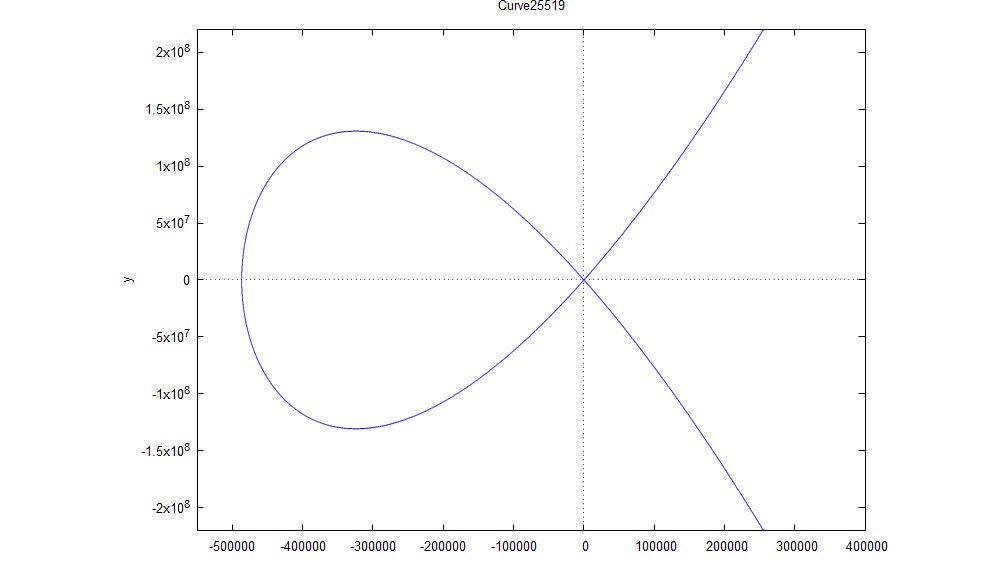 密码学家怀疑了26年的事,被一个AI在半小时内翻了出来
Anthropic 于 10 月 16 日发布博文,宣布内部研究用 Claude 模型在不到 30 分钟内,追溯出五条美国国家标准与技术研究院(NIST)标准椭圆曲线的种子来源,为一桩延续约 26 年的密码学悬案给出了可复现的答案。这些曲线 2000 年被纳入美国数字签名标准,种子由 NSA 提供却未说明生成过程,长期引发是否暗藏后门的猜测。Claude 排查上世纪 90 年代常用软件工具,发现种子来自 C 语言库中的伪随机数生成器 lrand48,初始化输入是 Unix 时间戳,生成时间落在 1997 至 1998 年;P-256 的标准种子对应 1997 年 8 月 16 日一次运行中的第 1842 个候选值。团队已公开复现代码。Anthropic 强调这不是破解 ECDSA,也没有发现新的攻击方式,用户无需因此采取措施;但 B-163 种子来源、部分曲线基点生成方式、以及为何跳过某些可用候选曲线仍未解释。
-
 每次跟AI对话都要重讲一遍,这事终于有人管了
腾讯混元开源智能体记忆框架 Hy Memory 2.0,开源专用模型、记忆框架与 MemHub 应用三层能力。框架层负责聊天、工作、代码三类记忆的存储、更新与进化,官方称是业界首个提出工作记忆与代码记忆的框架。官方称在 4 个 Benchmark 上对比 Mem0、MemOS、EverOS 等开源框架均列第一;专用模型 Hy-Memory-30A3B 约 3B 激活参数,宏观平均 55.49%,高于 Claude Opus 5 的 54.62%。SDK 与 MemHub 已在 GitHub 开源,模型权重发布在 Hugging Face。
-
 英伟达这次没堆参数,反而砍到120亿
英伟达发布开放多模态模型 Nemotron 3.5 Super VL,面向需要持续运行、执行多步骤任务的 AI 智能体。MoE 架构,总参数 1200 亿、激活 120 亿,官方称单张 GPU 上执行智能体任务时吞吐量最高可达同规模其他开放模型的 5 倍。企业案例:Scale AI 为 Skydance 定制供应商信用处理智能体,推理成本预计降 97.5%;Ramp 做收据转结构化数据,吞吐最高提升 50%。同时推出端侧 Bolt 74B-A9B,原生 2 位量化压缩至 24GB。
-
 AI越跑越贵,问题可能出在存储这一环
SK 海力士公布 3D FeNAND 研究成果,用它实现模拟存内计算(A-CiM),用铁电材料的极化状态存储数据并控制电流,可在单个存储单元内产生多种电流状态,适合 AI 计算所需的权重数据。相比传统 3D NAND 的电荷俘获结构,铁电材料在外部电场消失后极化仍保持,研究发表于 IEEE 论文。
-
 基辛格又开炮:HBM是糟糕的内存,AI算力卡在哪
前英特尔CEO基辛格在a16z专访中批评HBM,称其位密度低、散热差、海岸线带宽受限,对AI这类内存计算密集型负载是灾难性的。报道同时提到,整摞堆叠后每平方毫米的累计密度其实更高。
-
 100万token一夜重构,谷歌这模型把数月活干成数周
谷歌 Gemini 4 Argon 上线,支持最高约100万 token 的长解码输出,但输入、思考、输出共用同一个上下文窗口。官方称其擅长编码、金融、法律、网络安全、科学,Vals Index 排名第一。入门价输入每百万 token 2美元、输出10美元,11月30日后翻倍。
-
 3GB内存跑大模型,iPhone也能13 token/s
面壁智能发布端侧多模态大模型 MiniCPM-V 4.7,含 35B-A3B 与 1B 两个规格,35B-A3B 是系列首个 MoE 模型。官方称在 iPhone 17 Pro Max 上以仅 3GB 内存达到 13+ token/s 解码速度,支持 iOS、安卓与鸿蒙,适配 Intel、AMD、Arm、瑞芯微、后摩等芯片平台,并同步开源 SRFT 微调方案。