它不生成句子,只在给定选项里挑一个。企业里那些一天几十万次的判断,可能真不需要大模型开口说话。
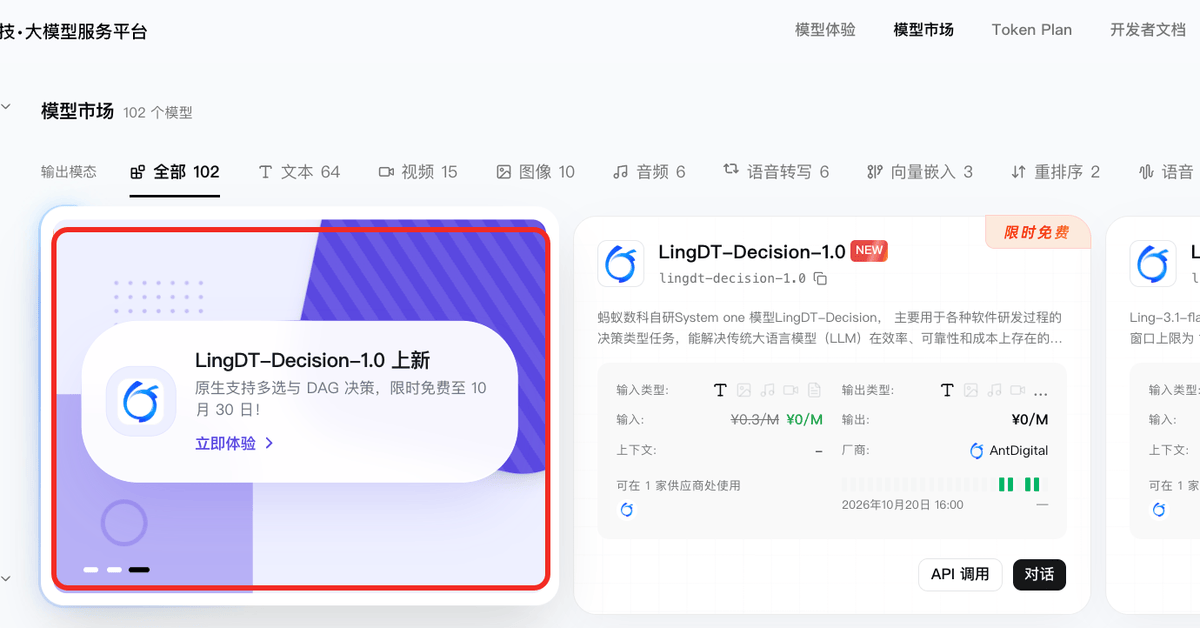
先把新闻说清楚。10 月 22 日,蚂蚁数科发布决策模型 LingDT-Decision-1.0,有 4B 和 27B 两个版本,已经在他们自己的 DTMaaS 平台上架,限时免费。我打开那个平台的模型市场看了一眼,页面上写着限时免费到 10 月 30 日,输入价格从 0.3 元每百万 token 划掉改成 0,输出也是 0。
下面这些都是它官方给的数字。我没有实测过,也没找到第三方复现。
一、一个工单要判断四件事
用户在客服窗口发来一句,这个订单已经三天了还没发货,请尽快处理。系统接到这句话,得决定四件事:这是催单、投诉还是退款申请,急不急,派给哪个部门,要不要转人工。四个问题,四组选项。
大语言模型怎么做这件事?它会写一段话,说这应该是一个催单类的问题,从语气看客户比较急,建议优先处理,可以派给售后二组。然后你的代码去解析这段中文。
解析是最容易出事的环节。模型今天写催单类,明天写属于催单,后天写这是一个催单请求,三个正则都不够用。
决策模型的思路是,这句话不写,直接从「催单、投诉、退款」里挑一个。官方的说法是把先生成结构化答案再解析,改成在限定选项中直接判断。差别不在于准不准,在于省掉了中间那一层。
二、省下来的是一整段生成过程
Token 是按字数计费的,大模型要输出那段解释,就得一个 token 一个 token 往外吐。判断类任务有个特点,结论很短,一个词就够,解释很长,一整句。所以省掉解释,省掉的就是大部分开销。
官方给的整体数字是,相比大语言模型,Token 消耗降低超过 90%,响应时效提升 10 倍。
我自己的理解是,这 90% 里绝大部分是那段话,不是那个判断,判断本身还是要算一次前向。这也意味着能省多少取决于原来那段解释有多长。如果你的提示词本来就写着「只回答一个词,不要解释」,换成决策模型后省下的会少很多。这一点报道里没细说,是我的推断,没实测过。
三、三个场景的数字,对比对象都不一样
官方给了三个真实业务场景的测试数据,我把对比对象一起抄下来,因为不抄就没法看。
数据标注场景,相比 DS-V4-flash,Token 消耗降低约 97%,处理时效提升约 10 倍。智能客服场景,相比 Qwen-3.7-flash,Token 消耗降低 90%,处理时效提升约 1 倍,风险识别准确率从 76% 提到 89%。金融场景,在意图识别、工具调用、幻觉检测这类任务上,处理时效提升约 5 倍,工具组合完全匹配率提升约 2.6 倍,幻觉召回率从 44% 提到 70%。
三个场景,三个不同的对手模型。所以「降 90%」不是一个可以到处搬的通用数字,它说的是跟某个特定模型比的结果,换个更大的模型来比,这个比例会变。我看到不少转述把这三个数字混在一起写成「Token 降 90%」,其实它们对应的基线各不相同。
四、成绩单要看得细一点
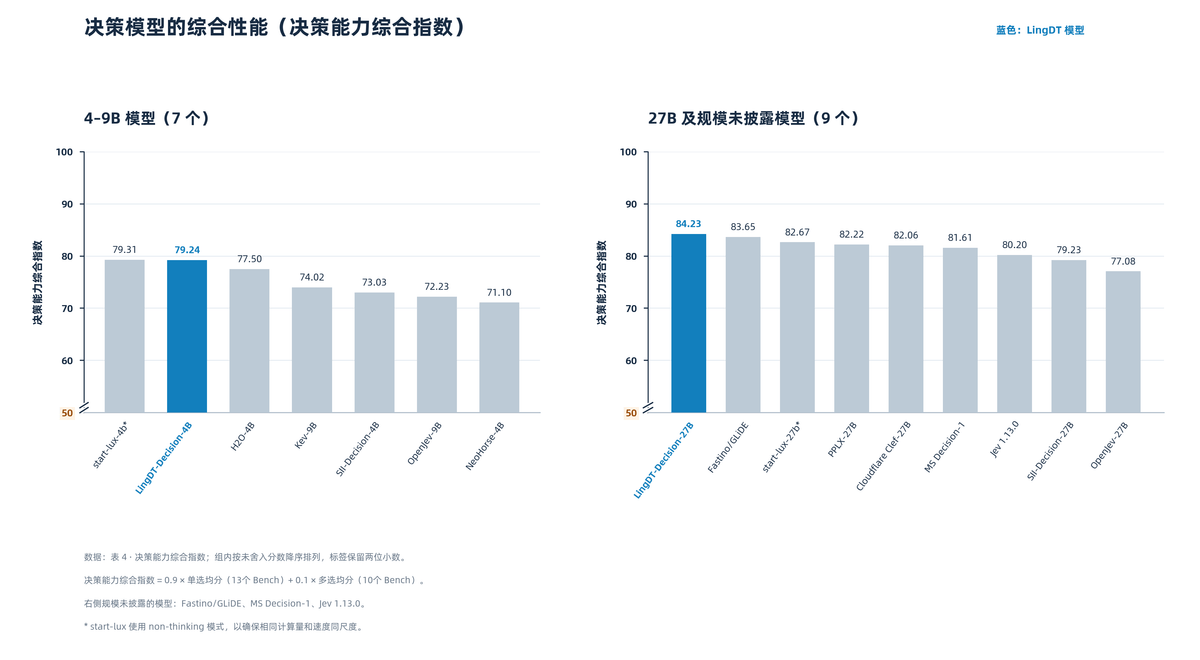
23 项开源评测基准,综合指数的算法是 0.9 乘单选均分(13 个 Bench),加 0.1 乘多选均分(10 个 Bench)。
27B 版本综合指数 84.23,同尺寸组里排第二的是 start-lux-27b,82.67,差 1.56 分。4B 版本综合指数 79.24,同尺寸组里排第一的是 start-lux-4b,79.31,差了 0.07 分,4B 版本是组内第二。
报道的原话是综合评分位居第一,图注写的是 4B 与 27B 在单选判断能力属于第一档。这两句都不算错,但那 0.07 分报道没提,我是从它自己那张散点图上一格格读出来的。0.07 分大概是一百道题里差零点零七道,基本等于打平。
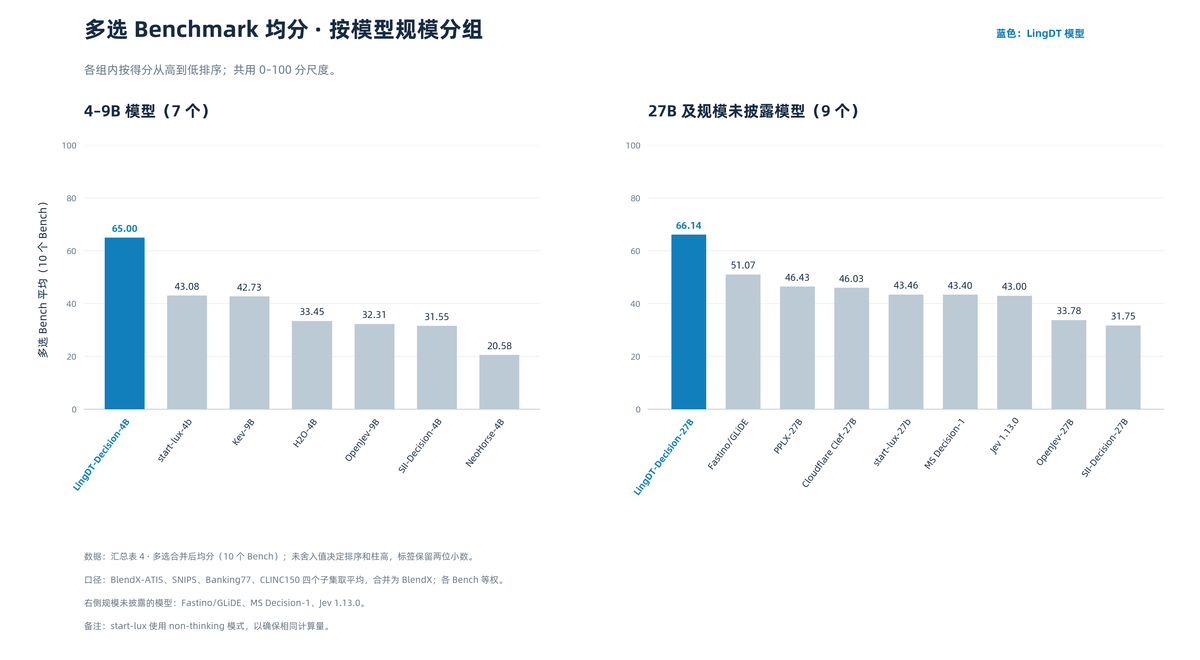
另一个细节是权重。多选只占 10%,而这款模型最强调的卖点,恰好是首创原生多选和按序决策。最想讲的那个能力,在这张综合成绩单里只占十分之一的份量。看多选单独那张图,差距就明显了,4B 版本 65.00,27B 版本 66.14,都是组内第一。
我说这些不是挑刺。同一套数据,换个权重,结论就会变,拿哪张图说话,取决于想说什么。
五、它做不了什么
不生成文本,意味着它不解释理由。你问它为什么判成催单,它大概率只回一个选项,想让它说清楚,得另外挂一个模型去解释。这一点报道没提,我按「决策模型不生成文本」这个定义推的,属于个人判断,没有实测。
能力范围也窄。官方列的是判断、单选、分类、评级,加上多选和按序决策,写文案、开放对话、长文推理都不在这个模型的范围里。参数只有 4B 和 27B 两档,小是优点,便宜、快、部署轻,也是限制,能理解的东西终究有限。
还有两项我没法核实。一是不确定它的具体响应延迟是多少毫秒,报道只给了相对倍数,没给绝对值。二是不清楚那 23 项基准具体包括哪些,报道只说了总数和两类分组。
六、按序决策这个功能,其实是给流程用的
官方举的例子挺实在。用户说,我要退款、关闭续费、补开发票,但不要注销账号。单选只能抓主诉求,通常抓退款,剩下两个漏掉,多选能一次抓全。
按序决策再进一步,退款要先核验,关闭续费可以先做,发票可能要等退款结果出来。这三件事的依赖关系,业务里本来就有,不是模型自己想的,模型做的是把它识别出来。
这个功能我觉得是整套东西里最实用的部分,因为它对应的是真实工单的形状,真实工单很少只含一个诉求。不过依赖关系这部分报道没说清楚是谁定义的,是模型自己推的,还是你预先给它一张流程图。我倾向于后者,但这只是猜测。
七、什么时候值得换
判断标准其实很简单,看你那边判断任务一天多少次,选项集是不是固定的。
一天几十万次、选项固定,比如客服工单路由、内容分类、风控规则命中,换专用模型的账很好算,省下的 token 是按比例省的,量越大越明显。一周几百次,用现成的通用模型就行,省的钱不够折腾。
中间那一档要看情况。还有一个隐性成本,报道当然不会提,换模型意味着重写对接代码、重建评测集、重新跑一遍回归。这部分工作量,往往比省下的钱贵。
你手上如果有每天几十万次调用的判断任务,会考虑换吗。