10 月 20 日,首届 2026 物理 AI 与世界模型大会在南京开幕。LeCun 远程讲了,姚期智也远程讲了。
会上千诀科技发布了预测式世界模型 Polibrain。
这个名字我一开始没记住。记住的是创始人高海川在开幕式上的一句话:
"有了地图,可以推导出最短路径;但有了路径,并不能反过来推导出一张地图。"
一、一个送荔枝的比喻
高海川在演讲里讲了个事:古代商人要把荔枝从广州运到长安,怎么找最快的路。
他给了两种解法。一种是把可能的路线全走一遍,从中挑最优的;另一种是先弄清沿途有哪些城市、城市之间怎么连,画出一张地图,再照地图规划。
前者对应现在的 VLA 路线,后者对应世界模型的预测与规划方法。
差别落在一点上:机器人能不能在动手之前,先推演出这一步会产生什么结果。
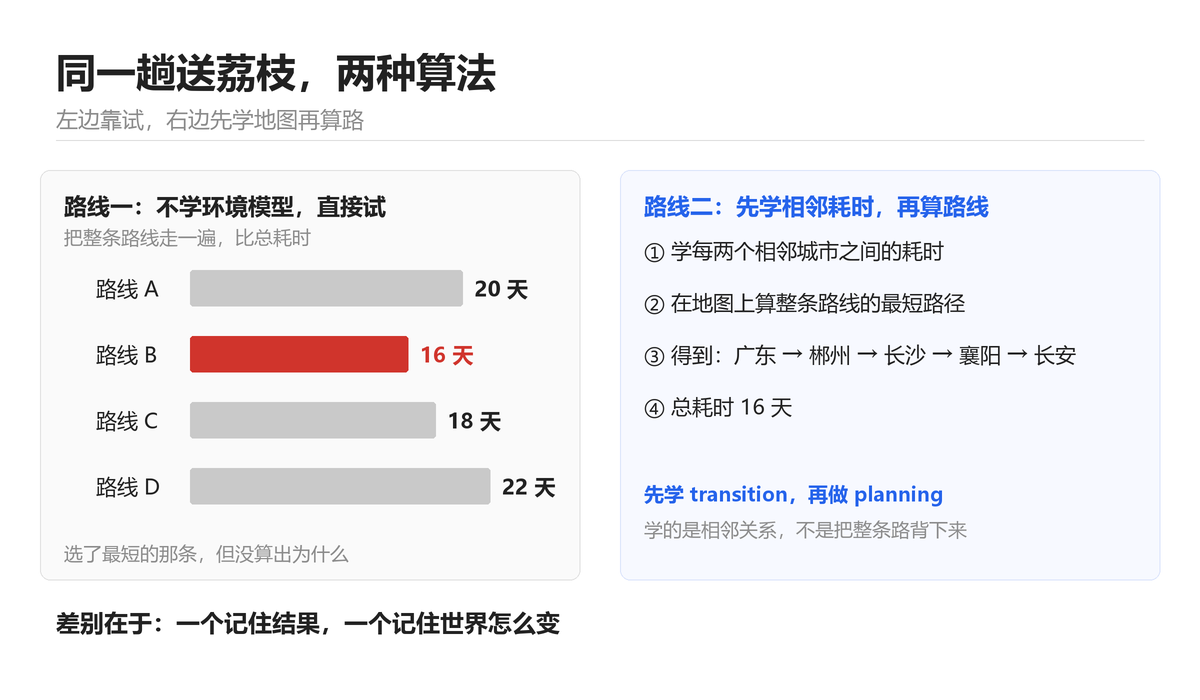
【个人看法】这个比喻好懂,但也把问题简化了。真实情况是画地图本身有成本,而且地图画错了比不画更糟。一张错的地图,会让你更自信地走错路。
二、不生成画面,这跟主流不太一样
现在多数世界模型在做同一件事:预测未来的画面。给一段视频,输出后面几帧,像素级还原。
Polibrain 不做这个。
【原文数据】它通过学习环境状态、历史信息、行动结果之间的关系,在任务相关的潜在表征空间中预测状态变化。
换个具体场景。千诀给的演示视频里,一台四足机器狗背着回收筐、带机械臂,在户外找地上的垃圾,靠过去,规划机械臂,抓起来,放进筐。
这一串动作背后是连环决策:垃圾在哪、从哪个方向靠近、伸出去能不能抓住。
画面里地面是什么颜色、背景有多少纹理,对任务没影响。真正影响的是垃圾的位置、机械臂和目标的相对关系、抓取动作会怎么改变目标状态。
高海川的说法是:"世界模型要做好,关键在于状态表征。"
【个人看法】这是这条路线最有说服力的地方。省算力是一方面,更重要的是它把"预测"的目标换了:从还原世界,改成判断行动后果。对机器人来说,后者才有用。前者就算做到满分,机械臂也不知道该往哪伸。
三、一条链路,以及千诀自己写的局限
Polibrain 把环境感知、状态理解、行动预测、任务决策、动作执行、反馈调整串成一条链路。执行结果和预测不一致时,模型可以按新的环境状态重新评估任务,调整后续动作。它还支持通过关键特征解码,追踪预期状态和实际结果之间的偏差,用来定位异常。
这段是能力描述。往下是千诀自己写进文中的局限。
【原文数据】原文:"这套机制在复杂场景中究竟有多可靠,还需要更完整的实测数据验证。"
我把这句抄下来了,因为它出现在正文中间,不在文末的免责说明里。
【个人看法】这句话分量不轻。复杂场景可靠性未验证,意味着上面那个捡垃圾的演示,目前只能算特定条件下的样本,不是普遍能力的证明。展会视频和产线表现之间的差距,做工程的人心里都有数。
四、比 LeCun 早一年,这事要怎么看
2025 年,千诀联合清华大学团队在 ICML 发表论文《When Do Neural Networks Learn World Models?》,研究神经网络在什么条件下能从观测数据中恢复隐藏的世界结构。方法是用 Fourier-Walsh 变换分析离散布尔世界中的函数结构,切入点是多任务学习和低阶偏好。
2026 年 5 月,LeCun 等人发表《When Does LeJEPA Learn a World Model?》,同样研究世界模型的隐变量可辨识性,以及函数阶次与低阶偏好之间的关系。
从公开发表时间看,前一篇比后一篇早约一年。
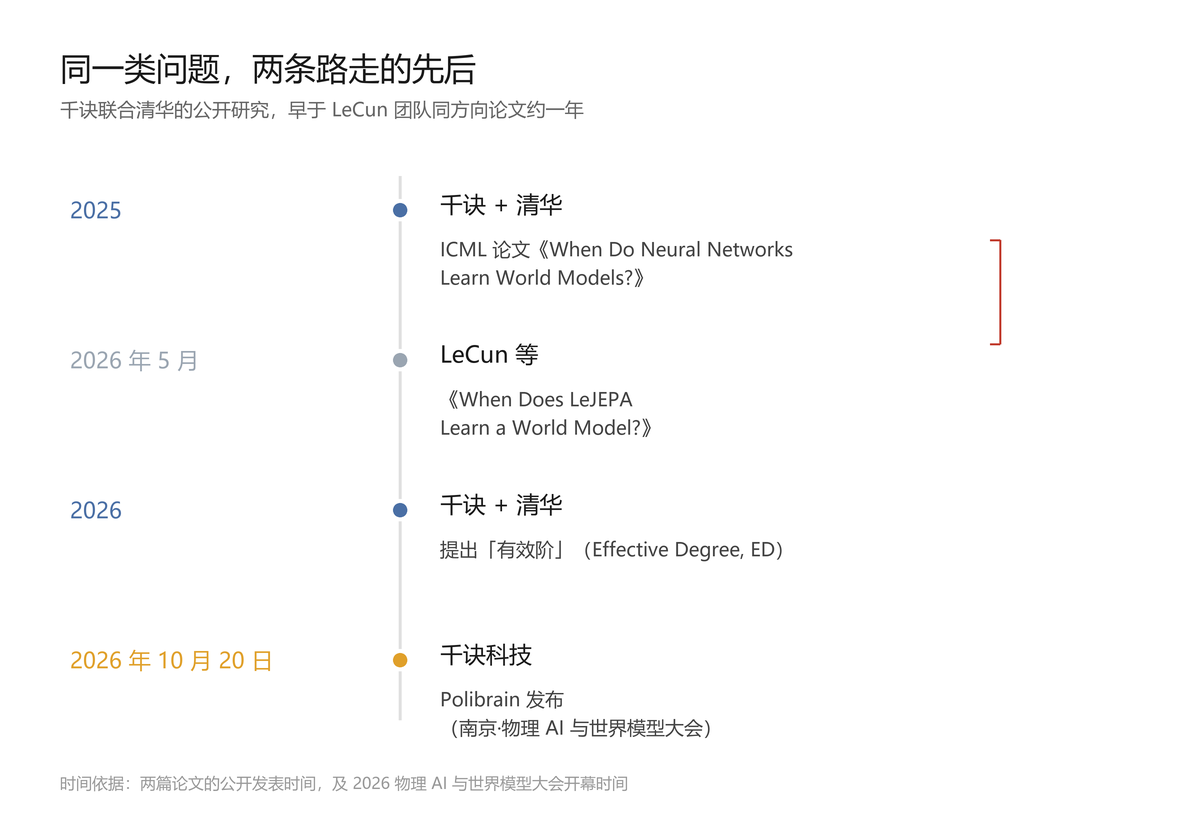
高海川解释了差异:千诀从因果推断和布尔空间的角度提出学习判据,LeCun 团队从时间维度切入。研究对象不同,数学工具不同,但两项研究提出的学习判据具有一定等价性,最终导出的表征在信息层面也具有一定等价性。
【个人看法】"早一年"这个说法,很容易被读成"领先一年",但严格讲只是发表时间早。两篇的数学路径不一样,所谓等价性是作者的说法,我没能力验证。我的理解是:同一个问题,两条路走,一条先公开。这不等于一条比另一条好。
顺便说一句,把"比 LeCun 早一年"当卖点其实挺脆的。论文早晚和产品效果之间,隔的距离比一年长得多。
五、有效阶 ED 和因果记忆
2026 年,千诀联合清华又提出一个指标:有效阶(Effective Degree,ED),想给神经网络的复杂度找一把能算的尺子。
方法说简单点:沿着真实数据点之间的插值路径观察网络,用正交多项式拟合模型输出,再按不同阶次成分的权重算复杂度。低阶成分占主导,ED 小;高阶成分越多、幅度越大,ED 就越高。
传统 Benchmark 只能告诉你模型答得对不对,说不清它学到的函数有多复杂。ED 补的是这一块。理论上还能把这个指标塞进训练过程,让模型少做不必要的复杂变化。
但千诀自己也写了:
【原文数据】"函数更简单,不意味模型一定掌握了正确的物理规律。"
【个人看法】这句是关键。复杂度低和正确性是两件事。一个稳定但一直错着的模型,ED 会很漂亮,可它在犯错这件事上非常一致。所以 ED 是分析工具,不是质量证明。
另一个是因果记忆。机器人把杯子放进柜子,关门就看不见了。下一步要操作这个杯子,它得记得放在哪。千诀做的是基于反事实推断的历史信息筛选:判断某段历史观测会不会影响后续预测和决策,再决定留不留。
不用记住看到的所有画面。背景颜色不重要,杯子进了哪个柜子才影响下一步。
六、泛化这块,问题说得很直接
为什么需要多项式表征?因为泛化。
仓库 A 里学会抓取,换到仓库 B,光照、背景、货架位置一变,表现可能大幅下降。
原因是模型训练时记了大量与任务无关的细节。背景纹理、光照条件、周围摆设,都可能被当成判断依据。这叫特征污染。
还有更隐蔽的一种:模型把经常同时发生的事当成因果。
高海川举的例子是这样:主人出门前从抽屉拿走钥匙。这里有三个事件,主人出门、主人拿走钥匙、抽屉里的钥匙消失。如果模型只学相关性,可能得出"主人出门,抽屉里的钥匙就消失"。等主人真忘带钥匙,让机器人去拿,它会判断钥匙不在抽屉里。
这个例子比多少数据都直观。
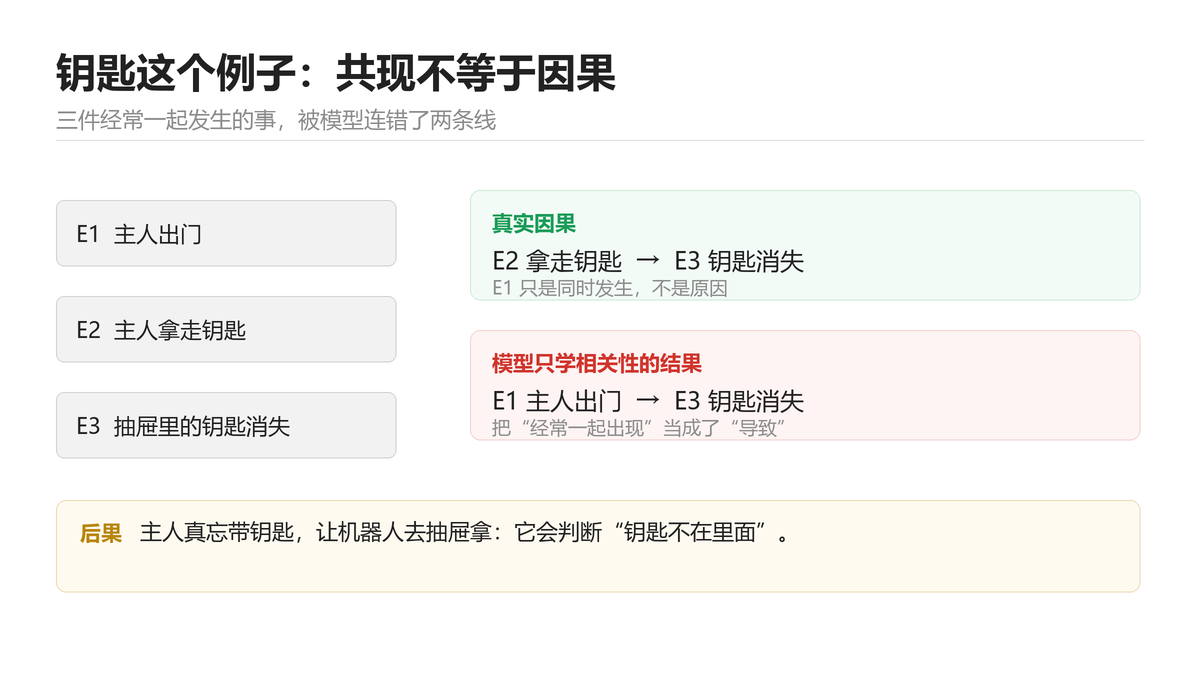
【个人看法】但这恰恰说明识别真实因果有多难。人类一眼看出"钥匙消失"是因为"被拿走",靠的是理解这个动作的物理含义。模型手里只有统计规律。要让它从数据里自己长出这层理解,靠一个判据能不能做到,我不确定。这可能是整个方向最硬的一块骨头。
七、不造机器人,只做大脑
千诀的定位很明确:不造本体,给不同形态的机器人提供智能能力。
技术上的叫法是松耦合架构:把面向环境与任务的共用表征,和具体机器人的动作执行能力分开。对世界的理解共享,怎么执行由各个本体自己决定。
高海川举的例子很清楚。让机器人把衣服放进洗衣机,人形可以一只手拿衣服一只手开门。换成只有一条机械臂的轮式机器人,它可以通过智能家居 IoT 让洗衣机自己开门。
硬件不同,动作不同,落到物理世界的变化却可以一样。
产品形态也跟着变:减一条臂可以是酒店配送,双臂进餐饮,再改结构能做巡检、安保、环卫清洁。
跨本体复用还有一层数据上的算计。
【原文数据】千诀把机器人学习所需的数据分了三层:底层是无本体数据,中层是真机遥操数据,顶层是真实落地应用场景数据。
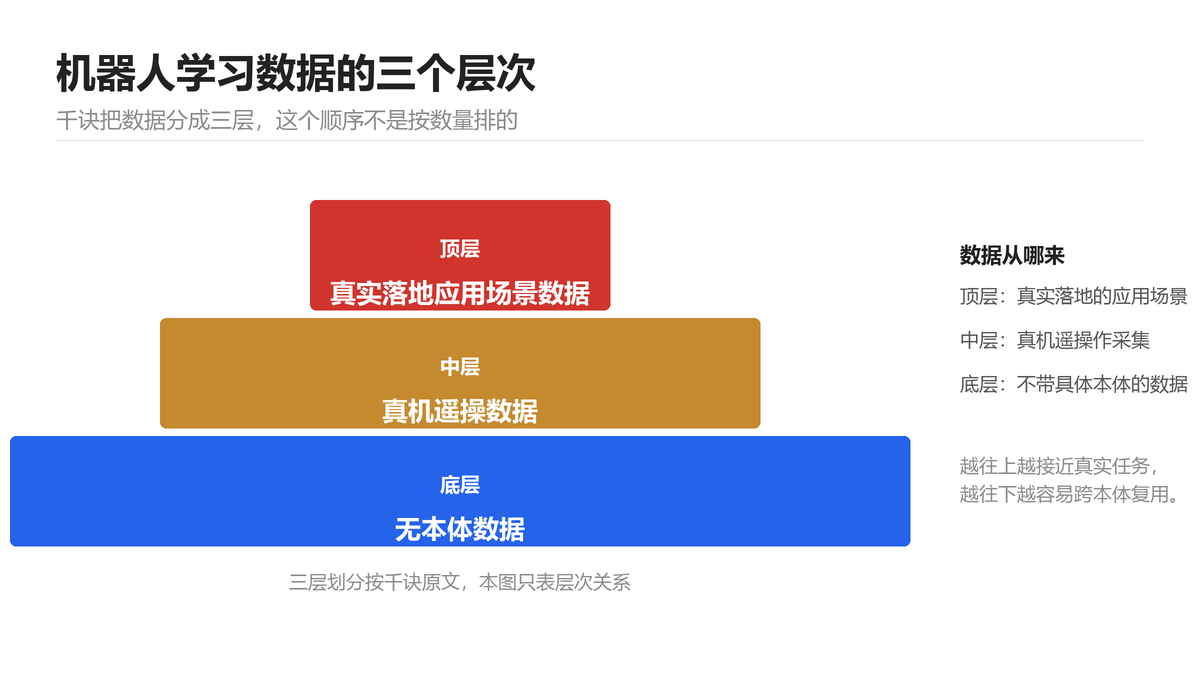
具身智能长期缺物理交互数据。真机采集成本高,积累慢,不同形态的数据又难共享。如果高层表征能共享,不同形态攒的数据就有机会喂同一个模型,形成"更多机器人接入→数据更多→模型更强→吸引更多厂商"的循环。
但这层循环有个前提,高海川自己点破了:各家本体厂商的数据有商业价值,开放共享并不容易。
【个人看法】这是整套逻辑里最难的一环,也是我最不确定的地方。技术上的跨本体复用和商业上的数据共享是两件事。前者论文能证明,后者要谈利益分配。千诀作为独立模型公司去服务不同厂商,能不能真把数据打通,靠的不是技术。
八、能确认的只有三件事
原文的结尾写的是:地图已经有了,但从画出地图,到把那颗荔枝真正送到长安,还有一段长路要走。
【原文数据】另外两处局限也在文中:基础研究提供的是技术依据,实际效果还需要更多真实任务验证;跨本体数据能否真正打通、模型能力能否随应用规模持续提升,都需要更多真实场景验证。
三处局限,都是千诀自己写的。这一点比亮点更值得看。
【个人看法】Polibrain 眼下能确认的事就三件:模型发布了;在四足、人形、轮式、双臂上做了适配;ICML 那篇论文确实早于 LeCun 团队同方向的研究。至于它比生成式路线强多少,原文没给对比数据,我也不打算替它估一个数。
你见过能自己捡垃圾的机器狗吗?评论区说说,我看看是不是只有我在展会视频里见过。