同一批文章,换一种切法,检索命中率差 4 个百分点。这个幅度比很多人预期的小,而真正拉开差距的地方在别处。
我拿 40 篇中文技术文章做了这组测试,总共 67,615 字,平均一篇 1,690 字,用 10 种常见切法各切一遍,然后量三件事:块被从句子中间切断的比例、切片总量相对原文多出来多少重复字符、以及检索时正确的块能不能排到第一。
测试怎么做的
语料是从一个真实站点上抓的已发布文章,正文只保留中文和常用标点,去掉网页标签。切法分四类:固定字数(256 / 512 / 1024)、固定字数加重叠(512 加 10%、512 加 25%、1024 加 25%)、按段落聚合到目标长度(400 / 800)、按句子数量聚合(3 句一块 / 8 句一块)。
检索用的是 BM25,把字符二元组当作词元。中文没有空格,用字符二元组代替分词,好处是不依赖分词库,坏处是对长词的语义不敏感。查询从正文句子里随机截 14 个字,金标准是这句话所在的那一块。
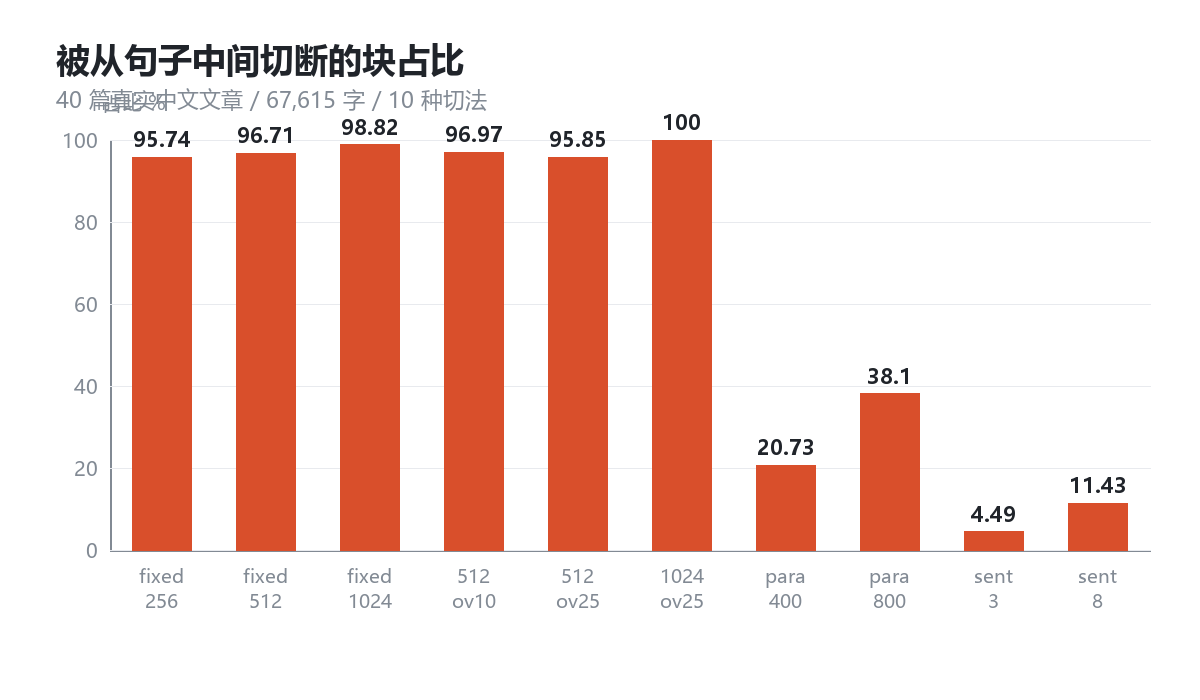
硬切基本都在句子中间下刀
| 切法 | 块数 | 平均长度 | 切断比例 | 碎片比例 | 重复字符 |
|---|---|---|---|---|---|
| fixed_256 | 282 | 239.6 | 95.74% | 3.90% | 0.00% |
| fixed_512 | 152 | 444.7 | 96.71% | 3.95% | 0.00% |
| fixed_1024 | 85 | 795.5 | 98.82% | 2.35% | 0.00% |
| fixed_512_ov10 | 165 | 448.3 | 96.97% | 3.03% | 9.40% |
| fixed_512_ov25 | 193 | 449.4 | 95.85% | 2.59% | 28.27% |
| fixed_1024_ov25 | 108 | 770.8 | 100.00% | 3.70% | 23.11% |
| para_400 | 193 | 350.3 | 20.73% | 2.59% | 0.00% |
| para_800 | 105 | 644.0 | 38.10% | 0.95% | 0.00% |
| sent_3 | 890 | 76.0 | 4.49% | 62.13% | 0.00% |
| sent_8 | 350 | 193.2 | 11.43% | 2.57% | 0.00% |
固定长度那三种,切断比例都在 95% 以上。也就是说你按字数硬切,几乎每一块都断在半句话上,前后两块各缺一半意思。这个数字比我想的极端,尤其是 1024 加 25% 重叠那一档,108 块没有一块落在句号后面。
按段落切的差别一眼能看出来。para_400 的切断比例是 20.73%,只有固定长度那几种的四分之一多一点。段落边界是人写文章时本来就有的停顿,对齐它不花成本。
重叠是拿重复换边界,这笔账不一定划算
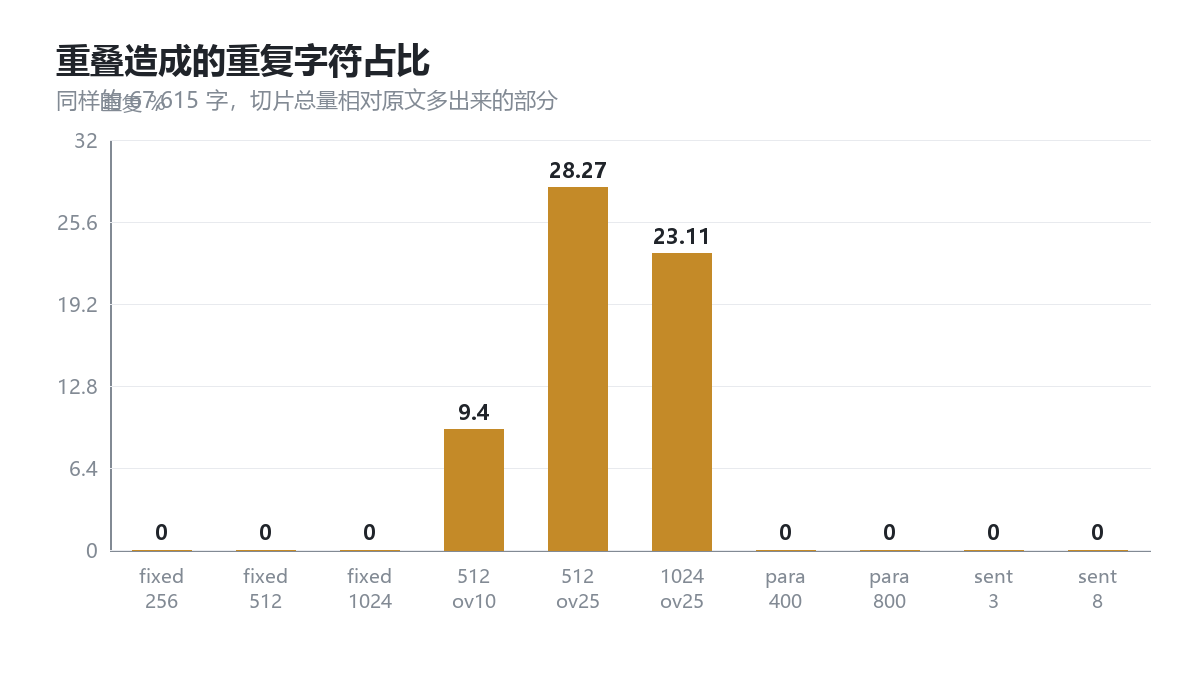
重叠的本意是让上下文别丢。25% 听起来不多,落在字符上是 28.27% 的重复。也就是说库里将近三成的字被存了两遍。
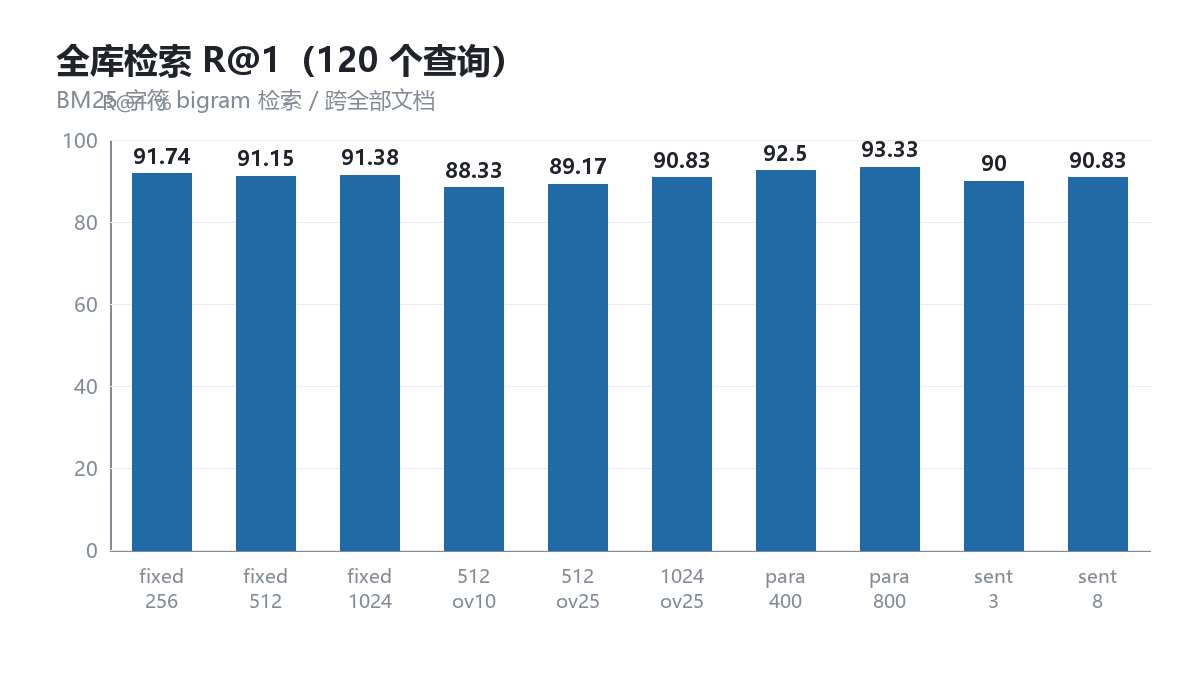
代价付了,收益却没出现。fixed_512 的 R@1 是 91.15%,加了 10% 重叠掉到 88.33%,加 25% 掉到 89.17%。三种固定 512 的切法里,不加重叠的那个反而最好。
我猜原因是重复块挤占榜单。同一段内容在库里出现两三次,BM25 按词频打分,长得几乎一样的几块会一起被捞出来,把别的候选挤到后面。你花了三成存储和索引成本,换来的是自己的结果互相打架。
按段落切的那一档排第一
全库检索的结果如下,120 个查询,候选池是全部块而不是限定在同一篇文章里,所以这个数字是有区分度的。
| 切法 | 块数 | R@1 | R@3 | R@5 |
|---|---|---|---|---|
| fixed_256 | 282 | 91.74% | 92.66% | 96.33% |
| fixed_512 | 152 | 91.15% | 96.46% | 97.35% |
| fixed_1024 | 85 | 91.38% | 93.97% | 95.69% |
| fixed_512_ov10 | 165 | 88.33% | 92.50% | 94.17% |
| fixed_512_ov25 | 193 | 89.17% | 95.00% | 97.50% |
| fixed_1024_ov25 | 108 | 90.83% | 95.00% | 97.50% |
| para_400 | 193 | 92.50% | 95.83% | 98.33% |
| para_800 | 105 | 93.33% | 96.67% | 97.50% |
| sent_3 | 890 | 90.00% | 92.50% | 95.00% |
| sent_8 | 350 | 90.83% | 94.17% | 94.17% |
para_800 的 R@1 是 93.33%,最高。它只有 105 块,平均 644 字,碎片率 0.95%,是唯一在结构指标和检索指标上都靠前的切法。
sent_3 值得单独说。它切断比例只有 4.49%,看着最完整,但切出 890 块,平均 76 字,62.13% 的块不到 80 字,等于大半是碎片。890 块意味着 890 次向量化和存储,检索时要扫的候选也多。R@1 是 90.00%,比 para_800 低三个多点。
sent_8 是结构上最均衡的一个,350 块,平均 193 字,切断 11.43%,碎片 2.57%,R@1 90.83%。
四个点撑不起一次重构
把 R@3 也看一遍,10 种切法全落在 92.50% 到 96.67% 之间。R@5 是 94.17% 到 98.33%。最好的和最差的差 3.5 到 4 个百分点。
这个幅度值得知道,但不足以支撑结论说分块是第一优先级。在纯词法检索这套设定下,分块方式对命中率的影响是有限的。真正贵的部分是前面的嵌入和后面的生成,块切得再好也只是把候选送到门口。
需要说明我这组测试的边界。语料只有 40 篇同一个站点、同一个题材域的文章,块数最多 890,规模不大。检索用的是词法匹配,没有做向量检索,而分块对向量检索的影响通常比词法大,这一块我没有测。查询是从原文里截的连续片段,属于偏简单的词法题,真正用户提问会更模糊,那部分难度没被覆盖。
要在你自己的语料上做决定,有个更省事的办法:先按段落切,跑一遍你手上真实的 50 个问题,看命中排第几。段落切法几乎不花成本,先把这个基线立住,再决定要不要为重叠付那三成存储。至于固定字数加大量重叠这种组合,从这次数据看,它同时付出了重复成本和切断成本,两边都没换到。