一个我先没想通的问题
上一篇文章里,我把站点 10 天的访问日志拆开算了一遍。AI 公司的爬虫总共来了 1,837 次,占全部请求的 6.1%。
数字本身没什么。真正让我停下来的是另一组:这些爬虫到底抓到了什么。
Anthropic 的 ClaudeBot 来了 472 次。其中读 robots.txt 143 次,读 sitemap.xml 126 次。两个加起来占它全部请求的 57%。
剩下那 43% 里,抓标签页 28%,抓文章正文 8%。
8%。它来了一趟,只有八个百分点的时间花在内容上。
这不是它的问题,是我的站的配置问题。这篇就把这事说清楚。
先把三种“爬到文章”的路说清楚
AI 公司要拿一个站的内容,正常的顺序是这样:
先读 `robots.txt`,看站主允许哪些路径、禁止哪些。再读 `sitemap.xml`,拿到全站页面的清单。然后按清单一个个抓。
这三步的顺序很重要。robots.txt 和 sitemap 是给爬虫看的地图。地图画得不好,爬虫就会自己去猜。
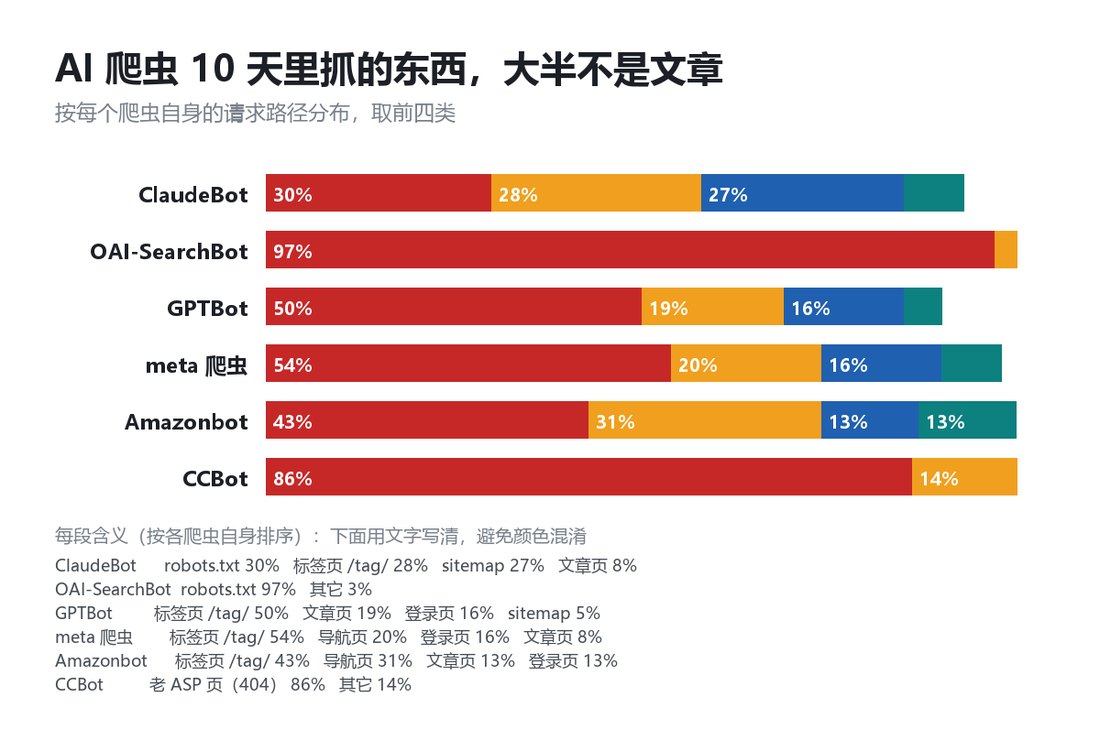
我这份日志里,能清楚看到“读地图”和“抓内容”的分布:
一行一行拆:
ClaudeBot:robots 30%,标签页 28%,sitemap 27%,文章页 8%。
OAI-SearchBot(OpenAI 的检索爬虫):29 次请求里,28 次是读 robots.txt。97%。它几乎什么都没抓。
GPTBot(OpenAI 的训练爬虫):标签页 50%,文章页 19%,登录页 16%,sitemap 5%。
meta-externalagent:标签页 54%,导航页 20%,登录页 16%,文章页 8%。
Amazonbot:标签页 43%,导航页 31%,文章页 13%,登录页 13%。
CCBot(Common Crawl,很多开源数据集的上游):86% 抓的是 `/Detail/...` 这类老 ASP 路径。
那个 86% 的数字是个明显的错误
CCBot 那 121 次请求,我一开始以为是站内某个分类页。
查了才知道,`/Detail/` 这个路径在我这个站上根本不存在,全部返回 404。
它为什么要抓一个不存在的路径?
我的推测(只是推测,日志证明不了):CCBot 手上有这个域名的旧索引。这个域名以前可能挂过别的程序,那套程序的路由是 `/Detail/xxxx` 格式。Common Crawl 的数据集里存着这些旧 URL,它按旧清单来抓,抓到的全是 404。
类似的情况在 bingbot 那边也有:`/gov/content/1017.Htm` 被抓了 39 次,也是 404。
这件事有个实际后果。CCBot 是很多开源训练数据集的来源,如果一个域名在它库里长期是“抓不到东西”,抓取优先级可能就会降下去。这一条我没有证据,是从抓取行为倒推的猜测。
为什么它们抓了那么多标签页
GPTBot 一半时间在 `/tag/` 上,meta 是 54%,Amazon 43%。
标签页是我这个站自动生成的聚合页,按关键词把文章聚在一起,比如 `/tag/AI/`。这类页面链接密度高,一个页面能通向几十篇文章,从爬虫角度看是最省事的入口。
问题在于,我的站点没有为这些标签页单独做索引控制。它们既在 sitemap 里,又互相链来链去,对爬虫来说像个迷宫入口,一头扎进去出不来。
我这个站的 `/tag/` 还有另一个麻烦:纯标签首页 `/tag/` 这个路径本身不存在,返回 404,但爬虫一直在抓(10 天 565 次,主要是 Majestic)。
10 天里每天的量,波动不小
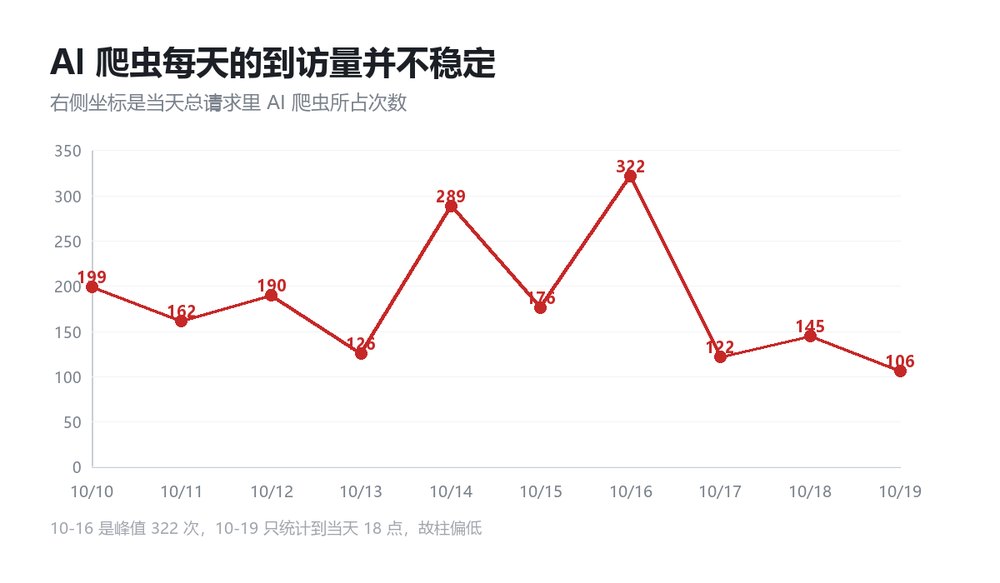
199、162、190、126、289、176、322、122、145、106。
最高 322(10 月 16 日),最低 106(10 月 19 日,只统计到当天下午)。
这个波动我没找到明确原因。站点内容量、发布时间、外部链接变化都会影响,但我没有逐日对照发布记录去验证,所以只能说看到波动,不解释成因。
一个反直觉的结论
写之前我以为会看到“AI 疯狂抓取内容”的景象。
实际是:这些爬虫大部分时间在反复读 robots.txt、反复读 sitemap、反复抓标签页和 404 路径,真正落到文章正文的比例很低。
按我这份日志的粗算,1,837 次 AI 爬虫请求里,能确认落在文章页的大概一百多次。
原因我列了两条,都有日志支撑:
一是 sitemap 可能没被充分利用。 只有 ClaudeBot(126 次)和 GPTBot(10 次)读过 sitemap.xml。Bytespider、meta、Amazonbot 一次都没读过。它们全靠自己从首页爬链接。
二是文章页的入口太浅。 文章页在 sitemap 里、在分类页里、在标签页里都出现,但爬虫优先走的是链接最密的那一层,也就是标签页和导航页。
这两条都能修。修法我在下一篇里写。
我不太确定的部分
有个事我没法从日志判断:这些爬虫抓到内容之后,到底进没进训练集、有没有影响最终的模型输出。
日志只能证明“它来了、它读了哪些地址”。读了之后怎么用,我看不到。
所以看到有人说“我的文章被 AI 抄了”,我现在的态度是:能被抓取是事实,被抓取之后发生了什么,是另一件事。 这两件事经常被混在一起讲。
你要是也在管一个站,可以去翻一下日志里 `robots.txt` 和 `sitemap.xml` 被谁读过。
读完可能会像我一样,发现大部分爬虫压根没拿到你的文章清单。