我数这个,是因为账单只按 token 收
上个月我开始在这个站写稿。写到第六篇的时候突然想到一个问题:这些字,模型是按什么单位计费的。
报价单上写的是「每百万 token」。不是每千字,也不是每个汉字。
那我就得先知道,一千个汉字到底等于多少 token。
网上的说法我见过至少三种,一比一的,一比一点五的,还有说中文天生比英文贵的。我不想凭印象写,就把分词器装上,能数的都数了一遍。
先说清楚范围:我数的是 OpenAI 公开的两个分词器,cl100k_base 和 o200k_base。DeepSeek、通义、文心这些国内模型的分词器没有公开下载,我拿不到,所以下面这些数字不能直接套到它们头上。这一点后面还会再说一次。
怎么数的
两个来源。
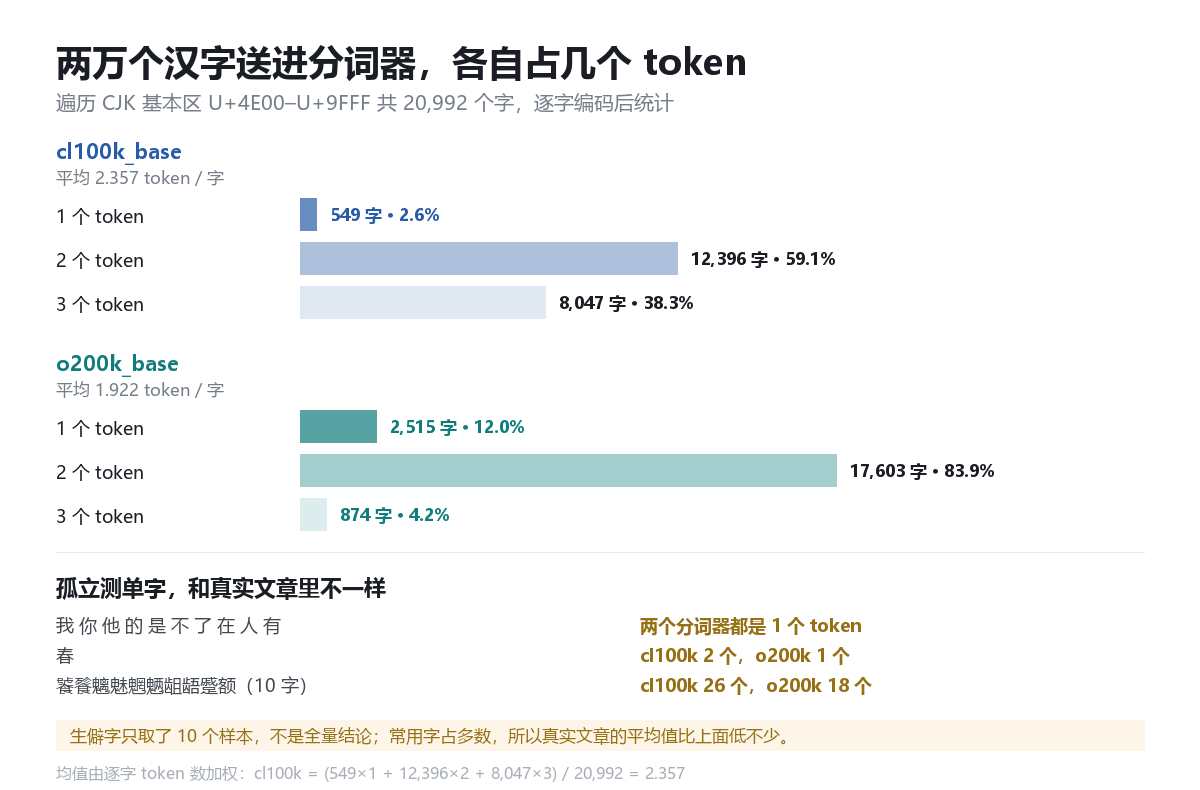
一个是逐字遍历。汉字的基本区是 U+4E00 到 U+9FFF,一共 20,992 个。我把每一个字单独送进分词器,看它占几个 token,再统计分布。
另一个是真实文本。这个站上我自己写的六篇稿子,10,287 个汉字,整篇送进去数。
工具是 Python 加 tiktoken 0.14.0。两个都是 OpenAI 开源的,本地就能跑,不联网也能量。
结果一:能压进一个 token 的汉字,很少
cl100k_base 里,20,992 个汉字中只有 549 个是单 token,占 2.6%。
剩下的是 2 个 token 的 12,396 个,3 个 token 的 8,047 个。加权平均下来,一个字 2.357 个 token。
o200k_base 好一些。单 token 的有 2,515 个,占 12.0%,平均 1.922。
这个数字容易被误读,得停一下。
2.357 是孤立测单字的结果。单字没有上下文,模型没法把它和相邻的字合成一个词。真实文章里常用字占绝对多数,实际值会低不少。后面你会看到,是 1.575。
我一开始就是被这个 2.357 带偏的,按它去估整篇文章的 token,估高了快一半。
为什么会拆成好几块
拿「近视防控镜片」这六个字试。
cl100k 给出 9 个 token,o200k 给出 6 个。
差在哪?我把 id 逐个解码看了。cl100k 那 9 个里面,有 6 个解码出来是乱码符号。它们不是完整的字,只是一个字的某一部分。
这就是字节级的 BPE。词表里没有这个字,就退化成按字节切。一个汉字的 UTF-8 编码是三个字节,所以最多被切成三块。
o200k 那边,六个字各占一个 token,没有碎片。
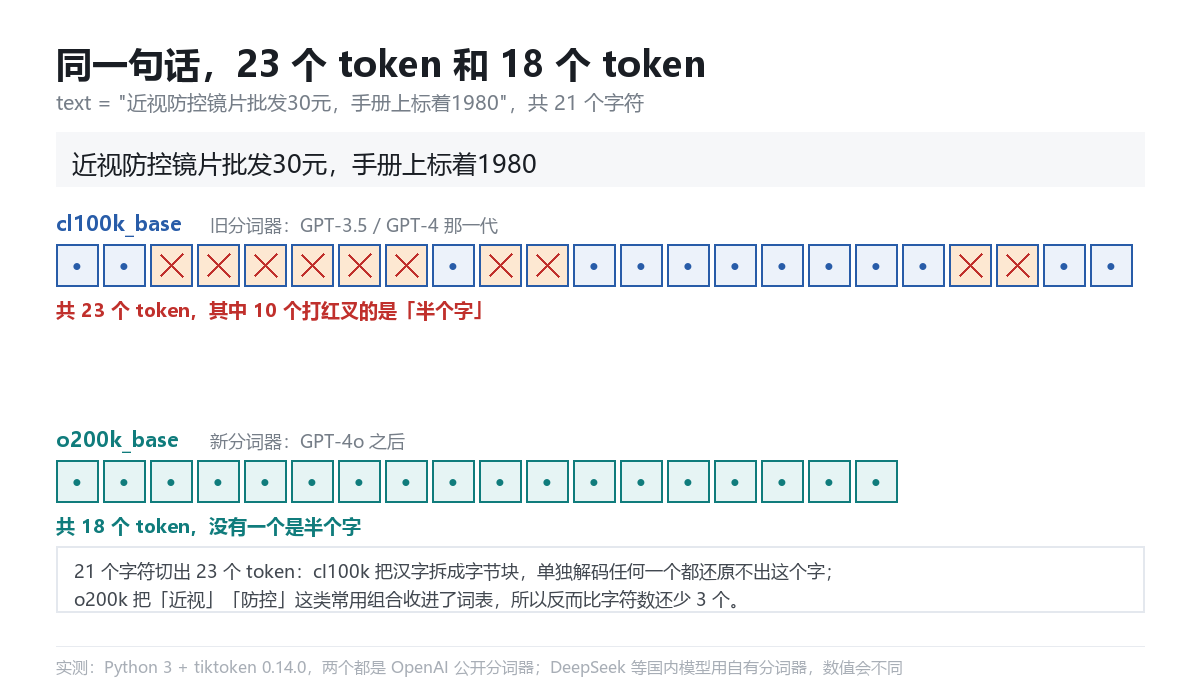
然后是整句。「近视防控镜片批发30元,手册上标着1980」,21 个字符:
cl100k:23 个 token,其中 10 个是半个字
o200k:18 个 token,一个碎片都没有
注意后者比字符数还少三个。因为「近视」「防控」这种常用组合被收进词表了,两三个字算一个 token。
那么真实文章里是多少
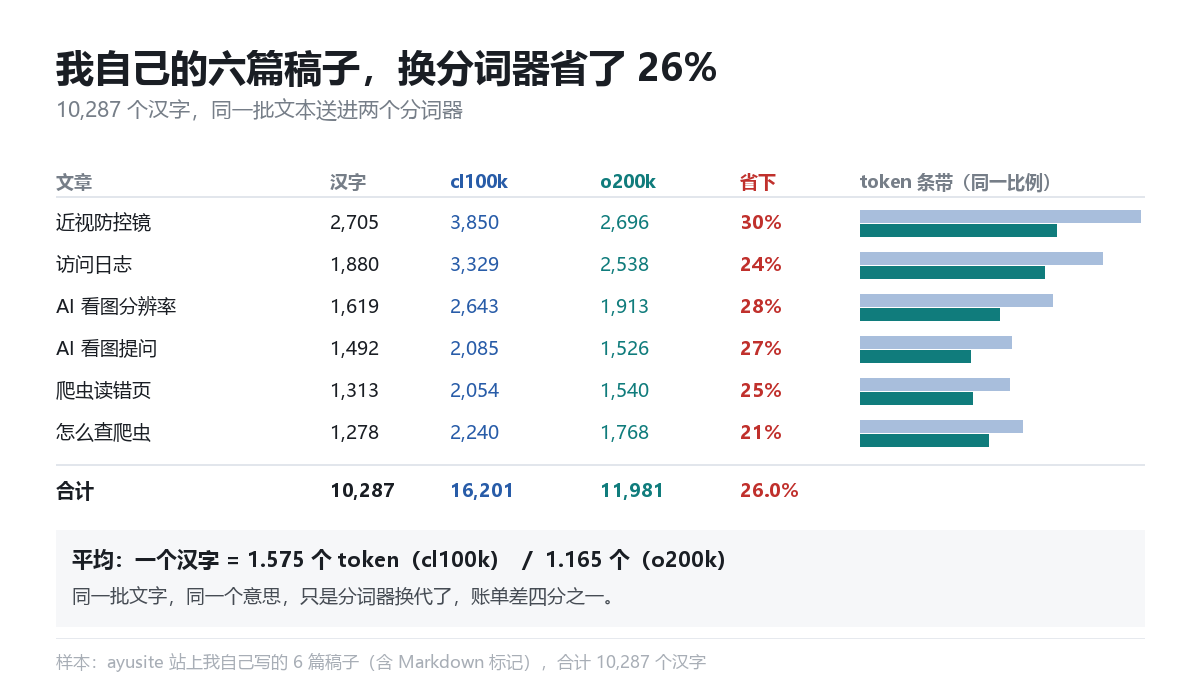
同样六篇,10,287 个汉字。
cl100k 数出 16,201 个 token。o200k 数出 11,981 个。
换一个分词器,省 26%。
平均下来,一个汉字 1.575 个 token(cl100k),1.165 个(o200k)。
还有个数字我觉得挺说明问题。我把六篇全扫了一遍,cl100k 那 16,201 个 token 里,有 4,975 个是「半个字」,占 30.7%。o200k 是 387 个,3.2%。
将近三分之一的 token,只是某个字的残片。
这个比例我自己看到的时候有点意外。之前一直以为中文的问题是「字太多」,实际是「字被切碎了」。
换成窗口和钱
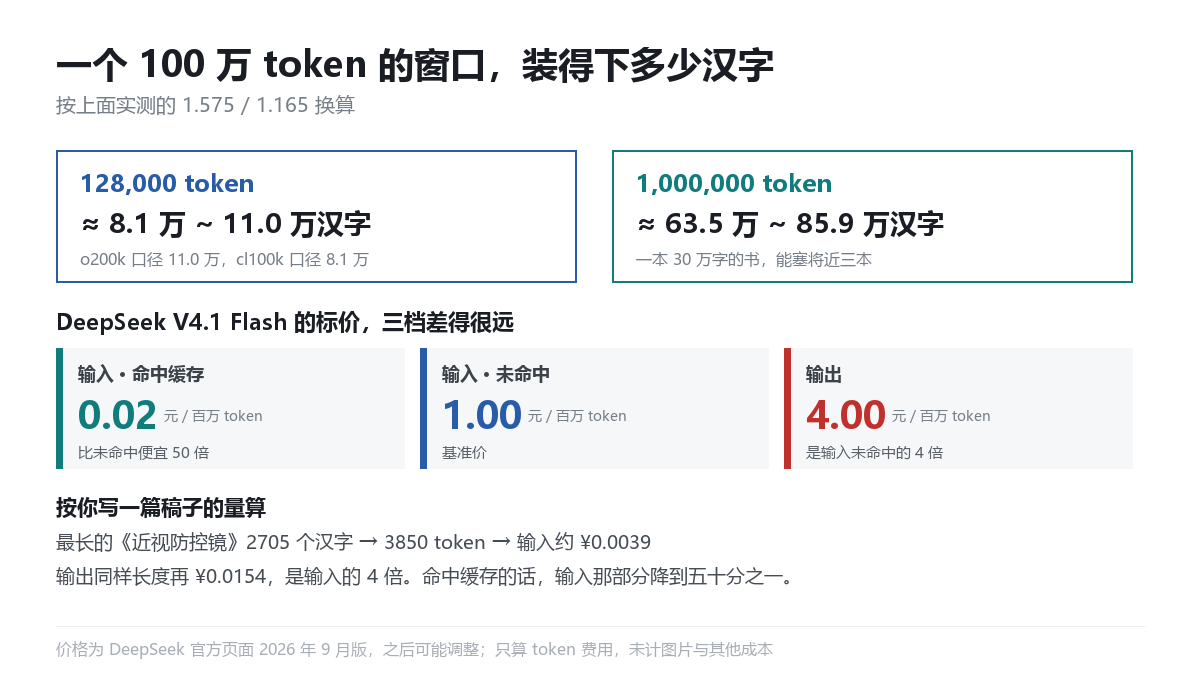
128K 的窗口,按上面的均值,能装 8.1 万到 11 万个汉字。
1M 的窗口,63 万到 86 万。
一本 30 万字的书,1M 的窗口能塞将近三本。
价格我查的是 DeepSeek V4.1 Flash 官网标的三档:输入命中缓存 0.02,输入未命中 1.00,输出 4.00,单位都是元每百万 token。
这个价是 2026 年 9 月页面上的,之后改了我不知道。另外我只查了标价,没有实际调用过它的接口,所以「命中缓存」具体在什么条件下触发,我说不准。
按最长那篇算,2,705 个汉字,3,850 个 token,输入四厘不到;让它输出同样长度,一分五。
一篇文章几分钱。这个量级,单看一篇的话,成本几乎可以不管。
真正让账单变难看的在别处。同一份长文档你反复发多少遍,你让模型吐多少字,这两件事比「中文是不是比英文贵」重要得多。
几个我没搞定的地方
一,国内模型的分词器我拿不到。
DeepSeek、通义、文心的分词器有没有公开版本,我没查到。所以上面所有数字对它们的适用性,我只能说「量级接近」,给不出准数。这条从开头憋到现在,就是怕有人拿 1.575 去乘国产模型的账单。
二,cl100k 不「落后」。
它的词表是 100,277 个,o200k 是 200,019 个。词表大,同样的文本能合并出更多组合,token 数就少。这是设计取舍,不是谁好谁坏。词表大意味着每次预测要在更多候选里比,那是另一笔账。
后半句是我自己的推测,没有验证。
三,样本只有六篇。
都是我一个人写的,风格接近,主题也都在同一类。换个人、换个领域,比值会动。1.575 这个数我当成参考值,不当标准值。
四,生僻字那组只测了十个字。
「饕餮魑魅魍魉龃龉蹙额」,cl100k 26 个 token,o200k 18 个。十个字说明不了全貌,只是给个手感。真要给结论,得把整个扩展区都跑一遍,那又是两万多个字。
最后
如果你只是想粗估成本,记一个数就够:中文一千字,按 1,500 到 1,600 个 token 算。
误差不会太离谱,但也别拿它去对账。
要更准,还是得自己数。下一篇我写了怎么装、怎么跑、怎么把 token 换算成钱,命令都是本机跑通的。