更小的那个,把更大的顶掉了
DeepSeek 把更大的 V4 Pro 换了下去,顶上来的是更小的 V4.1 Flash。
这事发生在 2026 年 9 月 10 日。V4.1 Flash 是这家公司全新模型结构系列里最小的一个,552B 参数的 MoE。而被它顶掉的上一代旗舰 V4 Pro,骨干参数是 1.6T。
一个 5520 亿的模型,替掉了一个 1.6 万亿的模型。
它原生支持图像和文本,上下文最长 100 万 token,权重按 MIT 协议挂在 HuggingFace 上,另配了一份技术报告。
名字里带 Flash,按惯例理解就是更轻、更便宜、更快的那一档。结构也真换了,40 层 Transformer 里,前 20 层是因果编码器,后 20 层是解码器。
输入阶段每个 token 只激活 8B 参数,输出阶段激活 16B。两头不一样重,官方管这个叫非对称。
每层 MoE 有 1 个共享专家加 384 个路由专家,每个 token 只叫醒其中 6 个。
另外两处细节值得记一下:Engram 条件记忆 196B 参数,按 token 查表稀疏访问;解码端用 DSpark 推测解码。视觉部分用自研的 DeepSeek-ViT 编码器,再接两层 MLP 投影。
V4 Pro 没出事故,也没被砍功能。官方给的理由很直接:多方测下来,V4.1 Flash 在性能、费用、速度、总用时上全面超过它。
训练是从零开始的,多模态语料 45T tokens。稀疏注意力先在 64K 序列长度上训,到 34T tokens 时把上下文拉到 100 万。
结构上的交代就这些。
890 字节,才是这次公告的正题
真正该看的数字不在参数量那一栏。
每 token 的全局 KV 缓存,现在降到 890 字节。上一代 V4-Flash 是 3514 字节,中间的 V3.2 是 48068 字节,初代 V1 是 389120 字节。三个旧数字摆在一起,下滑的坡度很清楚。
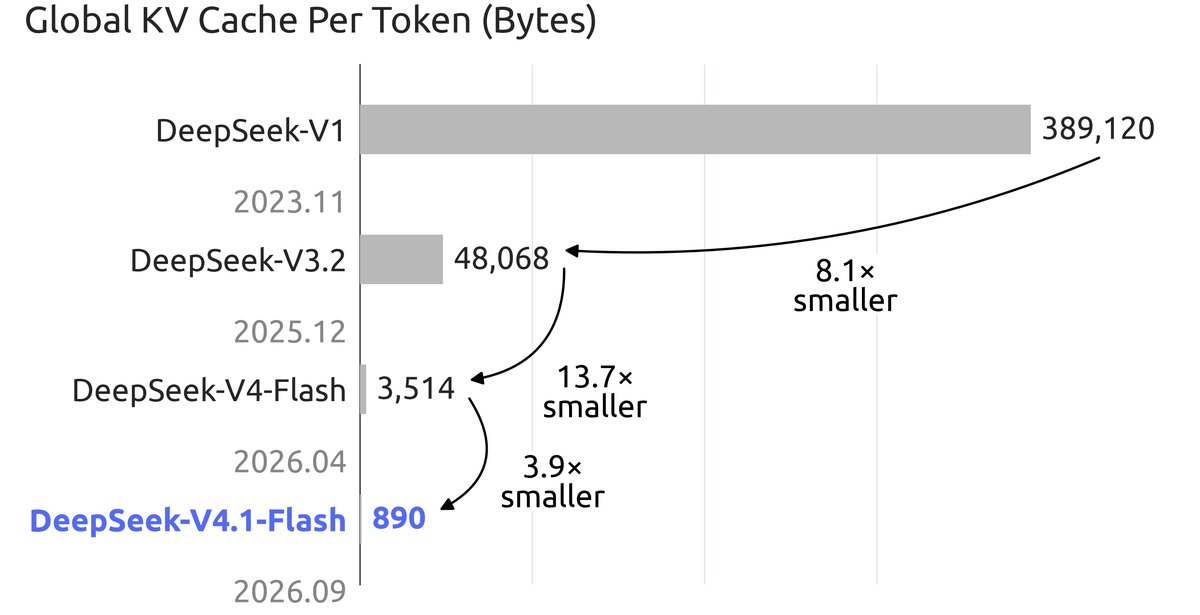
可以把 KV 缓存想成模型跑起来必须随身扛的行李。它不参与算数,但每走一步都得背着,对话越长越重。行李越重,显存和硬盘越紧,一台机器能同时招呼的请求就越少。从初代算到现在,这个包袱缩了 437 倍,相对上一代约四分之一,对 HBM 的需求降到四分之一,对 SSD 的需求降到八分之一。
办法是两件事。一件叫 SWA Bounded Replay,只重放最近 n_win 个 token,不必把 SWA 的 KV 落到 SSD;另一件叫 CSA2 压缩稀疏注意力,每层在 Full、Reindex、Reuse 三种静态模式里挑一种,跨层共享 KV,主缓存用 FP4。
官方自己点了用处:Agent 场景里,缓存命中的费用往往占大头,压 KV 缓存等于直接砍 Agent 类的成本。
这也是理解这次换代的关键。参数量决定的是模型脑子里能装多少东西,KV 缓存决定的是它跑起来要占多少地方。这一次动的是后者。
它赢的地方,赢得很硬
硬指标上,它赢的地方很硬,而且赢的全是有标准答案的那类题。
终端任务这一栏差得最大。Terminal-Bench 3.0 上它拿 30.0,V4-Pro 只有 11.8;到 4.0 版本,它是 31.2,V4-Pro 是 12.4。同一套题,换一代模型,分数翻了一倍多。
写代码的 DeepSWE v1.1 是 74.2,V4-Pro 62.7。Codeforces 分数 3471,V4-Pro 3348。老一点的 2.1 版本,它是 90.6,V4-Pro 87.9。
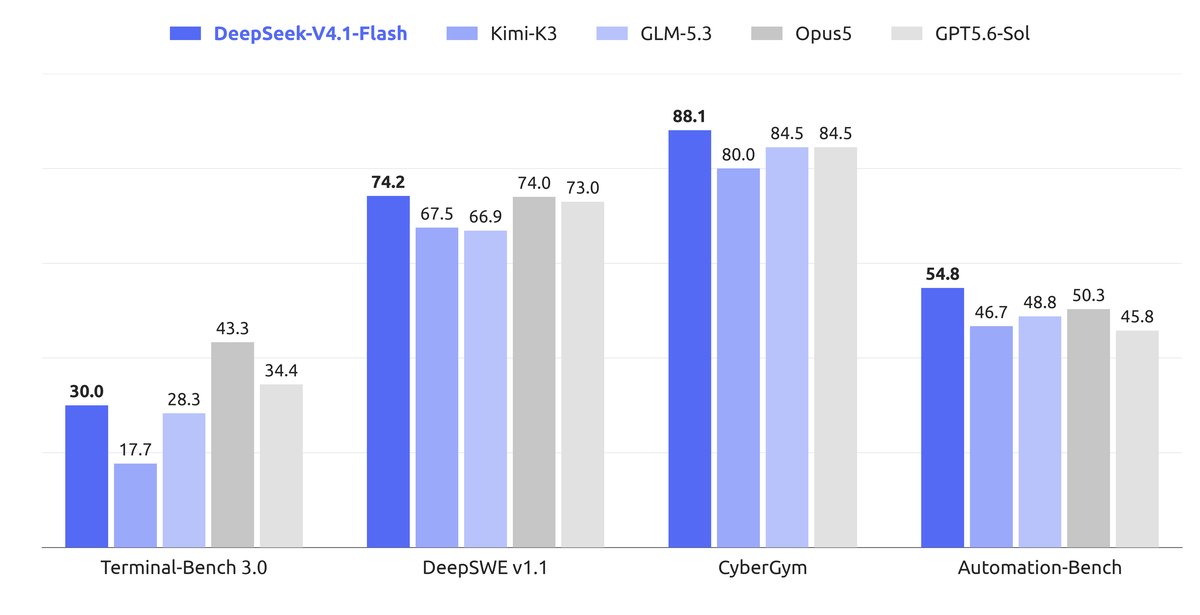
这几栏里它都没有掉队。差距最大的,反而出现在最新的那套题上。
这些题不聊天。它们逼模型在终端里真开命令、真改代码、真把一段任务从头跑完。
跑通就是跑通,跑不通就是跑不通。没有中间地带。
基座模型榜单上还有几项它反超了更大的 V4-Pro:MMLU-Pro 74.1 对 73.5,HumanEval 79.4 对 76.8,BigCodeBench 60.6 对 59.2,GSM8K 93.0 对 92.6。这些名字都不太好记,共同点是它们都有标准答案。
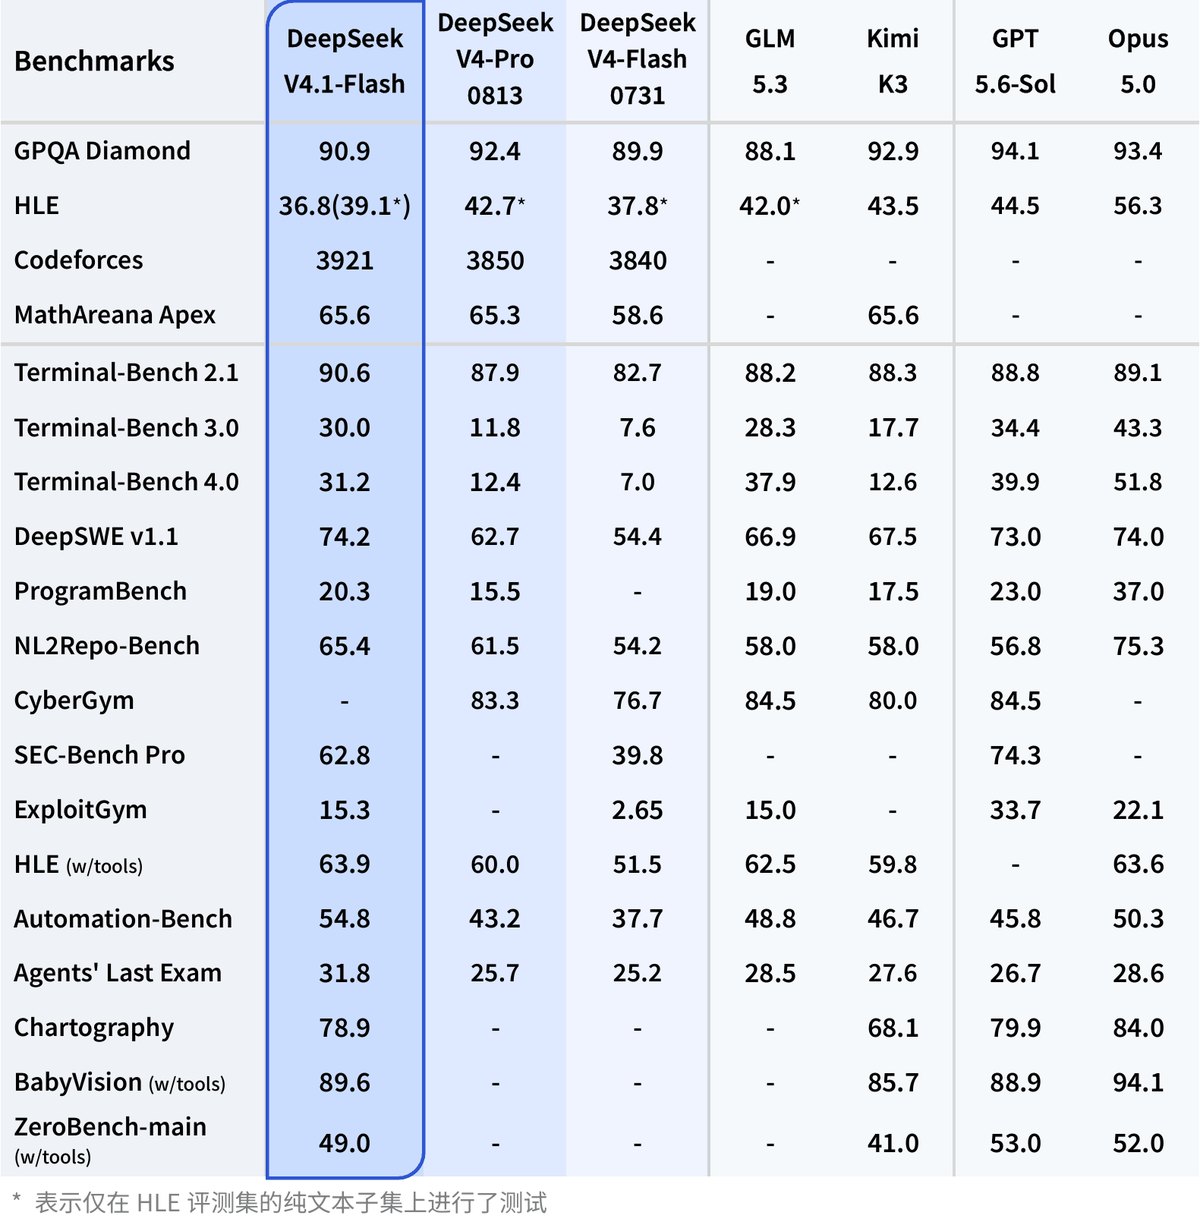
其他几项成绩也一并给了出来:CyberGym 88.1、HLE w/ tools 63.9、AutomationBench 54.8、Agent's Last Exam 31.8。
口径写得很清楚,全部取最强推理强度。
验收方式决定了这一切。上面这些题,要么有标准答案,要么有环境能自动判分,做对就是做对,做错就是做错。一个模型不需要懂全世界,只要在能被打分的地方每一步不出错,它就够用。
输的那几项,也写在表上
短板也写在官方表格里,一行都没藏。
SimpleQA-Verified 42.3,V4-Pro 是 55.2;MultiLoKo 45.5 对 50.9;MATH 61.1 对 64.5;LongBench-V2 45.2 对 51.5。
四行数字,量的是四种完全不同的能力。
翻成口语:世界知识、多语、纯数学、长文本理解这四项,它不如比自己大一档的 V4-Pro。
这项差距不难理解。它的强项集中在有环境、有反馈、能自动判分的任务上,写代码、跑终端、走 agent 流程都属于这一类。碰上要靠脑子里存着大量事实的问题,或者要在许多语言之间来回切换,或者要读完一整本长文档再回答,参数量的差距就露出来了。
它没被训练成万事通。它被训练成一台干活的机器。
这不是遮掩得住的差距,表格就摆在那里。所以严格说,这不是「小模型全面超越大模型」,而是「在需要动手的活上,小的比大的好用,而且便宜得多」。
名字还留着,账单换了
价格也跟着变了,而且分时段。
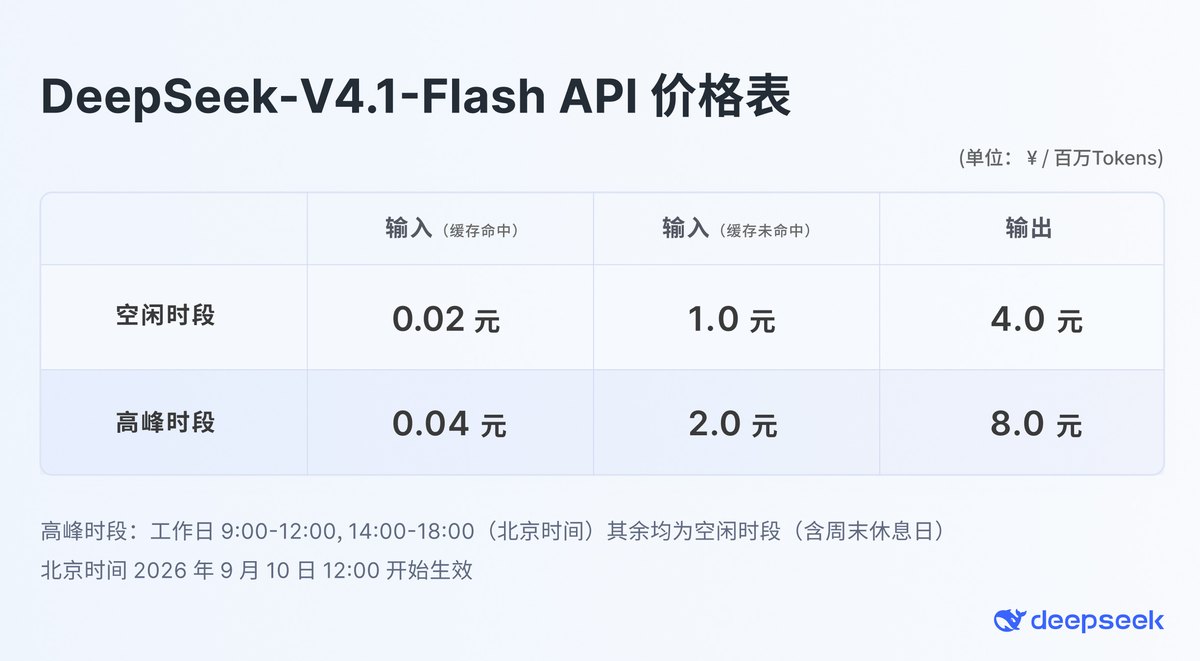
人民币每百万 tokens,空闲时段缓存命中 0.02 元,未命中 1.0 元,输出 4.0 元。
高峰时段翻倍:命中 0.04 元,未命中 2.0 元,输出 8.0 元。
高峰只算工作日 9:00 到 12:00、14:00 到 18:00,其余都算空闲,周末和休息日整天都算。新价格从 9 月 10 日 12:00 起生效。
API 里模型名改成 deepseek-flash 就能调。旧的 V4 Flash、V4 Flash Vision Exp 已经下线,旧模型名会暂时路由到 V4.1 Flash,调用方不用改代码。
北京时间 9 月 14 日 12:00 之后,直到 V4.1 Pro 上线之前,访问 deepseek-v4-pro 的请求全部转到 V4.1 Flash,并按 V4.1 Flash 的单价计费。
名字还留着,账单已经换了。
中间留了一段缓冲期,旧名字不会被一刀切断,对接方基本不用做什么动作。
合作伙伴 WorkBuddy 含 CodeBuddy、OpenCode 已全量接入,官方也说要支持开源社区做推理适配。有大规模部署需求的,两千卡 GPU 加存储集群,可以直接找他们。
更大的模型被更小的模型顶掉,原因不是它变笨了。
是算账的方式变了。