56 像素宽的图,AI 说它像昆虫。
这句话不是我编的。原话是:「这张照片因严重模糊、失焦和像素化,无法准确辨认主体,看起来像是某种昆虫、植物碎屑或生锈金属物体的模糊特写。」
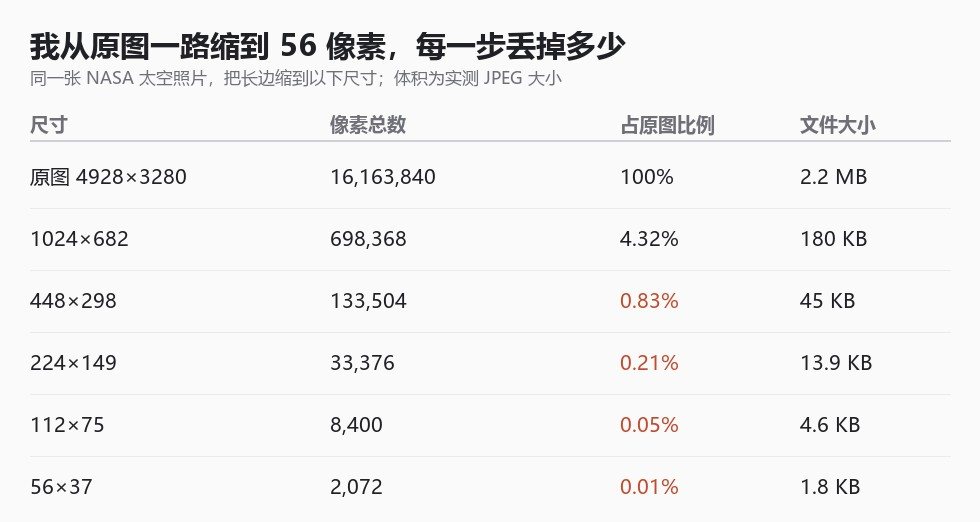
原图是 NASA 在国际空间站拍的夜间地球,4928×3280,2.2MB。同一张图,同一个模型,同一个问题。我只改了尺寸。
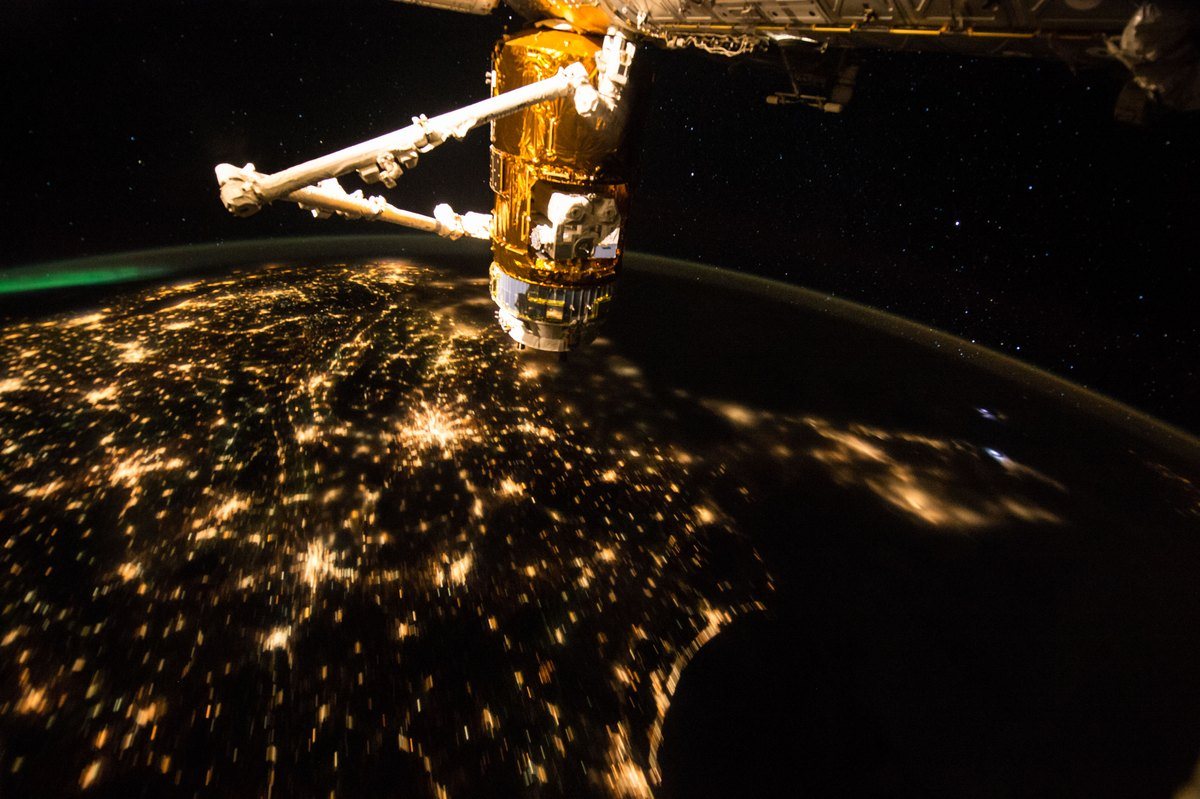
从「空间站舱段及机械臂,背景是地球夜间城市灯光与极光」到「像昆虫」,中间隔着五档分辨率。
一张 1616 万像素的照片,模型真正用到的只有 0.31%。
第一步是缩小,缩完只剩 0.31%
模型不读原图。4928 乘 3280 是 16,163,840 个像素点,一个点三个数,红绿蓝,加起来 48,491,520 个数。
它读不了这么多。
常规做法是先缩到一个固定尺寸,比如 224×224。算下来 50,176 个像素。原图 99.7% 的像素,在进入模型之前就没了。
224 这个数字不是随便挑的。16 乘 14 正好 224,切得整整齐齐,不留边角;换一个尺寸就要处理切不尽的余数。google/vit-base-patch16-224 和 openai/clip-vit-base-patch32 这两套官方权重,默认输入也都是 224 见方。
副作用是比例。多数视觉编码器要的是正方形输入,一张 3:2 的横图进去之前还得处理一遍,常见两种做法,要么拉伸,要么先缩再居中裁掉两边。你看到的构图,和它拿到的构图,本来就不是同一张。
文件大小在这件事上没有意义。
2.2MB 还是 22MB,进模型前一样变成 224。手机相册里那些标着「高清原图」的照片,对模型来说跟缩略图没有区别。
那为什么不干脆按原图切块。我算过:按 16×16 切,这张图会得到 308 行 205 列,也就是 63,140 块。token 数量是 196 块那一版的 322 倍,而注意力要两两比较,平方之后更夸张。没有哪家模型愿意为一张照片付这个账。
缩完还要切成小方块
224×224 也不是整块塞进去。ViT 那篇论文把做法写在了标题上:《An Image is Worth 16x16 Words》。它把图当成一句话来读,一块 patch 就是一个词。
切多大,各家不一样。google/vit-base-patch16-224,块是 16×16,224 的输入正好切 14 乘 14,196 块。openai/clip-vit-base-patch32 块是 32×32,切出 7 乘 7,49 块。LLaVA 的配置里 image_seq_length 是 576,配的视觉塔是 CLIP-ViT-L-336,336 除以 14 等于 24,24 乘 24 正好 576。
块切得越小,词就越多,细节留得越细,算力也越贵。块切得越大,词少,快,代价是每个词都被磨成一片模糊的平均色。196 和 49 的差别,本质就是这个买卖的不同出价。
一块 16×16 的 patch 装 768 个数。196 块乘起来,150,528 个数。
这个数字眼熟吗。224 乘 224 乘 3 就是 150,528。一分没多,一分没少。
这是算术,不是比喻。
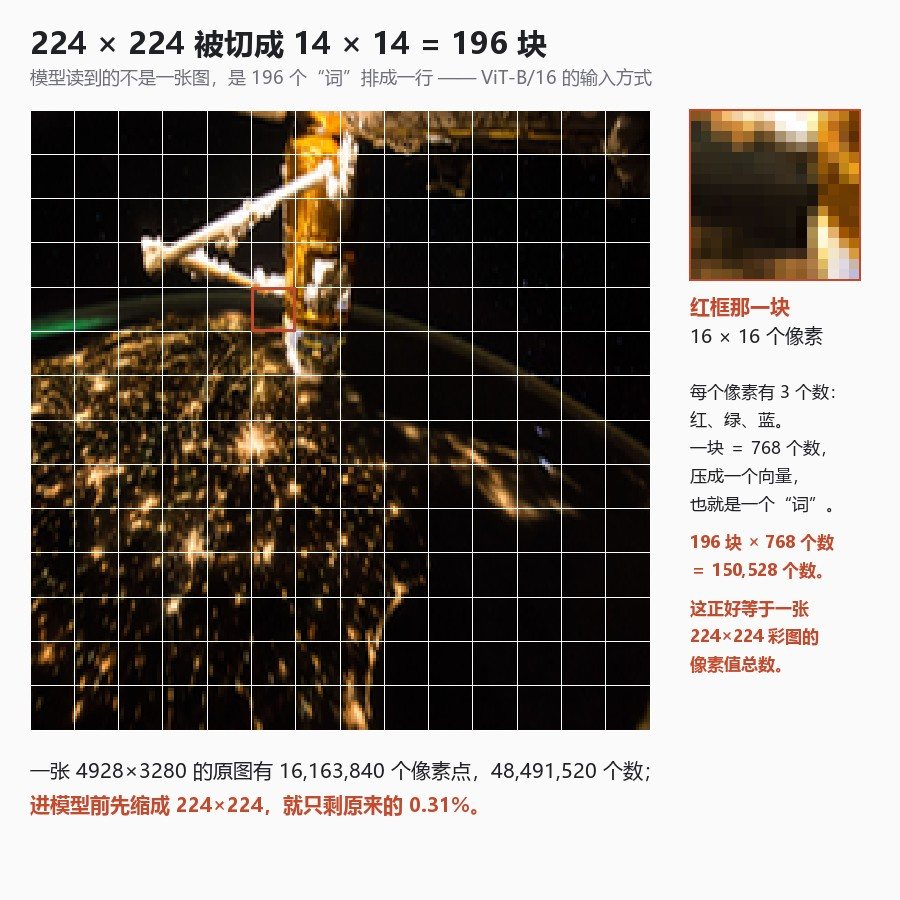
所以模型真正拿到手的,是一行 196 个「词」。这 196 个词要装下整张地球夜景:城市灯火、大气边缘那圈绿、航天器舱段、伸出去的机械臂。
我把同一张图缩了六遍
问的是同一句话:这张照片的主体是什么。
3280 像素,答:带金色隔热层的空间站舱段及机械臂,背景是地球夜间城市灯光与极光。
1024 像素,答:太空中的空间站部件,以及下方灯火辉煌的地球城市夜景。
448 像素,答:一艘停靠在空间站机械臂上的金色货运飞船,背景是夜晚灯火辉煌的地球。
224 像素,答:国际空间站上的航天器,以及下方璀璨的地球城市夜景。
112 像素,答:太空中一个带金色隔热层和天线的航天器组件。
56 像素,答:因严重模糊、失焦和像素化,无法准确辨认主体,看起来像是某种昆虫、植物碎屑或生锈金属物体的模糊特写。
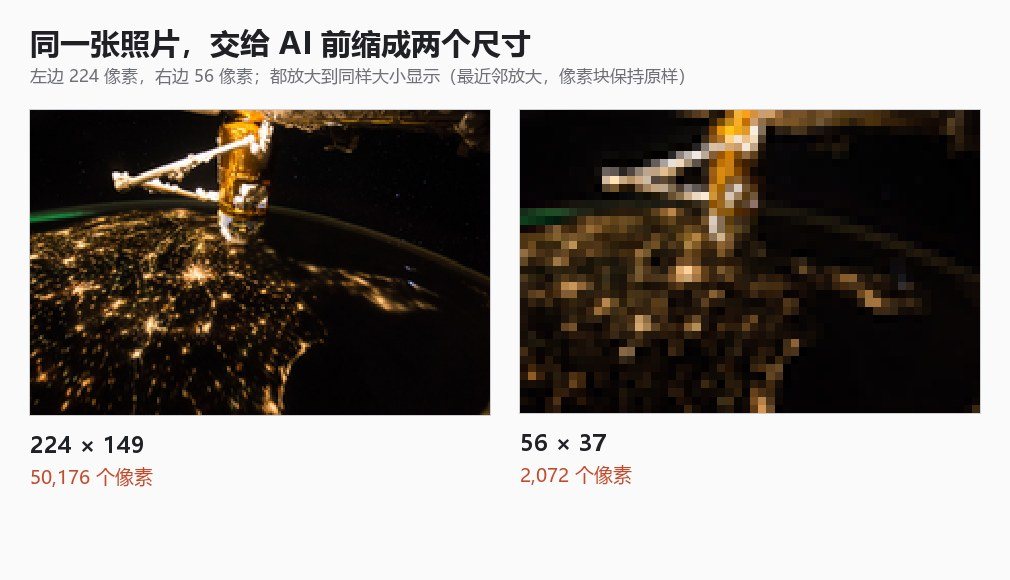
前四档都还在描述真实画面,只是越来越粗。
112 那一档变了性质:「地球夜景」这四个字彻底消失了,背景被抹干净,只剩前景一个航天器。
到 56,它开始硬猜。猜得还很肯定,一口气给了三个答案:昆虫、植物碎屑、生锈金属。
小字和背景为什么最先没
笔画的宽度是按像素算的。一个汉字印在 A4 纸上,笔画宽度可能只有几个像素。整张照片缩到 224,这几像素被平均成一两个,横竖撇捺黏成一团墨。
背景的问题是不显眼。
模型靠像素之间的对比去找东西,背景暗、碎、面积小,在缩放和压成向量的过程中最先被抹平。地球夜景在 112 那档整块消失,就是这条规则在起作用:它面积大,但亮度和周围差得不多,一旦被平均就变成一片均匀的暗。
还有一层:每块 patch 最后要压成一个向量。196 个向量概括一整张图,细节只能剩一句「城市夜景」。位置信息是被压掉的,不是被记住的。
这能解释一件常见的事。你发一张截图问「这里写的什么」,它答得含含糊糊;把同一段话复制成文字发过去,它立刻准确。
不是它偷懒,是图里那点笔画确实撑不住一次缩放。
分辨率不够的时候,AI 不是在偷懒,是它真的没看清。
想让 AI 看清小字,可以这么拍
只拍你要问的那块。想问合同上的小字,别把整张桌子拍进去。
靠近。让字占画面三分之一以上。笔画粗了,缩放之后才留得住。
自己先裁一刀。把重点区域裁出来单独传,比换一个更强的模型有用得多。
拍纸用扫描模式。光要足,手别抖,镜头跟纸面平行。斜着拍等于给自己加难度。
一张图问一件事。又让读字又问背景,它顾不过来。
要精确的数字、金额、编号,自己对着原图核。让 AI 做归纳、找位置,别让它做誊抄。
模型不会主动告诉你,它只看到了 0.31%。
它答得越顺,这句话越值得记一遍。
转给那个天天拿手机拍文件问 AI 的同事。