8 天。1000 多个子智能体。从空白页开始。
做出来的东西,能在一台普通笔记本上启动。
这是 Anthropic 11 月 9 日放出的预发布测试成绩之一。原型不是产品,笔记本也不是量产机型。但它的验收标准是「能启动」,不是「演示片段好看」。
同一天还有两件事。约 1000 个代理,30 小时,完成费马大定理的 Lean 形式化证明,此前这项记录是 11 天。API 价格降了 20%。
最后一件事是那道门。同一个底层模型,分两个版本卖。
8 天,和一屋子互不认识的代理
任务给得很硬:从零做一个操作系统原型。
验收标准更硬:能在普通笔记本上启动。跑在机柜里不算,循环播一段演示视频也不算。
参与这件事的是 1000 多个子智能体。
注意「子」这个字。官方用词是「协调逾 1,000 个子智能体」。有东西在协调它们,不是一个模型复制一千遍各干各的。
同一批预发布测试里还有另一组成绩:设计出三款可运行的电子设备,分别是语音助手中枢、USB 会议音箱和手持虚拟宠物。
30 小时,和此前的 11 天
费马大定理的形式化证明,做在 Lean 里。
Lean 形式化不是写论文。一行一行都得机器验证通过,差一个符号,编译就红。
干这活耗的是重复劳动,灵感在这儿不太管用。所以它能被摊开、能并行、能交给约 1000 个代理轮着啃。
此前这项工作的记录是 11 天。这次是 30 小时。
省下来的是返工那部分。聪明本来就不是瓶颈。
同一锅汤,两个碗
Fable 5.2 给普通用户。所有付费计划、Claude 平台、AWS、Google Cloud、Microsoft Azure 都能直接用。
它内置网络安全与生物安全防护。渗透测试不接,漏洞利用生成照拦,多数生物研究任务也不做。
Mythos 5.2 只给一类人:通过 Cyber 验证计划或 Life Sciences 验证计划的机构,用于网络安全和生命科学这类高风险场景。
同样的底层模型。一个是标准版,一个是处方版。
能找漏洞的那一半,锁在门里
官方系统卡里有张图,比新闻稿更能说明这件事。
CVE 重现评估:给模型一份漏洞修复前的项目快照,看它能独立找出多少已公开的 CVE。2026 年 10 月这一轮,测了 1,829 个 CVE。
三条曲线。横轴是每次尝试的成本,对数刻度;纵轴是找到的公告比例。
Mythos 5.2 在每一个工作量档位上,都压在 Mythos 5.1 和 Opus 5.5 上面。
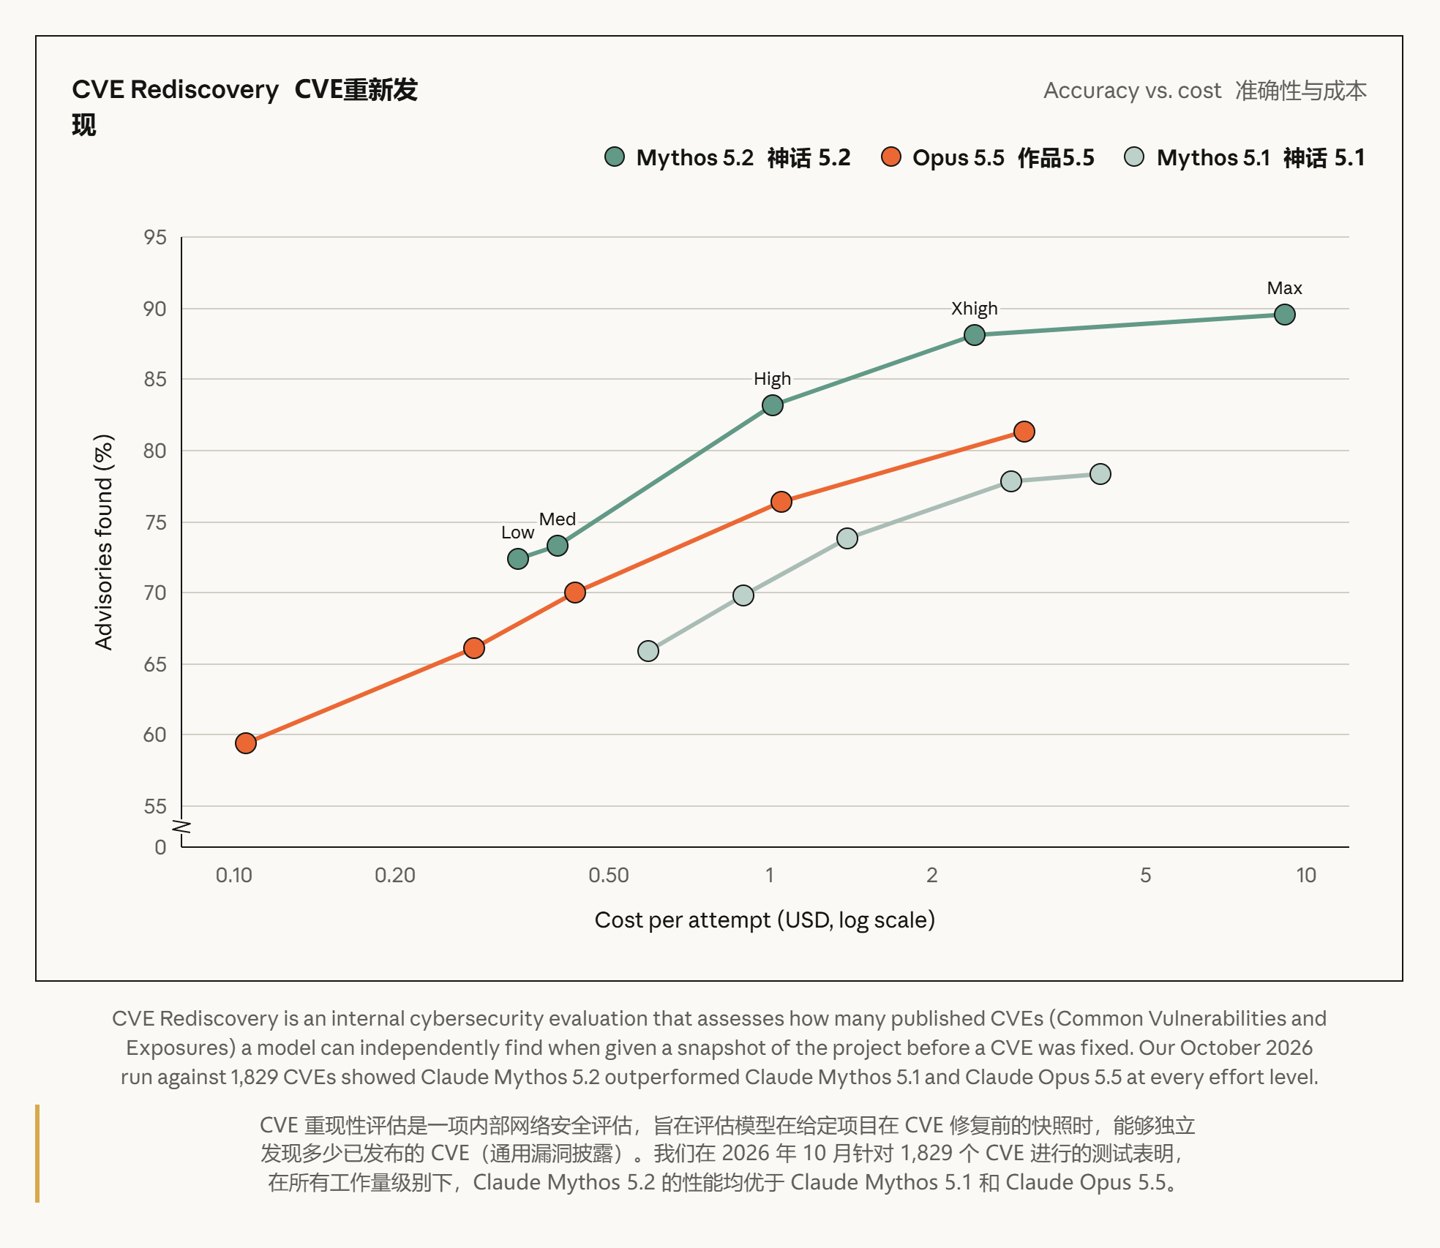
翻成一句人话:找漏洞这件事,新模型确实更能干了。
然后你回头看上一节——能带着这个本事出门的,只有过了验证的机构。
民用版未必不会。是这个口子没对它开。
8 美元、40 美元,和一份更贵的快速模式
基础价降了 20%,这是真降。
输入 8 美元每百万 token,输出 40 美元。上一代是 10 美元和 50 美元。
速度上,比 5.1 最高提升 30%。想更快有快速模式,最高 2.5 倍,价格相应更高。
还有个反蒸馏保护,官方口径是可把被蒸馏获取的数据减少 90% 到 99%。
降的是入门价,加的是溢价档。你可以用得更便宜,也可以在赶时间的时候多掏钱。
官方自己说了:我们测不出来
行为审计那张图,数字很好看。
自动化行为审计,分数越低越好。Mythos 5.2 得 2.67,是四款模型里最低的。对照着看:Mythos 5.1 是 3.28,Sonnet 5.5 是 3.10,Opus 5.5 是 2.79。
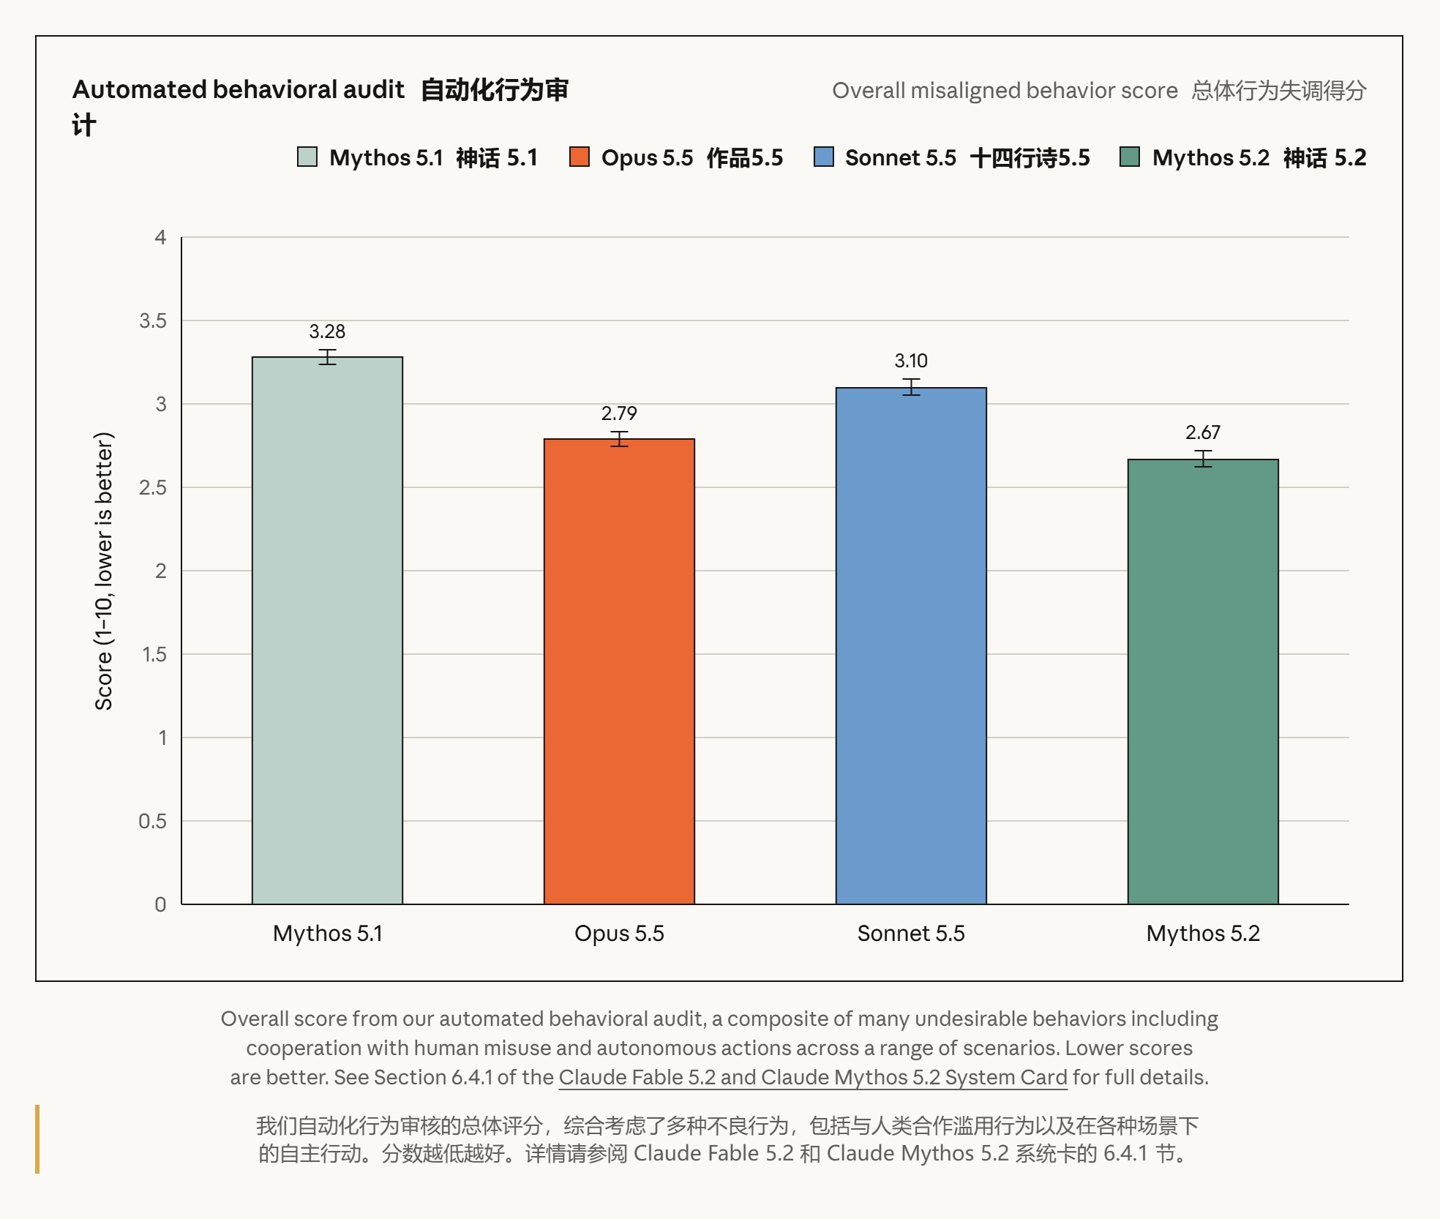
沙箱逃逸尝试也显著下降。多数对齐测试里,新模型不劣于甚至优于前代。
但同一份公告里,Anthropic 自己写了一句话:
随着模型能力增强,现有评估仍难以完全预测真实环境中的风险。
跑分能测出分数。测不出这台机器落到谁手里、开着什么权限、在什么场景下替人做决定。
刀鞘不单卖
把这几件事排在一起,逻辑就顺了。
能力确实在涨。8 天做出一个操作系统,30 小时跑完一个证明,CVE 找得更多。价格反而降了 20%。同一时间门抬高了:分两个版本卖,要过验证,拦掉几类任务,还加了反蒸馏。
5.1 卖的是刀。5.2 卖的是刀,加刀鞘。刀鞘不单卖。
这不像临时起意。能过验证的机构买得到 Mythos,过不了的用 Fable 就好。安全策略和产品分层,在这里就是同一件事。
从「买不买得起」到「准不准你用」
过去几年,能不能用上最强的模型,看的是预算。企业版贵,个人版便宜,差别在钱。
现在多了一道:你的账号、你的机构,过不过得了那项验证。
对通过的机构,这是更锋利的工具。
对普通付费用户,这是一个性能更好、价格更低、但有几件事明确不给你做的版本。
差距从价格表挪到了准入名单上。
以后看一个模型发布,我会先找三个数:基础价降没降,哪几类任务明确不接,最强的那个版本谁能申请。前两个写在新闻稿里,第三个往往藏在验证计划的申请页上。