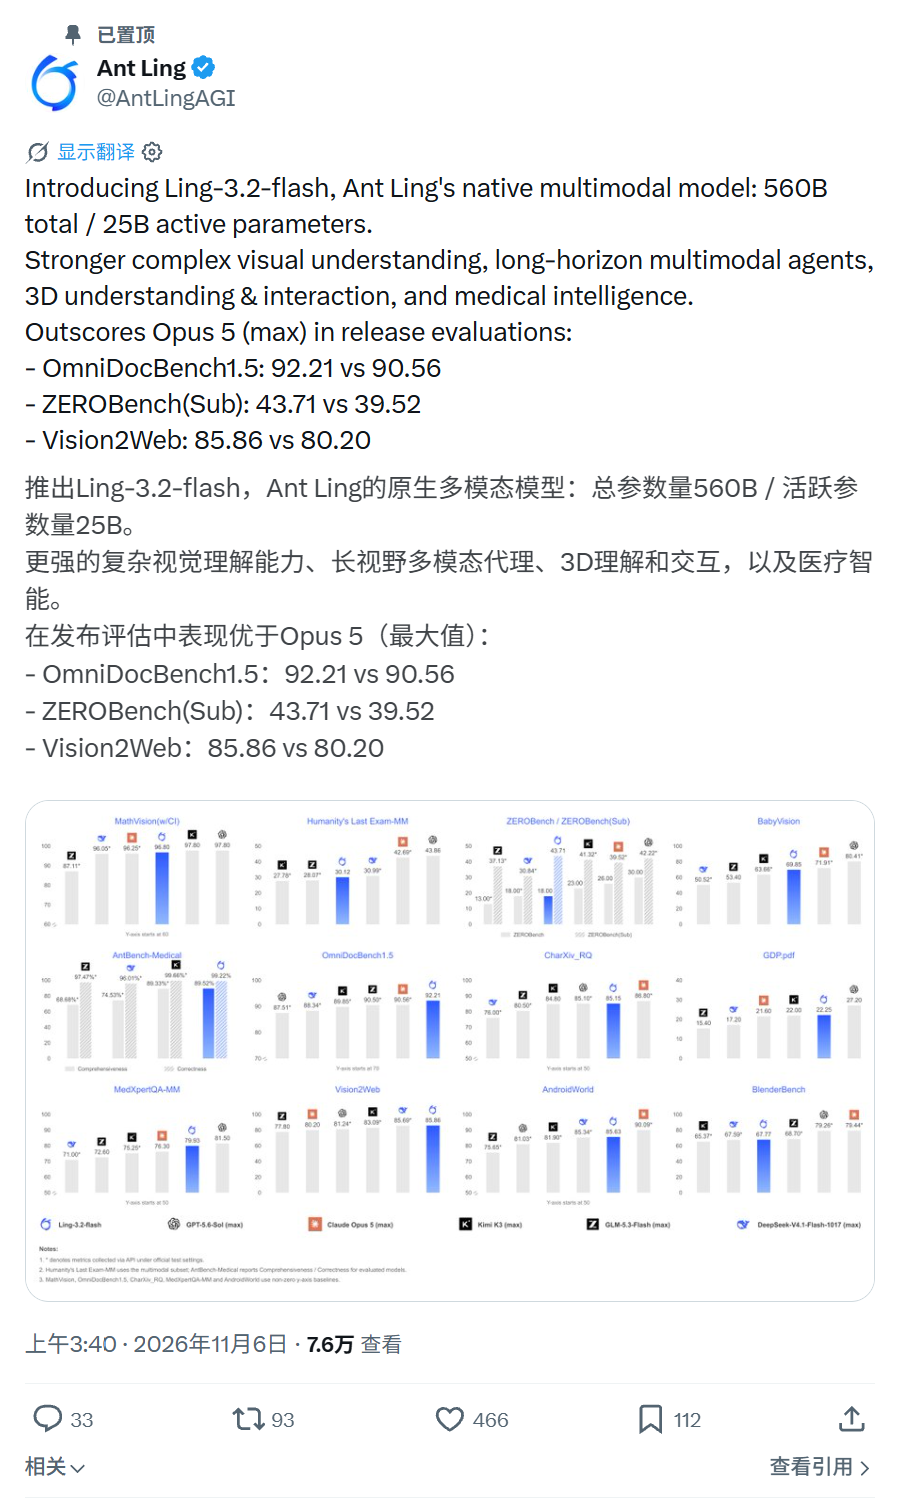
11 月 6 日,蚂蚁百灵团队发布了一个新模型,Ling-3.2-flash。
公告最前面放的不是跑分,是两个参数:560B 总参数,25B 激活参数。
这两个数差了 22 倍。放在一起容易看岔——到底哪个才算「这个模型多大」?
先把两个数分开
560B 是总参数。模型里所有可调的权重加起来,5600 亿。
25B 是激活参数。每次前向计算,真正参与运算的,250 亿。
官方公告里有一句解释:这种组合「通常对应混合专家(MoE)架构,模型在每次前向计算中仅调用部分参数,从而在保留大容量知识存储的同时控制单步计算成本」。
这句话信息量够了。MoE 就是把模型拆成很多块「专家」,来一个请求,只唤醒其中一部分,剩下的不动。
所以 560B 说的是容量,25B 说的是每一步的运算量。
换算一下,每一步只调用总量的 4.5% 左右。
它敢叫 flash,大概是这个原因。不过这条是我的推测,官方公告里没解释命名。
三个基准,数字摆出来
官方给了三组对比,对手都是 Claude Opus 5,标注是 max 版本。
OmniDocBench1.5:92.21 对 90.56。
ZEROBench(Sub):43.71 对 39.52。
Vision2Web:85.86 对 80.20。
三组都高。分差最大的是 Vision2Web,5.66 分;最小的是 OmniDocBench1.5,1.65 分。
有三件事得说在前面。
第一,这是厂商自己公布的评测。我没跑过,也验证不了。这三个基准具体考什么、题目怎么出,官方公告里没写,我只看到分数。
第二,这是从一堆里选出来的三项。
第三,对手标的是 Opus 5 的 max 版,不是标准版。这个区别在跑分上不小。
那张 12 格的图
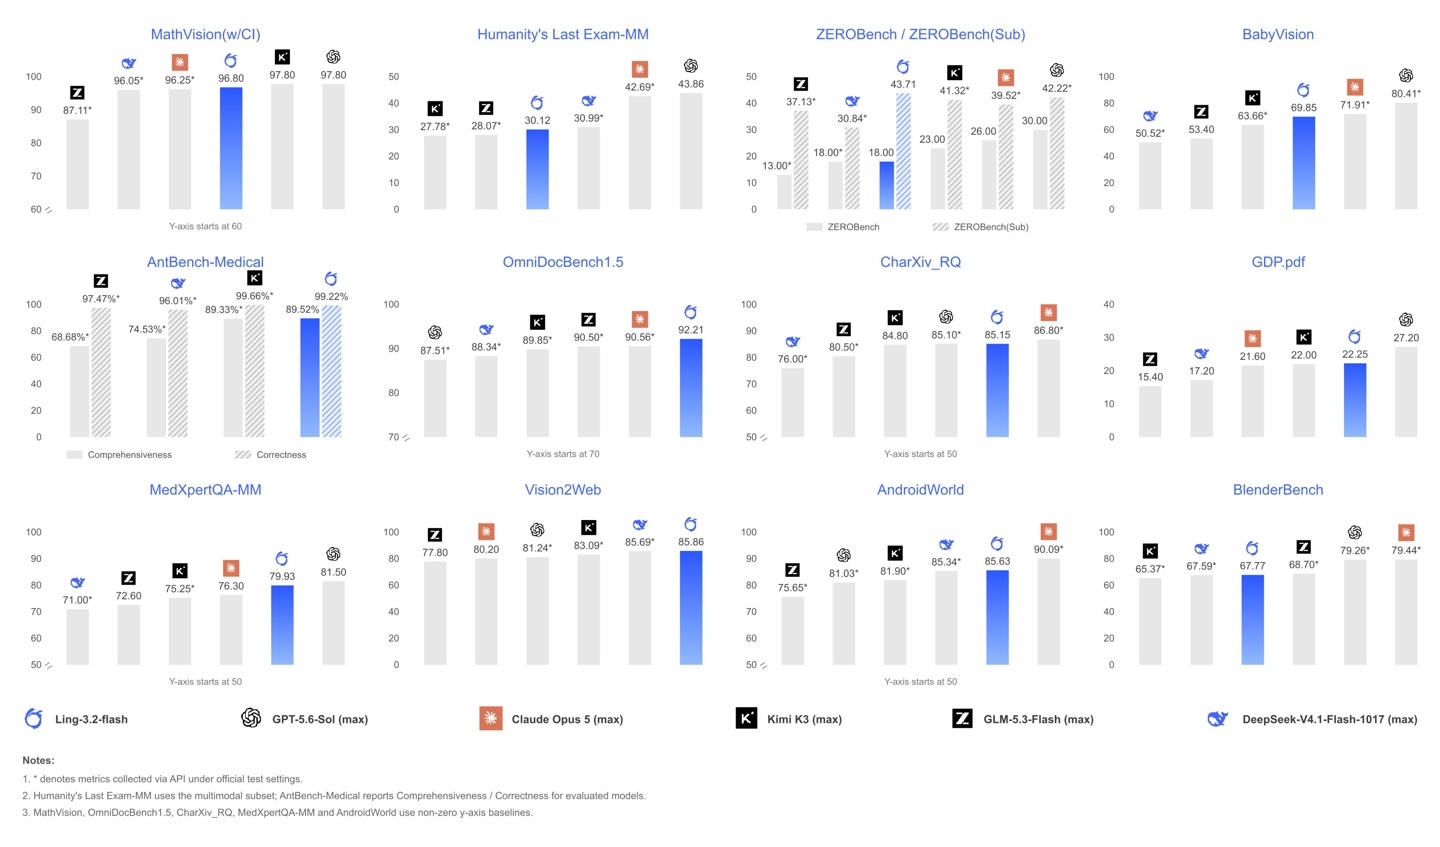
官方放了一张 3 行 4 列的子图矩阵,12 个基准各占一格。
横着是六个模型:Ling-3.2-flash、GPT-5.6-Sol、Claude Opus 5、Kimi K3、GLM-5.3-Flash、DeepSeek-V4.1-Flash-1017,后面都带 max。
格子上的名字能看清。前六个是 MathVision、Humanity's Last Exam-MM、ZEROBench 与 ZEROBench(Sub)、BabyVision、AntBench-Medical、OmniDocBench1.5。
后六个是 CharXiv_RQ、GDP.pdf、MedXpertQA-MM、Vision2Web、AndroidWorld、BlenderBench。
公告只点了三项。剩下九项的成绩,公告里没给结论。我也没逐格去比对哪根柱子属于哪个模型——颜色太接近,读错一格就写错一句话。
所以「三项超过」这个说法准确,但也只是三项。
Elo 1238,第十名
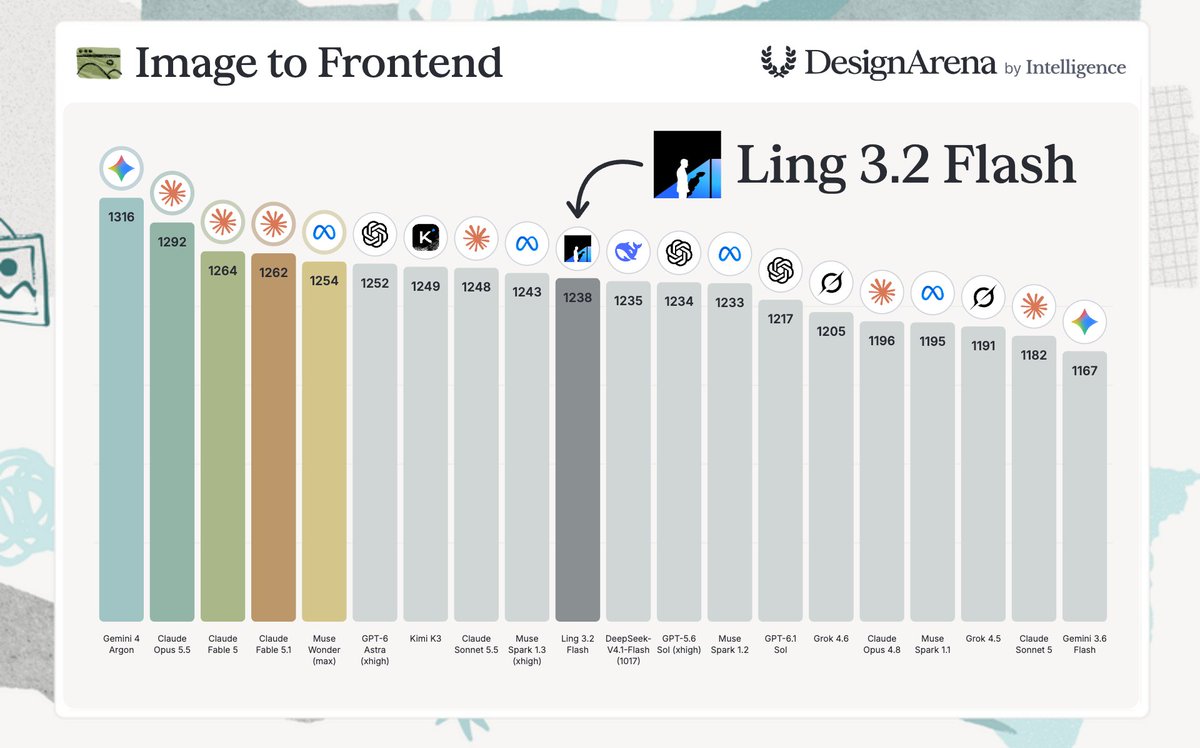
DesignArena 有个 Image to Frontend 榜,考的是把截图转成前端代码。
榜上竖着排了 20 个模型。Ling 3.2 Flash 在第十位,1238 分。
第一是 Gemini 4 Argon,1316。第二 Claude Opus 5.5,1292。
再往下:Kimi K3 是 1243,DeepSeek-V4.1-Flash 是 1234,GPT-5.6 Sol 是 1233。
它夹在这几个中间。原文说「与 Meta、DeepSeek 及 Anthropic 等竞品并列」,看图上确实就是挨着排。
1M 上下文,还有四块能力
上下文窗口 100 万词元。
这个数现在不算稀奇,好几家都有。实际用起来的体感,我没测过。
官方强调的四项是:复杂视觉理解、多模态长程 Agent、3D 理解与交互、医疗多模态。
前两项好懂。3D 那项原文写「侧重三维场景与空间关系的解析」。医疗那项写「覆盖医学影像理解与报告解读,辅助专业医疗分析」。
「辅助」两个字用得挺谨慎。
价格,和一句最实用的话
输入每百万词元 0.30 美元。输出每百万词元 0.90 美元。
公告引了 DesignArena 榜单的说法,称这是「同性能级别模型中最低的费率」。这句是榜单说的,我只是转述,没比过价。
对普通人最实在的是另一句:兼容 OpenAI 及 Anthropic 协议。
意思是原来写好的调用代码,改个地址和模型名就能用,不用重学一套。
API 已经上了蚂蚁百炼平台。上线前两周免费。
我的看法
这模型最值得看的地方,不是那三项跑分。
是它把「能力上限」和「每次花多少」拆成了两个旋钮。总参数管前者,激活参数管后者。
以前比谁参数大,现在比谁能在小激活量下拿到高分。这半年几乎每家都往这条路上走。
至于好不好用,我现在给不出答案。跑分是厂商给的,榜单是竞技场的公开数据,我手上一次真实调用记录都没有。
等免费期过去,价格表摆在一起比,大概更能看出各自的水平线。
你平时用 AI 主要干什么?如果只是改文字、整理表格,这种「大容量、小激活」的模型可能刚好够。