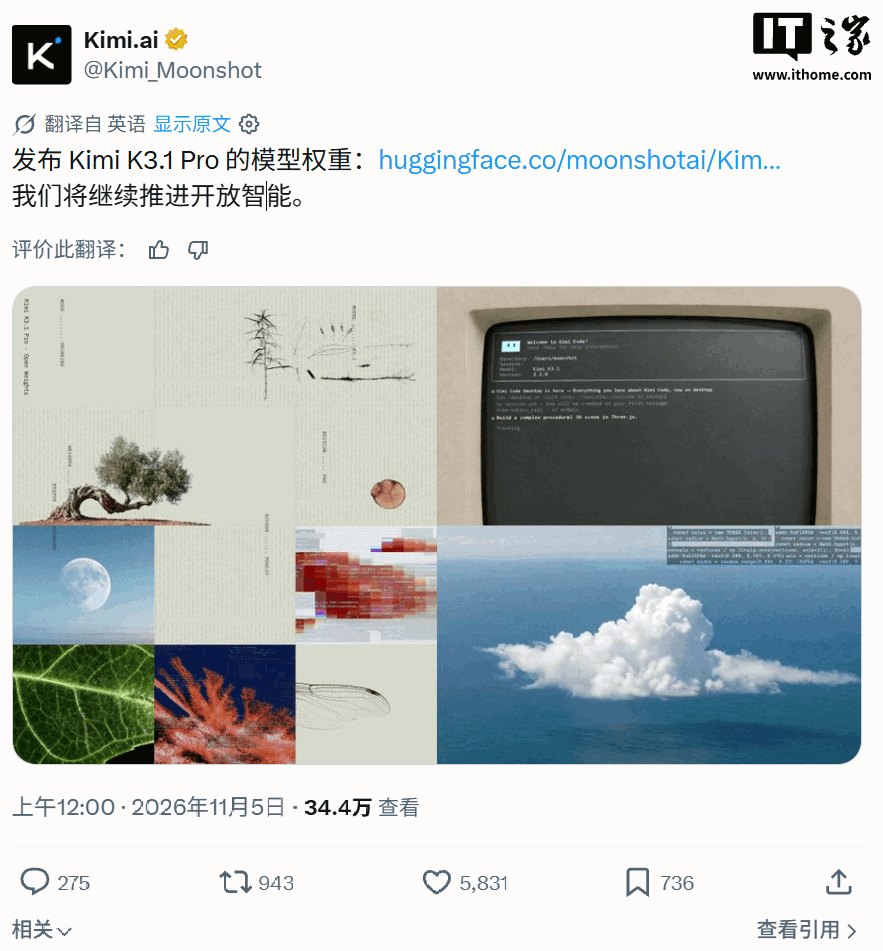
11 月 6 日,摩尔线程宣布基于自家的 MTT S5000 训推一体智算卡和 MUSA 软件栈,完成了 Kimi-K3.1 Pro 的 Day-0 适配。模型加载、服务启动、文本和图片的基础推理链路,都打通了。
国产卡接国产模型,这是一条很顺的消息。我本来打算照这个写。
然后我去 HuggingFace 看了一眼模型卡。
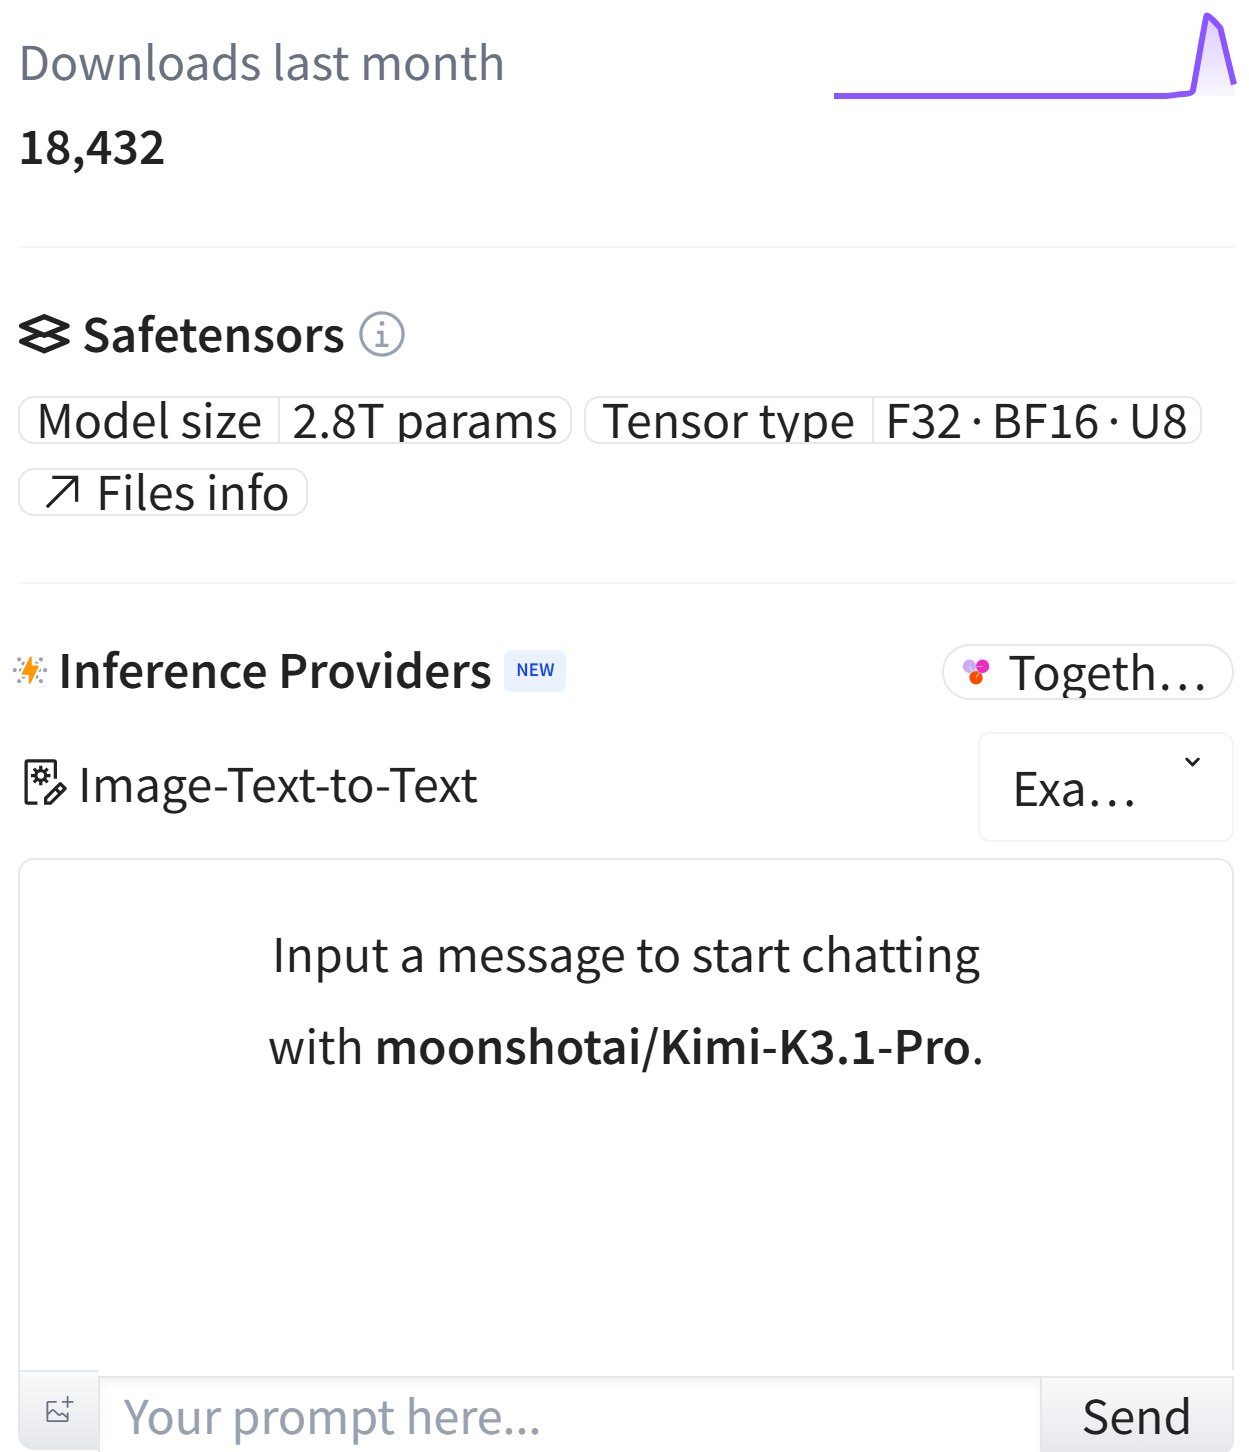
Model size:2.8T params。
通稿写的是"迄今能力最强的 3 万亿级参数模型"。
3 万亿是 3T。模型卡写 2.8T。中间差两千亿。
这个差异没人解释
我查了三处。
摩尔线程的通稿,写"3 万亿级"。
HuggingFace 上 moonshotai/Kimi-K3.1-Pro 的模型卡,写 2.8T params。
IT之家另一篇相关文章的标题,写的是"月之暗面 2.8 万亿参数 Kimi K3.1 Pro 开放权重"。
同一个站,一篇写 3 万亿,另一篇标题写 2.8 万亿。
没有哪一方出来说明这个差别从哪来。"3 万亿级"这种带"级"的说法,可以解释成取整;但 2.8T 是一个精确到小数点后一位的数,不是取整的结果。
我不知道哪个对。 这句话我放在这儿,不替它圆。
参数不是宣传数字
说一个我自己踩过的认知。
参数量直接影响三件事:要几张卡、显存怎么切、单次推理摊多少钱。
差两千亿参数,落到部署上不是一行字的差别。所以这件事值得较真,不是抠字眼。
反过来说,如果只是"3 万亿级"这种模糊表述出现在宣传语里,也能理解。麻烦的是它出现在技术说明里,旁边还摆着两个精确到小数点的跑分。
技术细节是真的有内容
抛开数字争议,这次通稿里的技术描述是有干货的,不是一句"适配完成"了事。
MUSA 这条线走的是复用:用 SGLang-MUSA 承接上游模型实现,靠 MATE 算子库、Triton-MUSA、TileLang-MUSA 和 MTCC 编译器,把社区模型代码转成 MTT S5000 上的推理服务。覆盖的是框架执行、算子编译、设备运行、多卡通信四层。
针对 K3.1 Pro 的稀疏注意力 DSA,做了索引选择、KV 缓存布局、Prefill 和 Decode 两条计算路径的适配,接入 MATE 的稀疏注意力算子,再和 KDA 状态管理、跨层残差、视觉 Attention 拼成完整执行链路。
专家权重用的 MXFP4。做法是在线转换,加跨层复用 FP8 工作区,不需要预先生成一整套离线 FP8 权重。
这一条我觉得是这次最实际的。2.8T 的模型,权重先转一遍再存一份,落盘和加载的时间都不是小数。省掉这一步,部署能快一截。
两个跑分,和它旁边缺的东西
Terminal-Bench 4.0 得分 65.7%。
Kimi Code Bench 3.0 的 Long-horizon 得分 61.2%,上一代 K3 是 55.95%。
这两个数出自模型侧的说明,不是摩尔线程自己测的。这一点要说清楚:跑分是模型的能力,不是这张卡的能力。
这张卡跑这两个基准,实际多少分、什么配置下测的、几张卡、什么精度——通稿里没有。 我找了一遍,没找到。
所以我只能确认"能跑",不能确认"跑得多快"。
榜单比参数更值得看
Agent Arena 那个智能体排行榜上,Kimi K3.1 Pro(Max)在开放权重模型里排第一,全部参评模型里排第 13。工作、编程、聊天三个分类里,都是开放模型第一。
这个名次不是厂商问自己要的,是别人拿任务跑出来的。
它至少说明一件事:权重开出来了,能力是能被打分的。
至于这张卡能不能把这个能力完整发挥出来,那是另一个问题,需要另一组数据。
我确实核不了的部分
列一下,免得看着像我都懂。
MTT S5000 上跑 K3.1 Pro,单卡吞吐多少、多少张卡能撑起 100 万上下文、MXFP4 量化后精度掉多少——这三个数我一个都没有。
我手上一台 MTT S5000 都没有,一次真实推理没跑过。本文所有关于性能的描述,都是转述,不是实测。
Day-0 这个词,我也没找到厂商给的准确定义。上面对它的解释是我的理解。
剩下那句
权重公开是 11 月 4 日,适配宣布是 11 月 6 日,中间两天。这个节奏在国产卡里不算慢。
参数到底是 2.8T 还是 3 万亿,我倾向于模型卡,因为那是一个要被人拿来算显存的地方,写错代价更大。但这只是我的判断,没有证据。
你如果手上有 MTT S5000 跑过这类模型,实际吞吐是多少?这个数比跑分有用。