-
 蚂蚁发了个不会写话的模型:Token 少 90%,快 10 倍
蚂蚁数科 10 月 22 日发布决策模型 LingDT-Decision-1.0,有 4B 与 27B 两个版本,已在自建平台限时免费。它不生成句子,只在给定选项里挑一个,官方称相比大语言模型 Token 消耗降低超 90%、响应时效提升 10 倍。本文把这个数字的对比基线逐条拆开,并指出报道没提的一个细节:4B 版本在同尺寸组里其实排第二,只差 0.07 分。
-
 机器人捡垃圾前,先给自己画了张地图
千诀科技 2026 年 10 月 20 日在南京物理 AI 与世界模型大会上发布预测式世界模型 Polibrain。核心比喻是:有了地图可以推出最短路径,但有了路径反推不出地图。文中还原了「主人出门拿走钥匙」被误当因果的例子,也写清边界——报道明确说这套机制在复杂场景是否可靠还需更完整的实测数据,抓取成功率等指标没有公开。
-
 25%重叠多出28%重复字符,召回反而降了
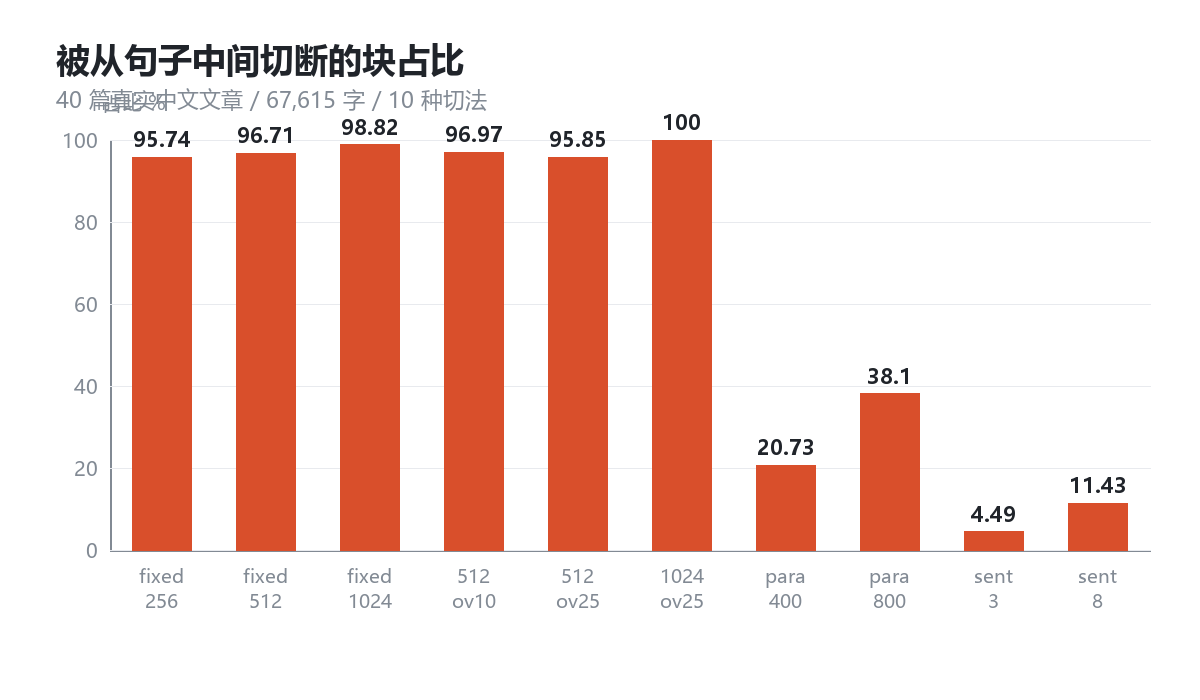
拿 40 篇真实中文文章、共 67,615 字,用 10 种切法各切一遍,量三件事:块被从句子中间切断的比例、切片总量多出来的重复字符、以及检索时正确的块能不能排到第一。固定字数切块九成五以上断在半句话上;加 25% 重叠让重复字符涨到 28.27%,R@1 反而从 91.15% 降到 89.17%;按段落切的 para_800 拿到最高的 93.33%。
-
 18 条脏 JSON,5 种解析写法:最好的救回 14 条,最差 1 条
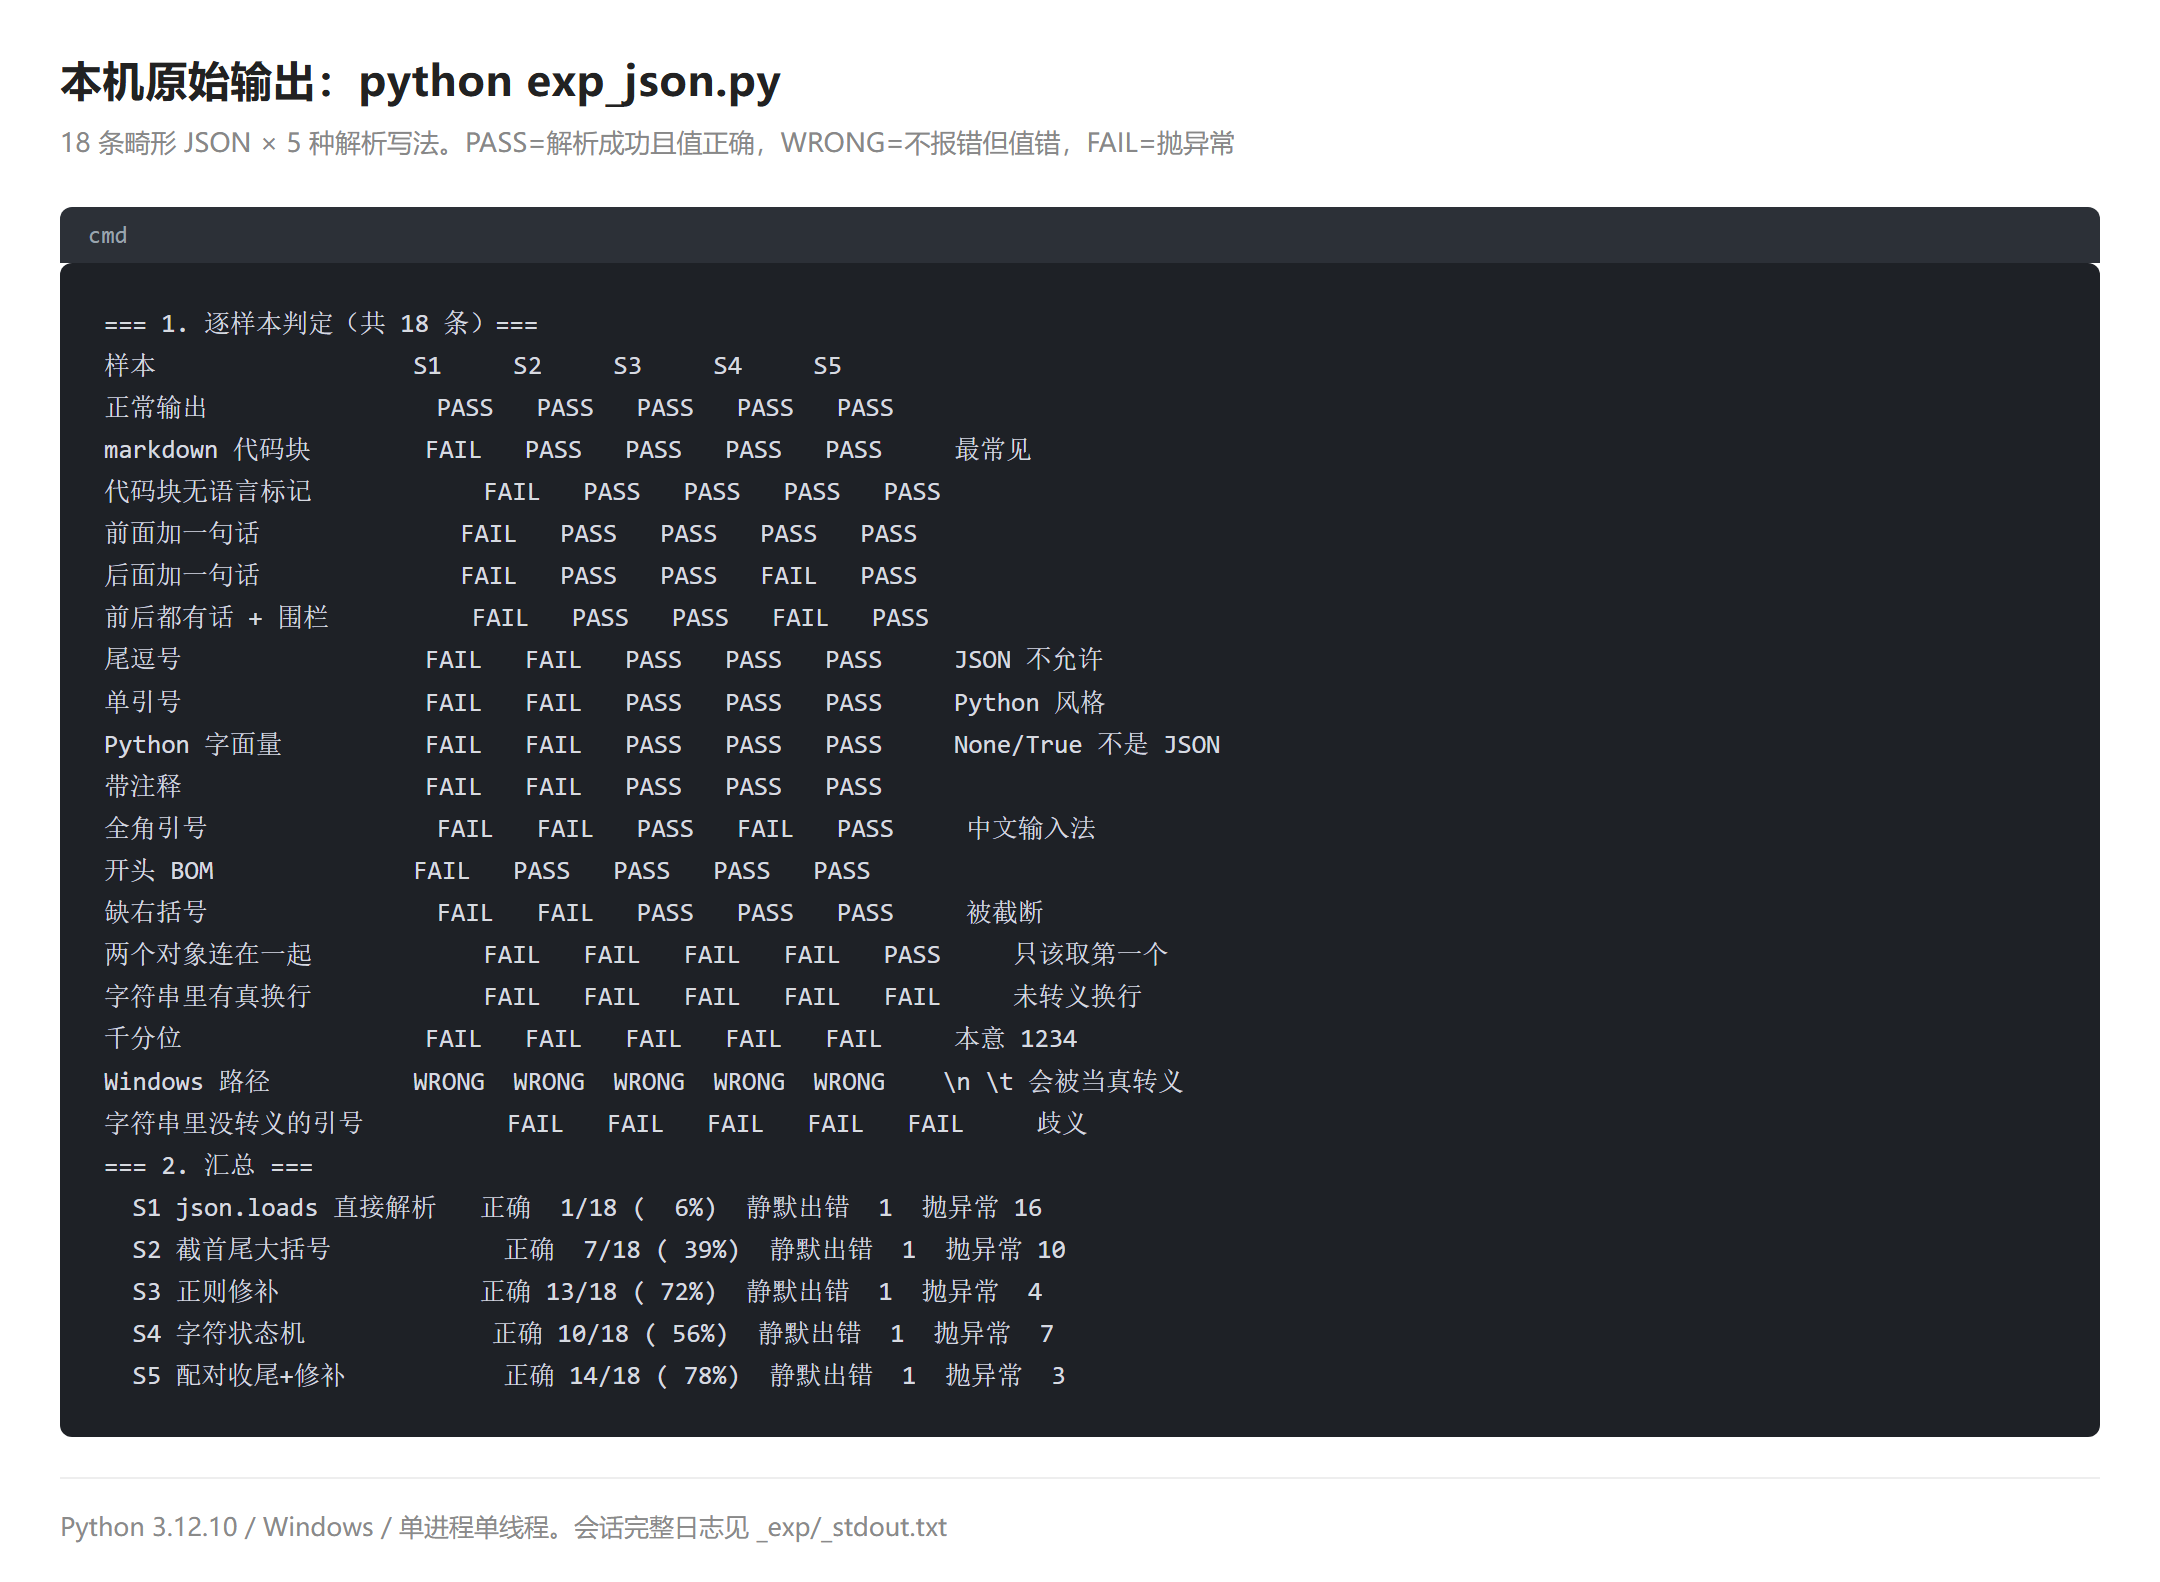
18 条手写畸形 JSON 实测 5 种解析写法。json.loads 直接解析只过 1 条,只截大括号 7 条,正则修补 13 条,自己写的字符状态机反而只有 10 条,括号配对加修补 14 条。另有 4 条谁都救不回,还有一条 5 种写法全部不报错但值是错的。
-
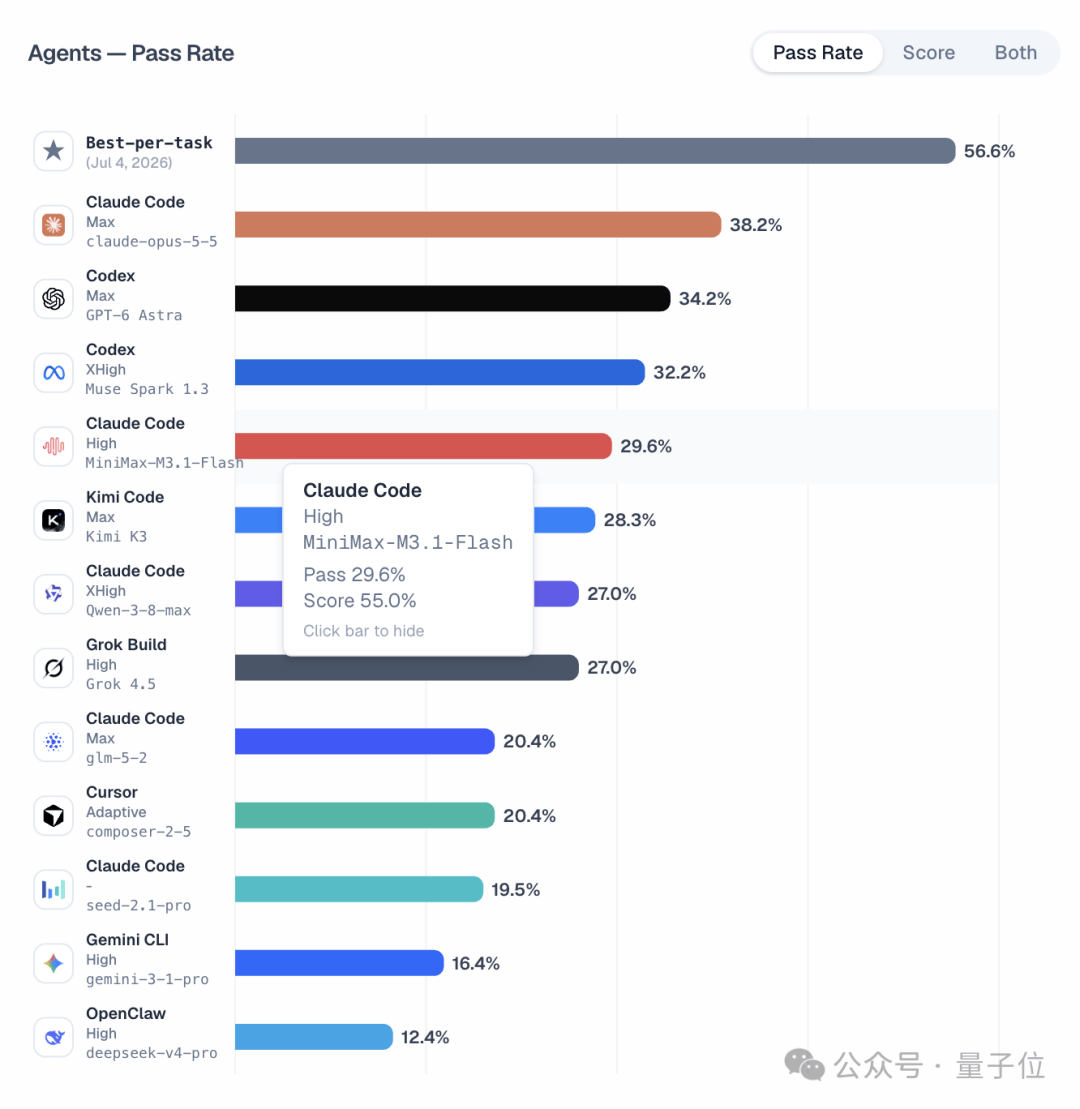 成本只剩上一代 30%,跑分却反超 Claude Opus 5
国庆在 OpenRouter 匿名屠榜的 Space Bunny 落地,是 MiniMax M3.1 Flash:输入每百万 token 1 元、输出 4 元、缓存 0.1 元,综合成本压到上一代 M3 的三成。ALE 29.6% 拿国模第一,DeepSWE v1.1 拿 73.7% 反超 Claude Opus 5,CyberGym 82.2,BankerToolBench 76.2 与 Claude Opus 5 并列,OSWorld V2 61.7,AutomationBench-AA 单任务成本不到 0.05 美元,输出最快 200+ TPS。代价是 Flash 属小模型,榜单又都是公开题库,深度推理仍会掉链子。
-
 每次跟AI对话都要重讲一遍,这事终于有人管了
腾讯混元开源智能体记忆框架 Hy Memory 2.0,开源专用模型、记忆框架与 MemHub 应用三层能力。框架层负责聊天、工作、代码三类记忆的存储、更新与进化,官方称是业界首个提出工作记忆与代码记忆的框架。官方称在 4 个 Benchmark 上对比 Mem0、MemOS、EverOS 等开源框架均列第一;专用模型 Hy-Memory-30A3B 约 3B 激活参数,宏观平均 55.49%,高于 Claude Opus 5 的 54.62%。SDK 与 MemHub 已在 GitHub 开源,模型权重发布在 Hugging Face。
-
 200K上下文免费,DeepSeek这波图啥
OpenCode 宣布 DeepSeek V4.1 Flash 免费提供,免费版支持 200K 上下文窗口(付费版为 1M)。此前套餐额度从 15 美元先后提到 60、80 美元,本次免费后调用不再计入额度消耗。该模型为原生多模态 MoE,主干参数 552B,社区用户反映生成速度 TPS 波动较大、上下文增长后掉速明显。
-
 100万token一夜重构,谷歌这模型把数月活干成数周
谷歌 Gemini 4 Argon 上线,支持最高约100万 token 的长解码输出,但输入、思考、输出共用同一个上下文窗口。官方称其擅长编码、金融、法律、网络安全、科学,Vals Index 排名第一。入门价输入每百万 token 2美元、输出10美元,11月30日后翻倍。
-
 2000万美元,迪士尼成了Character.AI的接盘方?
据路透社报道,Character.AI 已在美国申请破产保护,并同意以 2000 万美元(约合 1.34 亿元人民币)向华特迪士尼出售部分知识产权,迪士尼被指定为首席竞标方、报价作竞标底价。资产出售预计 2026 年 11 月下旬或 12 月初完成;若最终无人接手运营该平台,公司将逐步结束相关业务。
-
 3GB内存跑大模型,iPhone也能13 token/s
面壁智能发布端侧多模态大模型 MiniCPM-V 4.7,含 35B-A3B 与 1B 两个规格,35B-A3B 是系列首个 MoE 模型。官方称在 iPhone 17 Pro Max 上以仅 3GB 内存达到 13+ token/s 解码速度,支持 iOS、安卓与鸿蒙,适配 Intel、AMD、Arm、瑞芯微、后摩等芯片平台,并同步开源 SRFT 微调方案。
-
 Claude 半年封了 1140 万个账号,申诉成功率只有 10.5%
Anthropic 7 月的安全与信任报告显示,2026 年上半年 Claude 封禁了 1140 万个账号,同期 39.8 万次申诉只翻案 4.2 万次,成功率 10.5%。这篇讲清这份报告里的数字、封号触发条件、申诉为什么这么难,以及重度用户该怎么给自己留后路。
-
 微软新模型比 GPT-6 快 35 倍,底座却是阿里的 Qwen3.5
微软上线决策模型 Microsoft-Decision-1:官方称基于阿里的 Qwen3.5-9B 后训练,36 项基准测试准确率最高,响应速度比 GPT-6 Sol 快 35 倍,每百万 token 输入 0.042 美元、输出免费,已进 Microsoft Foundry 和 OpenRouter。这篇讲清它是什么,以及底座选了 Qwen 意味着什么。
-
 OpenAI 的 GPT-6.1 快了 8 倍,也贵了 6 倍:到底谁来买
OpenAI 上线 GPT-6.1 Sol 的 Ultrafast 版:速度最高可达标准版 8 倍,价格也是 6 倍,每百万 tokens 输入 12 美元、输出 60 美元,只面向 Pro 500、按量付费企业版和配额教育版开放。这篇讲清它快在哪、贵在哪,以及什么场景值得为速度多掏钱。
-
 OpenAI 的收费单上,第一次出现了中国模型
9 月 30 日,美国 AI 基础设施公司 Baseten 与 OpenAI 合作,企业用户在 Codex 里可以调用 Kimi K3、GLM 5.3 等开源模型,这是中国开源模型第一次进入 OpenAI 的企业采购体系。这篇讲清这条消息的分量,以及写代码的上班族接下来会感觉到什么。
-
 没人插手,Claude 用几天算出了物理学家几十年的难题
Anthropic 的 Claude 在几乎无人工干预下连续运行数天,算出了平面 N=4 超杨-米尔斯理论六粒子振幅的九圈结果,把人类纪录从八圈推进到九圈,部分展开有 300 亿项。这篇讲清大模型为什么能做这种极限计算,又为什么这不代表它真的懂物理。