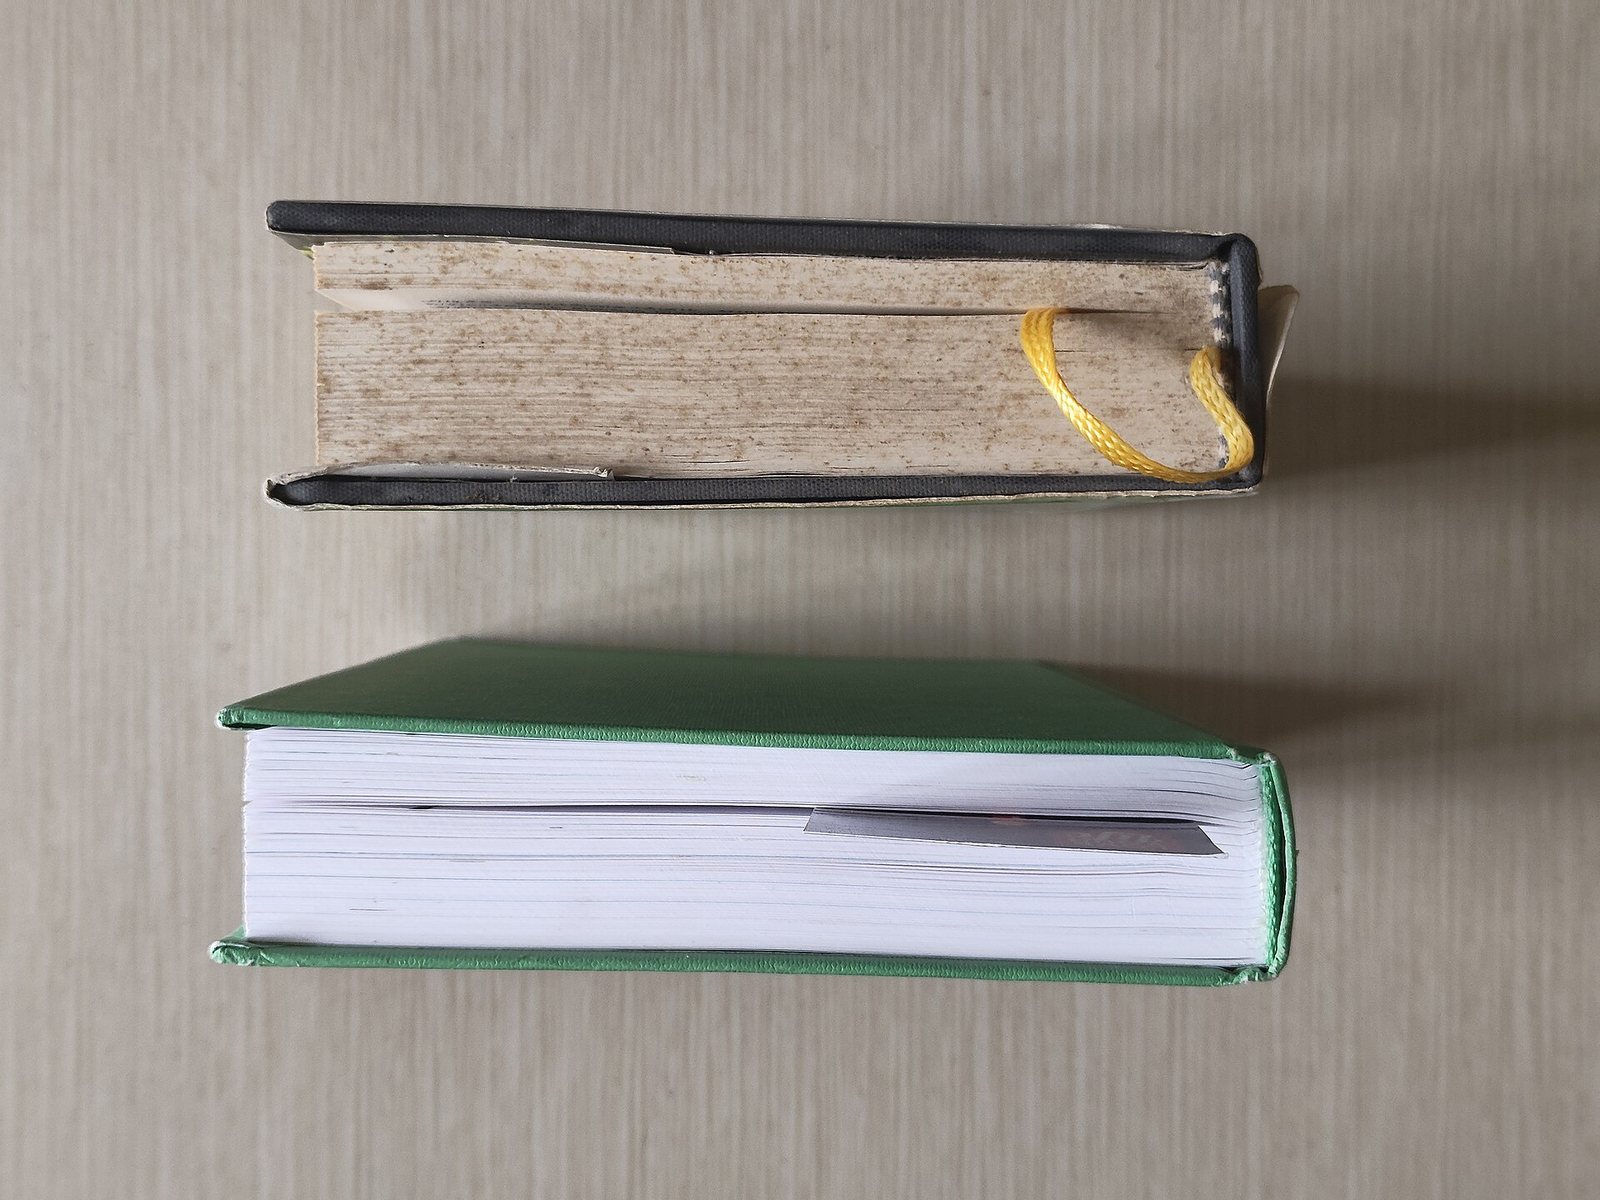
书签从桌沿掉下去,纸片先飘一下,翻个面,边角蹭到杯子,落地,弹两下,停住。
人看一眼就懂。机器要算很久。
乌镇发布的东西,猜的不是文字
11 月 4 日,乌镇世界互联网大会,魔芯科技发布了新一代通用 4D 世界模型 MoWorld 2.0。
这家公司 2021 年成立。创始人陈天润,浙江大学博士生,创办的时候还在读大三。
最早他们做的是 3D 打印机。2024 年底调头做世界模型。2025 年 12 月出 KOKONI-World 原型,2026 年 7 月 MoWorld 1.0,11 月迭代到 2.0。
从打印机到世界模型,两年不到。
聊天模型猜下一个字,它猜下一秒
先说你天天用的聊天模型。
它干的活是猜下一个字。给它「今天天气」,它算「真」「不」「错」哪个概率高,然后往外吐。
它猜的是词。
词和词挨着谁,它门儿清。可它不知道什么叫硬,什么叫软,什么叫滑。这些词它认识,词背后的那件事,它没碰过。
世界模型猜的是另一码事:下一秒画面怎么变。
还是那张书签。你说「松手」,它得算:重力往下拉,空气托一下,边角磕到杯子会偏一点,落地会弹。
这就是两者的分界。一个在语言的格子里挪,一个在空间的格子里挪。
十几种物理要素,塞进同一个模型
MoWorld 2.0 把重力、弹力、浮力、光照、柔体、流体、刚体、形塑体、热力,十余种物理要素融进了同一个模型。
官方举的例子就是书签。它能生成书签掉落的画面,还能模拟书签和其他物体怎么接触、怎么受力、怎么弹起来。
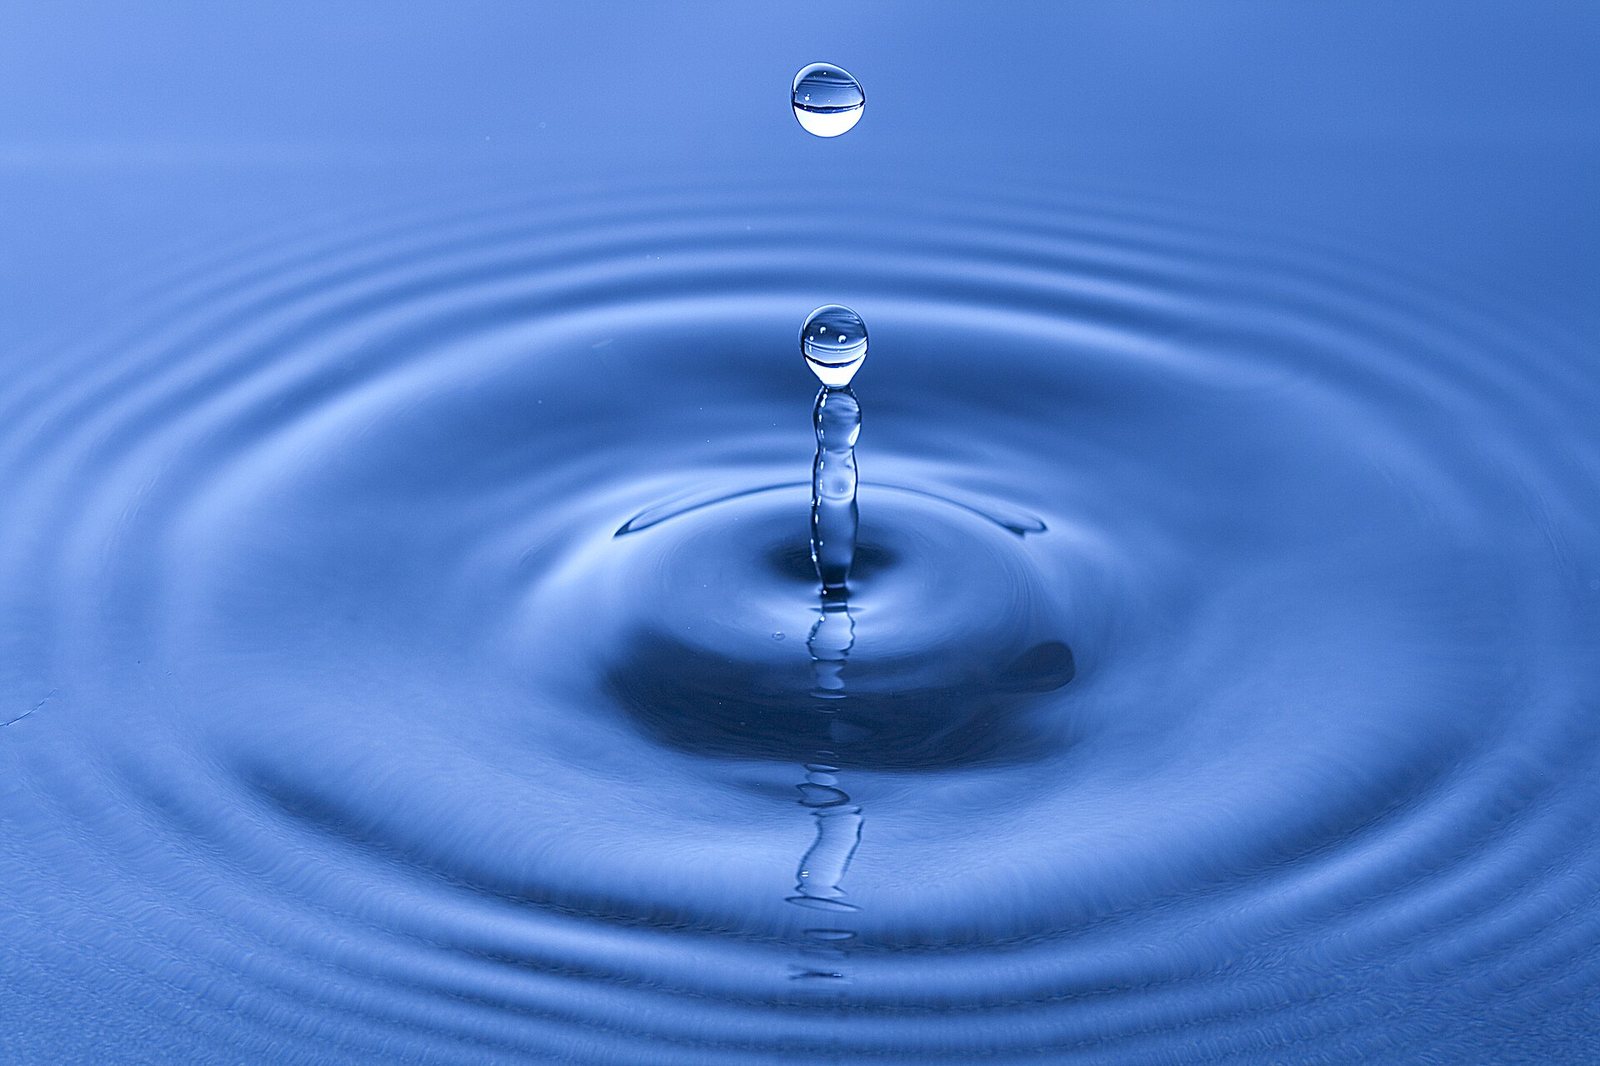
水这类流体,它能更细地还原被外力推着走的样子。
听起来像把十几个物理引擎焊在一起。实际上的难点在另一头:这些要素会互相影响。风推纸,纸变形,形变又改了受风面积,受力跟着变。一环扣一环,哪一环估错,后面全歪。
两个技术动作
实现上,他们做了两件事。
一是构建物理高斯渲染器,不同物理要素之间的交互和渲染都归它管。
二是多专家预测,把物理、像素、高斯三类信息分开预测,各干各的活。
这里有个词得拆开:高斯资产。
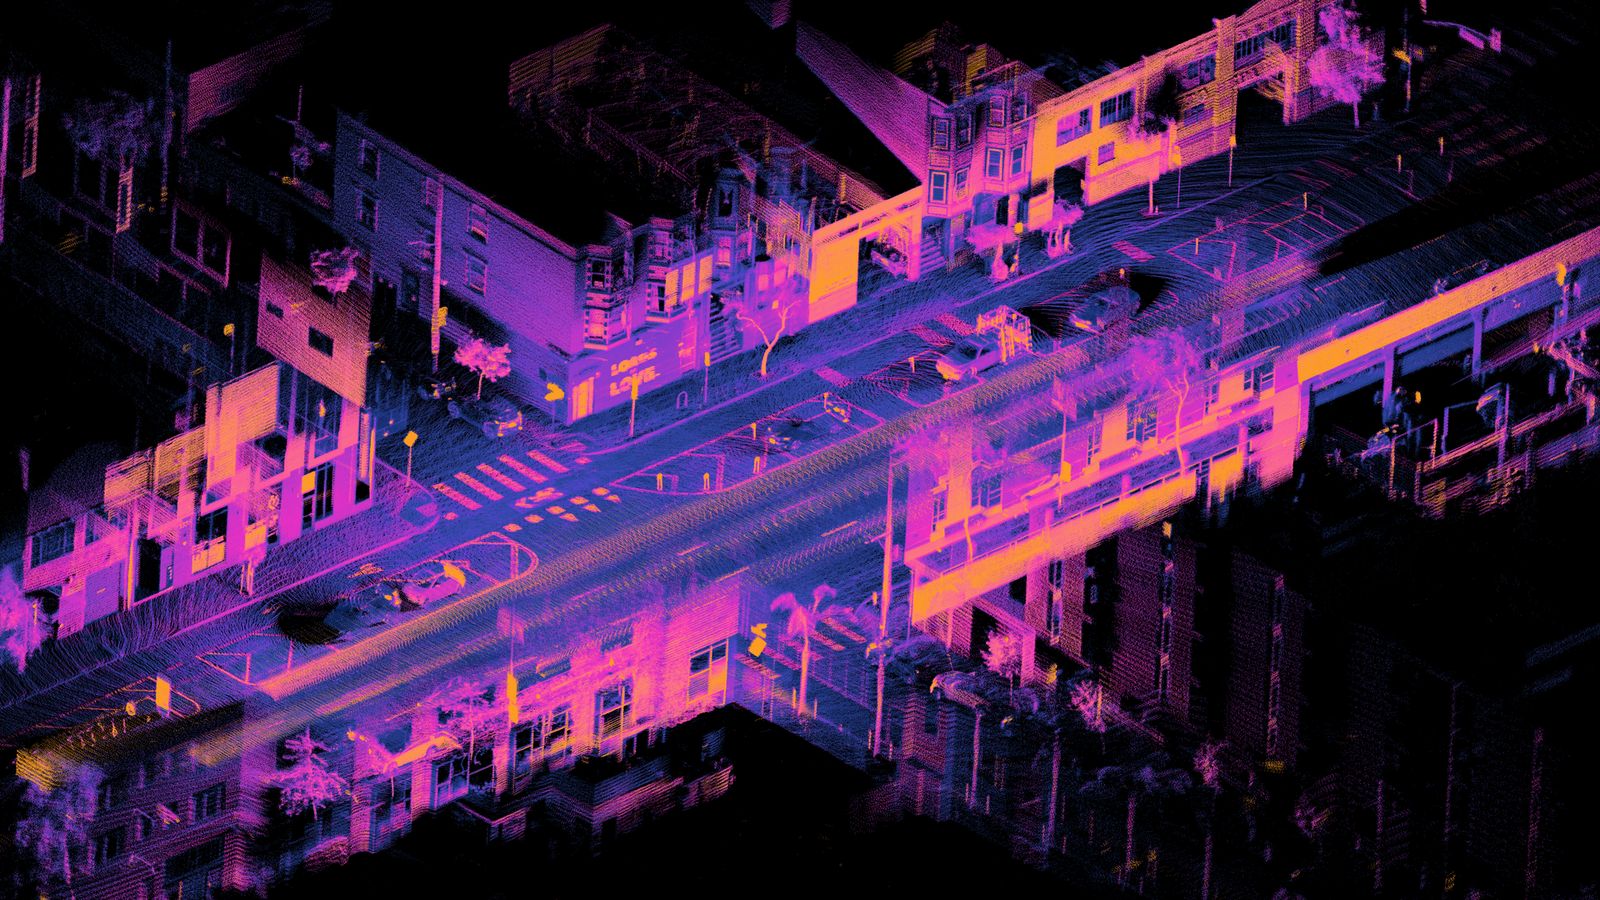
你可以把它想成一堆带位置、带形状、带外观的小团块。很多小团块凑一块,就把一个物体、一片环境表示出来。4D 再多记一层,这些东西随时间怎么动。
生成完的东西,能存下来接着改
这是它和「生成一段视频」最大的区别。
生成的场景可以输出成 3D/4D 高斯资产,存住,接着编辑、渲染,反复调用。
一段视频放完就完了。一份资产能进游戏引擎、影视制作系统、机器人仿真平台,改机位、换天气、挪障碍物。
官方演示里,它根据一幅古画生成了一座可以走进去的古代街市。画里的店铺、街巷、行人和车船,变成可编辑、可交互的场景。
渲染速度上,3D/4D 高斯资产能跑到 500 FPS,手机端相关渲染测试大约 100 FPS。
50 帧到 70 帧,成本三成
魔芯和华为团队在国产 NPU 上磨了将近一年。
MoWorld 1.0 最高约 50 FPS 实时视频推理。2.0 提到约 70 FPS,提升约 40%。
怎么提上去的:把不同的计算任务拆开,交给多张 NPU 并行跑。场景解码、主干生成这些活分到多卡上。多卡之间的调度也重写了,减少显存在数据来回搬运上的浪费。
另外优化了稀疏注意力,用了混合精度量化和生成算子融合。
成本这边,官方说推理成本最低能压到同规模 GPU 方案的 30%。
FPS 这数看着枯燥,其实很实在。机器人要练手,得有个能立刻反应的环境。环境慢半拍,练出来的动作就是错的。
已经进了手机
今年 10 月,华为新款手机发布会上亮相的「摸小宠」,就是 MoWorld 2.0 的终端应用。
用户上传几张宠物照片,生成宠物的 4D 数字分身,能转角度看,还能互动。
背后是约 6 亿参数的端侧模型,在昇腾平台训练,部署到麒麟芯片的手机上推理。手机端负责渲染和交互。
钱也在往里走。今年他们连续完成 5 轮融资,总额 20 亿元,估值接近百亿。团队从五六十人扩到两百多人。
发布当天,一起亮相的还有具身智能、文化旅游、时空地理信息三个方向的国家人工智能应用中试基地。后续合作围绕三件事:交互仿真与机器人训练、文化数字资产与沉浸式体验、三维数据生产和大场景重建。
它没说的那几件事
说完好的,说得不好听的。
它和真实物理引擎比,误差多大?通稿没提,【暂无相关资料】。
训练用了多少卡、多少数据?也没给。
那十几种物理要素,各自的精度指标是多少?还是没写。
我手上没有设备,也没实测。这篇只能讲机制,替它打包票做不到。
【个人看法】这套东西眼下最值钱的地方,未必是「生成好看的视频」。是它把场景变成了能存、能改、能反复折腾的资产。机器人训练要环境,文化资产要底子,这两件事靠一段 mp4 干不成。
至于「它是不是真懂了物理」,那是另一个问题,得等有人拿它和物理引擎做逐帧比对才知道。
最后问你一句
判断一个世界模型行不行,不用看演示有多炫。
你就想一件事:把书签换成一根绳、一杯水、一件软衣服,它还能不能算对。
能,那叫模型。不能,那叫特效。
觉得这篇讲明白了,转给那个总说「AI 不就是背数据」的朋友。