国庆那几天,OpenRouter 榜上多了一个没名字的模型。Space Bunny,中文直译是玉兔。没有人认领它,它就那么排在前排,压着一批有名字的大模型。
节后答案落地。
是 MiniMax 的 M3.1 Flash。
这个结果有点出乎意料,MiniMax 这两年在视频和多模态上声量很大,纯文本这条线安静了挺久。
输入 1 块,输出 4 块
输入每百万 token 1 元,输出每百万 token 4 元,缓存读取 0.1 元。按官方口径,综合成本压到上一代 M3 的三成。原来花十块钱的活,现在三块。
这个价位落在国产模型里最低的一档。四块钱一百万 token 的输出价,过去两年没出现过。我不太想用「打穿」这种词,可数字摆在那里。
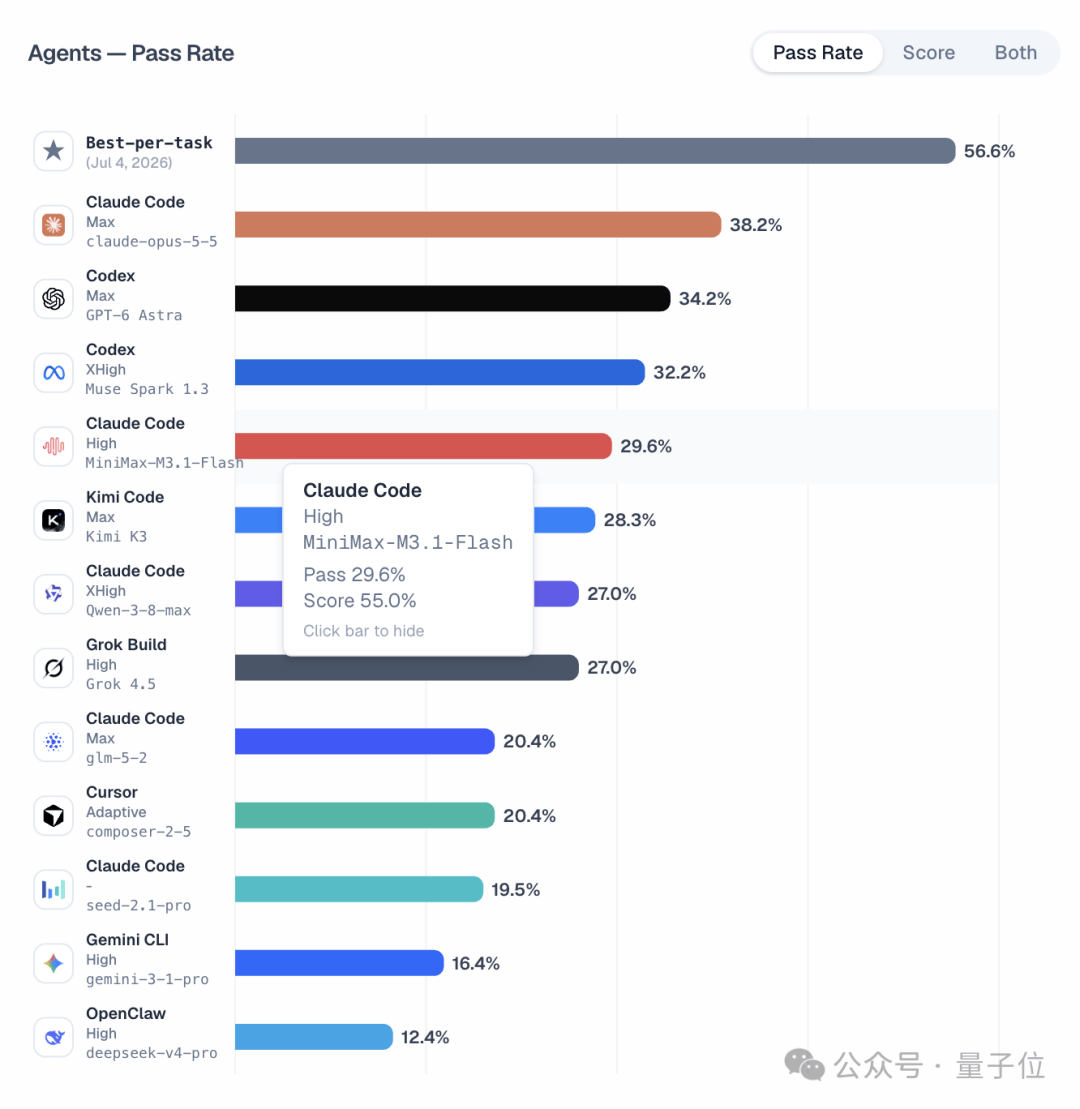
ALE 29.6%,国产第一
Agents' Last Exam,业内简称 ALE。名字直译过来,是给 agent 的最后一场考试。题目是长链条的真实任务,目前没人摸到满分。M3.1 Flash 拿到 29.6%,国产第一。
29.6 单看不高。
不过它得放在这道题里比,不能当成百分制的一次及格线来看。Artificial Analysis 给的综合指数是 43 分。
DeepSWE v1.1 的成绩是 73.7%,压过了 GPT-6.1 Sol、Claude Opus 5、Claude Fable 5,前面只剩 DeepSeek V4.1 Flash 1017 的 77 分。伯克利主导的 CyberGym 上它拿 82.2,同台 GLM-5.3 是 84.5,GPT-5.6 Sol 是 83.6。
差了半档,但已经在同一个台阶上。
横轴是成本的那张图
分数只能说明它聪明,说明不了别的。
下面这张图的横轴是平均单任务成本,单位人民币,对数刻度;纵轴是得分。成本低的在左边,得分高的在上面,M3.1 Flash 落在左上角。
便宜,分数还不低。
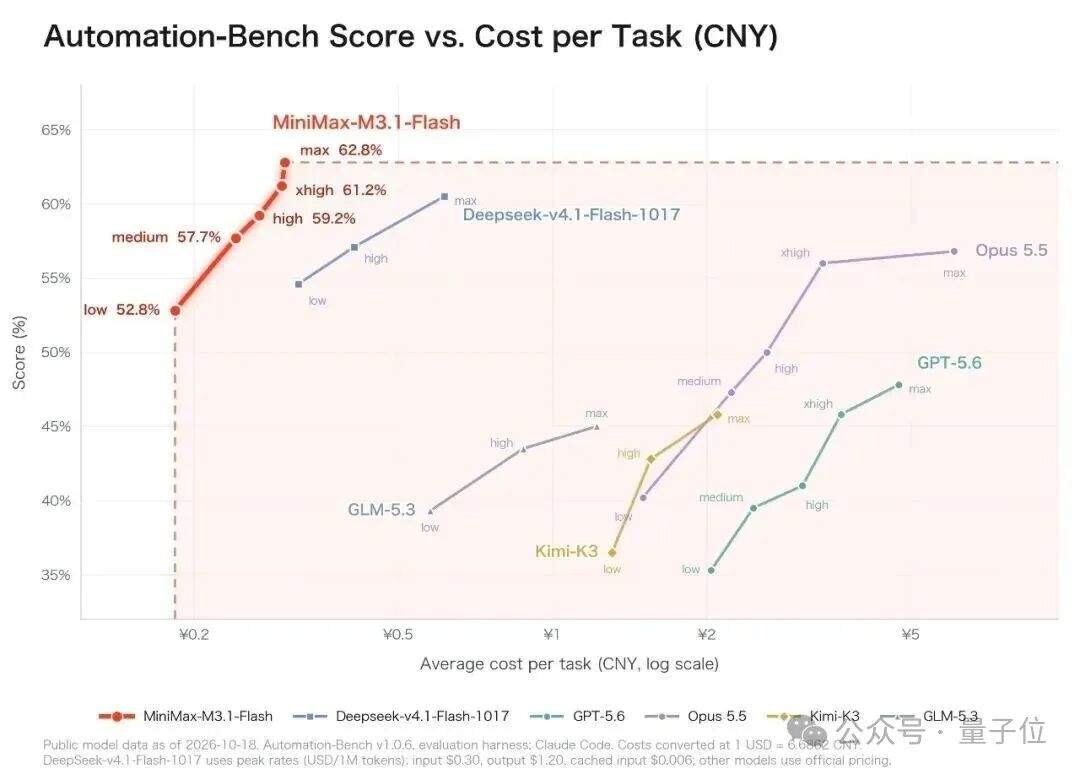
这个位置平时是空着的。
市面上的模型要么便宜但笨,要么聪明但贵。两个坐标同时压低的情况很少见。
Zapier 开源的 AutomationBench-AA 里,它单任务成本不到 0.05 美元。五美分跑完一条跨销售、营销、客服、财务的自动化流程。BankerToolBench 76.2 分,和 Claude Opus 5 并列。OSWorld V2 61.7 分,考的是真实桌面操作。输出速度最快 200 以上 TPS。
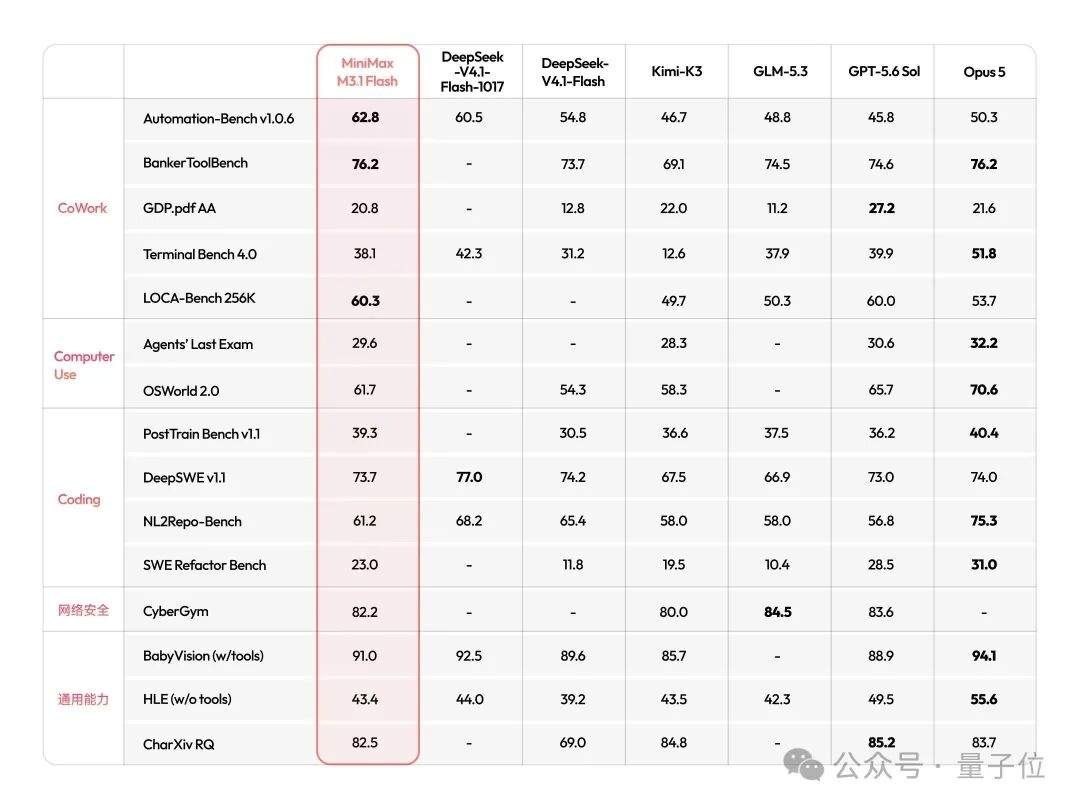
便宜。快。分数不低。这三样同时成立,过去两年不常见。
Flash 这个后缀不是装饰
它意味着小参数、低延迟、低成本,代价落在深度推理上。
ALE 29.6% 是国产第一,可离满分还差得远。复杂代码重构、多步逻辑推演这类活,它大概率打不过那些大块头。
榜单本身也有问题。
这些基准大多是公开题库,模型训练时见没见过类似题目,外部没有办法验证。匿名上榜这件事也挺说明情况:先挂个马甲试水温,风评好就认领,风评差就当没发过。这套玩法今年出现不止一次。
我的态度是把榜单当筛子,别当结论。
真要上线,拿自己业务里一百条真实任务跑一遍,比看十个榜有用。【本人未实测】这个模型我没跑过,只能给方法,给不了结果。
普通人能感受到的变化
输入一块钱一百万 token 之后,很多以前因为成本被绕开的用法,重新算得过账了。两百页的招标文件一次性丢进去,成本低到可以忽略。
这里变的其实是心理门槛。
模型能力提升有限,价格掉下来之后,人才敢放开用。账单不再让人犹豫,AI 才会从「偶尔用用」变成「随手就用」。
紧张的是做产品的
便宜和强只能二选一,这个默认前提维持了两年。
贵的有贵的道理,便宜有便宜的局限,这条线一直都在。现在有人把它往下压了一截。一些因为成本被砍掉的功能重新算得过账,企业 API 账单的占比会往下走,闭源厂商的定价空间又被挤了一次。
M3.1 Flash 能不能扛住所有生产场景,我不打包票,Flash 这两个字已经说明了它的定位。
可当 Flash 级别能打到大模型七成分数、只收三成价钱的时候,价格这条线就松动了。