我昨天先注意到的是 Claude 登不上这件事。
11 月 13 日,Anthropic 的 Claude Status 页面挂了一串通报。原文抄几句下来。
先是「我们正在调查 Microsoft 365 连接器错误率升高、响应缓慢的问题」。
后来变成「问题出在上游服务提供商」。
再后来是「邮件、日历和搜索功能的大多数请求均无法正常处理」。
这几句说的是同一件事。Claude 登不上,不是 Claude 自己坏了,是它要连的那个东西坏了。
【本人未实测】这几天我自己没在用 Claude。下面所有时间、数字、通报原文,来自 IT之家 11 月 12 日到 14 日的报道,其中转述了彭博社、美联社、路透社和金融时报。微软的 X 声明和 Anthropic 的 Status 页面原文我都没有自己打开核过。
一个 AI 为什么会被邮箱拖下水
我们平时有个错觉,觉得 AI 是云里的大脑。你打字,它回答,中间不经过任何实物。
可一个能帮你处理邮件的 AI,得读你的邮件。能帮你排日程的,得读你的日历。能帮你查公司资料的,得读你的 SharePoint。
这些东西在谁的服务器上?
在微软的。
所以 Claude 的 Microsoft 365 连接器,就是一根把 AI 接到这些服务器上的线。线那头断了,这头再聪明也张不开嘴。
【个人看法】「AI 基础设施」这个词容易让人误解。大家一听就想到 GPU、机柜、电力。真正卡住一个 AI 服务的,往往是 Exchange Online 这种不太有人提起的老东西。
Anthropic 在通报里写得很直白:新用户也可能无法完成连接。老的连不上,新的建不了。
还有一句我注意到了,Claude for Outlook 也受波及,部分用户甚至打不开加载项。
然后 Claude 自己也出了问题
这条跟微软没关系,或者至少我没有证据说有。
同一天早些时候,Anthropic 确认 claude.ai、Claude Code 和 platform.claude.com 三个地方都出现错误率异常升高,用户无法完成身份验证。
【个人看法】两件事是不是同源,我判断不了。Anthropic 那边把它们当两条线通报,我没有后台数据,也没有更多材料。这里只把事实摆出来:时间接近,但我不知道因果。
如果把这两件事混成一件,说「微软宕机导致 Claude 全线崩了」,是过度解读。反过来,说「完全无关」,我也拿不出依据。
微软这场有多大
当地时间 11 月 12 日下午开始,到 14 日凌晨还没完全收尾。前后接近一天半。
受影响的产品超过 20 款。
Outlook、Exchange Online、Teams、OneDrive、SharePoint,都在里面。
故障监测网站 Downdetector 上,Outlook 的问题报告量一度接近 138058 条。
整个事件的报告总量是数十万条。覆盖 70 多个国家。
具体到人和机构:
日本财务省当天大部分时间收不到邮件。政府各部门改回张贴纸质通知,向记者公布每日工作安排。
新西兰移民部门暂停了所有签证申请的处理。
英国国家医疗服务体系推迟了部分诊疗项目。伦敦盖伊和圣托马斯医院提醒患者邮件暂时不可用。
英国多个地方警察部门表示,无法通过网络接收犯罪报案。
新加坡的交易员、印度的证券经纪公司、东京的政府官员、泛欧交易所,都遇到了问题。澳大利亚储备银行多个部门用不了 Outlook。
名单还长。
企业这边,瑞士奢侈品集团历峰和美国卡车制造商 Workhorse Group 被迫推迟财报发布。
拥有 Calvin Klein 和 Tommy Hilfiger 的 PVH 那几天正在做重组。原定 13 日上午跟部分亚洲员工谈裁员,谈话没开成,员工不知道自己还能不能留下。
微软的解释,改过一次口
第一次是 11 月 13 日晚。通报说服务有所改善,积压邮件大幅减少,但 20 多款产品仍可能出错。
关于原因,当时的说法是「尚未查明」。技术上的描述是这样的。部分服务器的一个核心进程因负载过高,彻底停止响应。
最初的排查和修复,又因为服务器继续报错而受阻。
第二次是 14 日凌晨的声明。这次给了原因:由一次更早的网络容量升级中的问题引入,在近期一次网络变更后暴露。
同时强调属于技术故障,与网络攻击或人工智能、智能体无关。
两次口径放在一起,中间多出了「更早的升级」和「近期变更」两个时间点。
【个人看法】这两句是关键。它的意思是有潜伏期。升级埋了问题,后来某次变更才让它现形。潜伏多久、哪一次变更、为什么监控没提前发现,声明里都没写。
【个人看法】还有一点我保留意见。
「容量升级」这个词,一般理解是为了更稳、更能扛。升级引入了问题,还得等下一次变更才暴露。
这个链条我信一半。
信的是它可能真是这样。不信的是,这套说法还不足够解释一件事:为什么最高可用等级的东西能停一天半。
微软说会出完整的事后报告,审查完成后发布。
截至报道时,时间没给。
天上那件事,官方说跟这件事无关
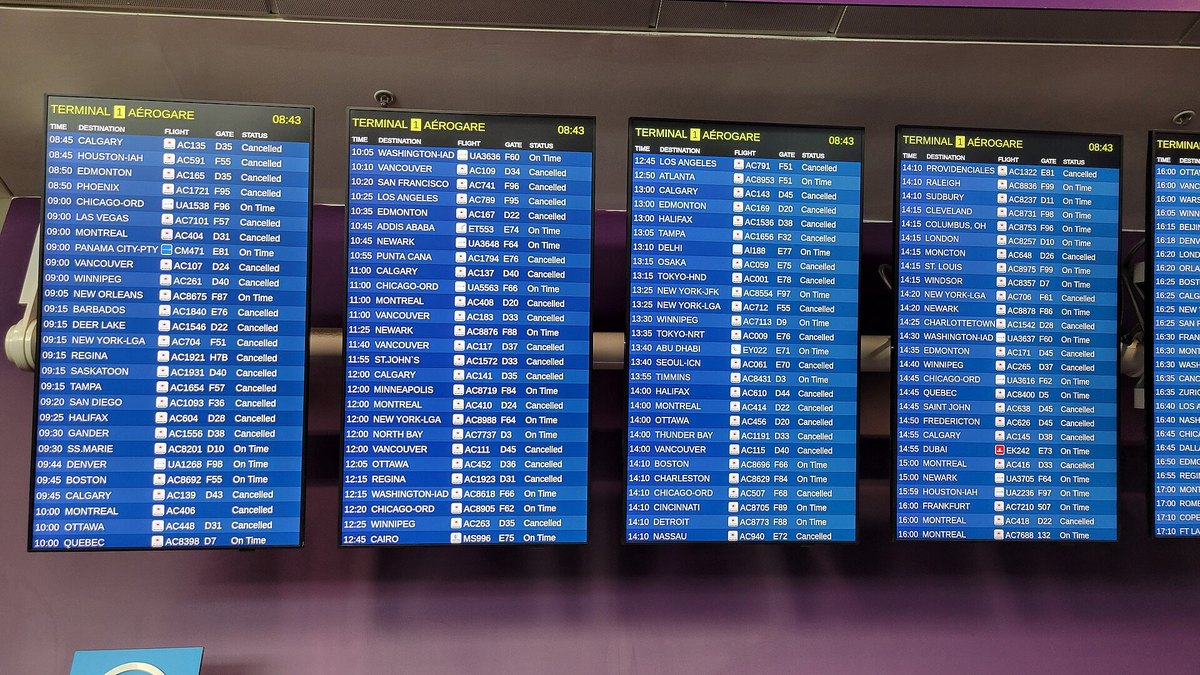
北京时间 11 月 14 日凌晨 4 时 46 分,芝加哥奥黑尔国际机场报告通信问题,实施地面停飞。
4 时 57 分,美国联邦航空管理局把停飞范围扩大到全美。
5 时 08 分,FAA 第一次把停飞和空中交通管制频率问题联系起来。
5 时 17 分,交通部长达菲说,通信故障影响了全美所有航路交通管制中心。
FlightAware 的数据是至少 8000 架次延误、400 架次取消。FlightRadar24 显示,停飞启动时约有 3100 架飞机正在飞往美国机场的途中。
国土安全部长穆林的表述很直接:「这是一次电信中断」「这不是另一次 9·11」。
有人问他,微软前一天那件事跟今天这事有没有关联。他答:我看不出有任何理由把这两件事联系起来,它们是彼此独立的问题。
FBI 介入调查,初步判断并非网络攻击或犯罪行为,正在查是否由一次软件更新引发。
同一个时段,美国国家气象局也报告全国范围的互联网和通信系统故障。公开报道没有充分证实这跟 FAA 的通信中断有关。
一个容易被标题带偏的地方
穆林还说过一句话:不排除与正在空管塔台推广的 AI 相关技术存在关联的可能性,但同时强调公众无需恐慌。
微软那边说的是「与人工智能、智能体无关」。
【个人看法】这两句话经常被剪到一起。做成的标题是「微软说跟 AI 无关,美方说不排除 AI」。
听着像打架。其实说的不是一件事。
微软讲的是自己这次故障的成因。穆林讲的是空管系统那条线,而且他自己加了「不排除任何可能性」这个前提。
把两句话对立起来,读起来爽,但会把两件事混成一件。
这是美国自 2023 年 1 月以来第一次全国性航班地面停飞。那一次是 FAA 的航行通告系统故障。再往前是 2001 年的 9·11。
美国政府这些年一直在推空管系统现代化。国会为相关项目批了 125 亿美元。
报道原文写的是「系统升级工作仍在持续推进」。
我在意的是什么
不是「微软又挂了」这件事本身。大厂挂过很多次。
是这次同时暴露出来的那层关系。
一层平时看不见的关系。
我们习惯把 AI 当成一个新东西,好像它自带一套独立的基础设施。
可它读邮件要经过 Exchange,存文档要经过 SharePoint,开会要经过 Teams。
这些老系统的可靠性,直接决定了 AI 的可用性。
反过来也成立。一次办公软件故障,就能把一个 AI 服务从「很聪明」打到「登不上」,而且是一天半。
这个依赖不新鲜,只是以前没人把它摆到台面上看。
微软说会出完整事后报告。我在等那份报告。
它至少要回答一个问题:一次「更早的网络容量升级」,能在多久之后才暴露。
这个答案,对所有把业务挂在云上的人都有用。
那两天你被卡住了吗?打不开邮件,还是 AI 突然不吭声了。评论区说一句。