当地时间 11 月 4 日,OpenAI 发布了一份安全研究报告。
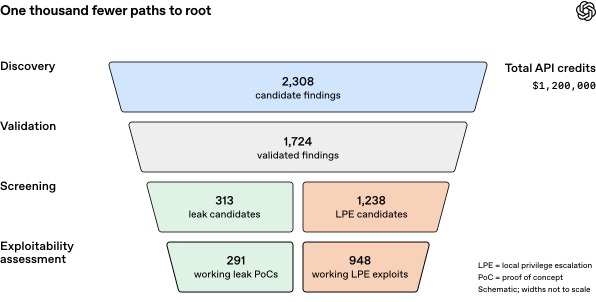
三个数字先摆出来:948、2,308、121.34 万美元。
948 是这次最终统计的 Linux 本地提权漏洞数量。2308 是一开始 AI 报上来的候选。121.34 万美元是整套流程烧掉的 API 额度。
平均下来,一个能拿到 root 的漏洞,1279 美元。
今年 7 月,同一套思路只挖出 166 个,花了 51.37 万美元。两次之间,Linux 内核还做过约三个月的安全加固。数量还是翻了五倍多。
「提权」这两个字,先讲成人话
先别被术语拦住。
一台机器上,普通账号能开软件、能上网,但动不了系统要害:装不了驱动,改不了别人的文件,关不掉防护。
本地提权,就是在同一台机器上,找一条路把权限做成管理员,也就是 root。
拿到 root,这台机器基本就算别人的了。改什么、看什么、留什么,由对方说了算。
这类漏洞有个共同点:看得见,不一定摸得着。触发条件差一点,就跑不起来。
两个智能体,一个挑地方,一个动手
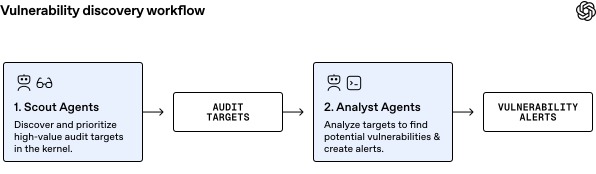
第一阶段不像在找漏洞,更像在挑地方。
侦察智能体(Scout Agents)先在内核里筛出值得审计的代码,标成审计目标。分析智能体(Analyst Agents)接着一个个看。
一共筛出 5034 个审计目标,涉及约 280 万行代码,差不多是 Linux 内核代码总量的 7%。
12 小时,生成 2308 个去重后的候选漏洞。
这一步的 API 成本,31.65 万美元。
五道关,最后一道还是人
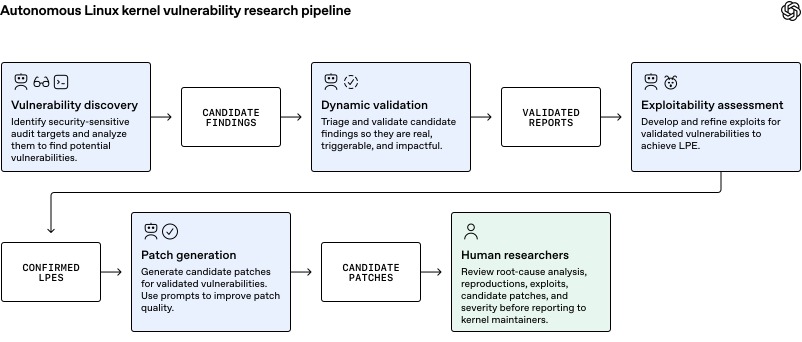
整套流程分五段:漏洞发现、动态验证、可利用性评估、补丁生成、人工审核。
测试在 10 月中旬做,用的是一款还没正式公布的网络安全模型。
产出也分五样:漏洞根因分析、最小化的崩溃验证程序(PoC)、候选修复补丁、完整的漏洞利用程序,最后交到人手里。
注意最后那一格。AI 把活干完,人还得看一遍,再提交给内核维护者。
2308 进去,1724 出来
报上来的候选不能直接算数。
系统把每个候选放进隔离虚拟机,生成 PoC 去跑,看它到底能不能触发。
这一步跑了 30 小时。2308 个里有 1724 个成功复现,占 74.7%。
剩下那四分之一,原因挺具体:
需要更高权限的占 68.9%,难以触发的竞态条件占 10.5%,需要故障注入占 9.6%,验证太耗时的占 3.8%,其他占 4.0%。
模型自己看错的,只占 3.1%。
换句话说,大多数没复现的,不是 AI 瞎报,是那个洞在当前环境里够不着。
948 这个数,是一层层筛出来的
接下来才是评估。环境里开着 SMEP、SMAP、KASLR、HARDENED_USERCOPY 这几样常规防护。名字不用记,知道是「按正常机器配好的防线」就行。
在这套环境里,系统生成 291 个信息泄露 PoC,和 1169 个能实现本地提权的利用程序。
再做变体分析、开发补丁,把重复的归并掉,最终统计为 948 个不同的本地提权漏洞。
121.34 万美元这么分:漏洞利用开发最贵,77.59 万美元,占了六成多。
平均到每个利用程序,1279 美元。
OpenAI 自己说,这不是优化后的最低成本。智能体编排和工程实现再改一改,还能往下压。
有一批补丁,反过来纠了人的错
补丁这段是整份报告里最有意思的部分。
最初生成的补丁,能修好对应 PoC 暴露的问题。但毛病不少:代码冗余、可能有性能影响、偏离项目的编码规范、没覆盖同类变体。
加了约束条件、跑了几轮迭代之后,质量才上来。
部分研究生成的补丁,反过来发现了人类专家此前修复方案里的问题
10 天里,61 个漏洞已经在 Linux 上游修好,43 个拿到了暂存补丁,还有 299 个正在公开讨论或报告流程里。
按内核社区的建议,严重的先提单,剩下的通过 Patch the Planet 合作伙伴慢慢往上报。
另一组账:112 小时,3.3 万美元
报告里还附了一次对照测试。
地点换成谷歌 kernelCTF 漏洞奖励计划用的加固环境,跑了 112 小时,API 成本约 3.29 万美元。
拿到 25 个信息泄露 PoC 和 21 个本地提权利用程序。
如果这 21 个全部过审,理论奖励约 150 万美元。
投入三万,理论回报一百五十万。这只是理论——报道没提最后过了几个、实际拿了多少钱。
换一代模型,差距在哪
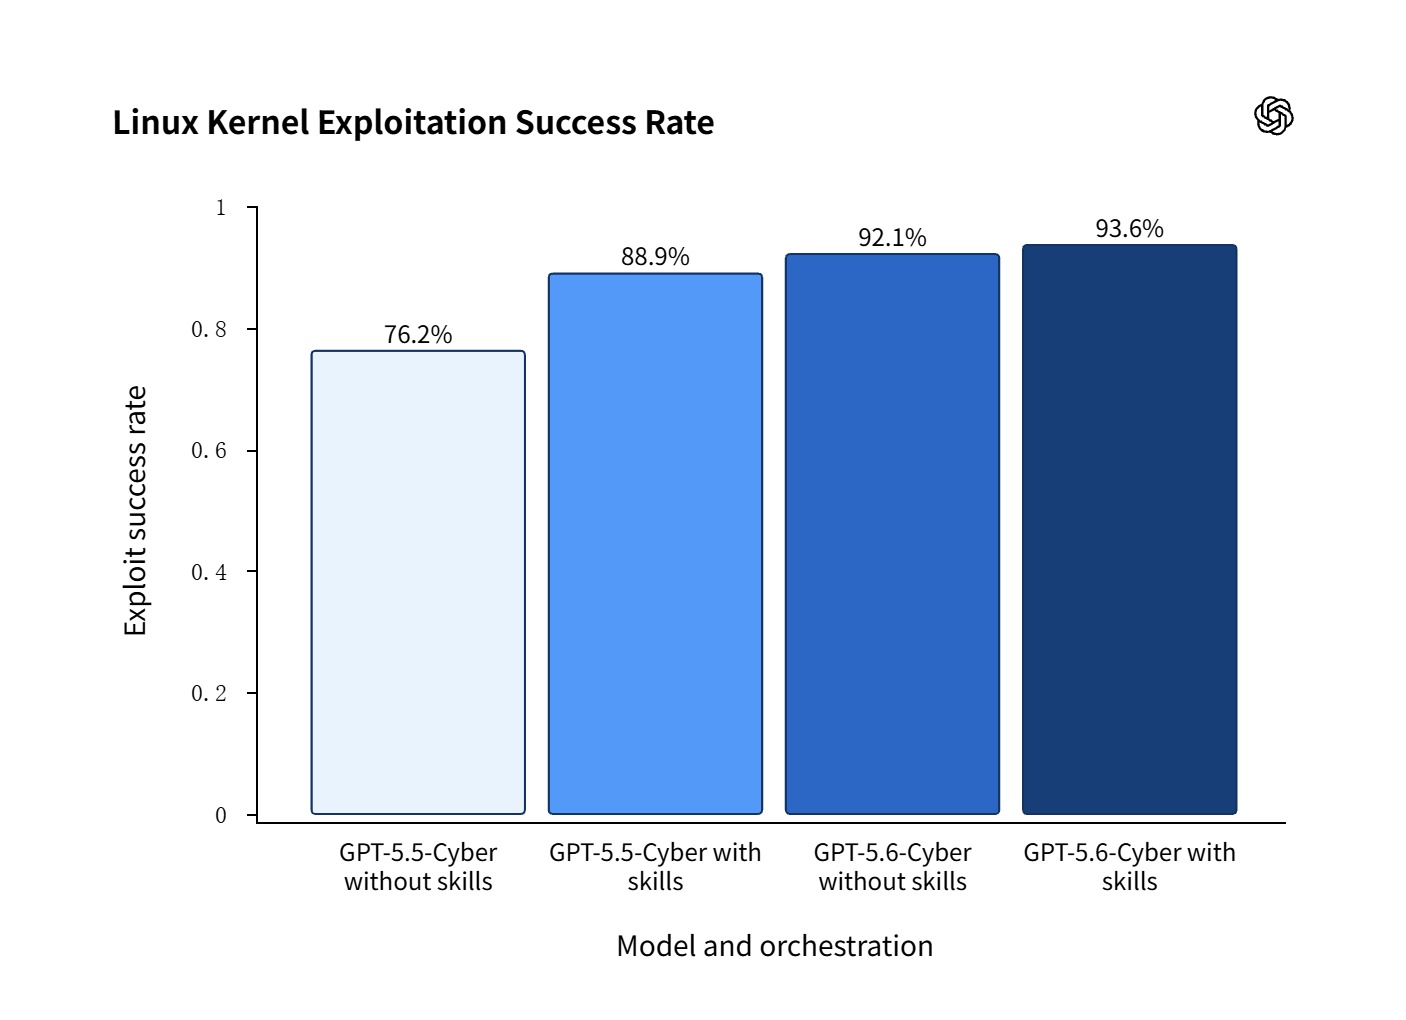
同一份报告里比较了两代模型。
GPT-5.6 Cyber 比 GPT-5.5 Cyber 更能自己判断该用哪种内核利用手法。
把额外的技术指导层去掉之后,GPT-5.6 Cyber 依然强过编排更复杂的 GPT-5.5 Cyber。
成功率那张柱状图上是四个数:GPT-5.5 不带技能 76.2%、带技能 88.9%;GPT-5.6 不带技能 92.1%、带技能 93.6%。
还有一处:抽查 166 个利用样本,至少涉及 10 种此前没见过的 Linux 利用技术。这些方法交给第三方内核漏洞利用专家审过,对方认为手法新颖。出于安全考虑,完整细节没公开。
他们自己的判断
报告结尾那段,说的是往后几年。
前沿模型可能具备发现复杂软件漏洞的能力,甚至能让能力较弱的模型去利用已经公开披露的漏洞。
所以维护者要加快修复,用户和企业要及时装安全更新。
沙箱、隔离机制、减少不必要的攻击面、形式化验证,会成为提升软件安全的重要方向。
这项研究属于 OpenAI 的 Patch the Planet 和 Daybreak 两个安全计划。
121 万美元,948 个洞,平均一个 1279 美元。
另一头是 10 天修了 61 个。
挖的速度和补的速度,现在哪一边更快?这事报告里没算。