PostgreSQL 19 推迟 21 天:AI 扫出的 bug,人来不及修
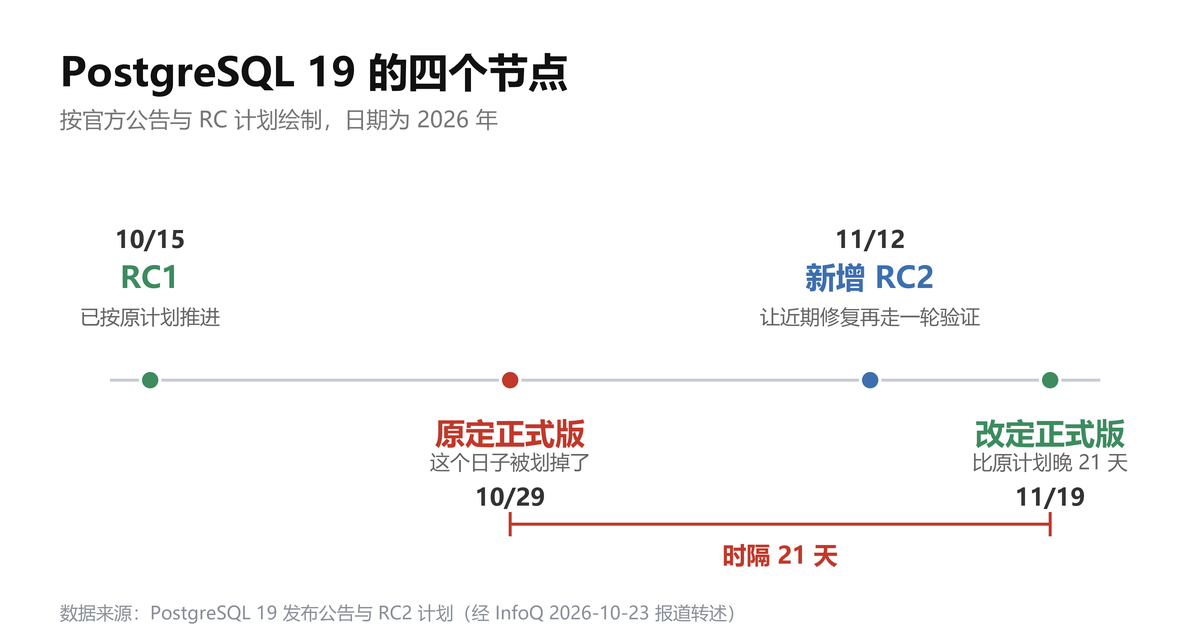
10 月 29 日这个日子,PostgreSQL 团队本来是留给 19 的。现在它被划掉,换成了 11 月 19 日。
中间还塞进一个 RC2,定在 11 月 12 日。
我看到这条消息的第一反应是“又一个被 AI 拖慢的项目”。读完核心提交者 Peter Eisentraut 的博文,这个判断得翻过来。
【原文数据】他那篇博文标题是 The reverts will continue until morale improves,发布于 2026 年 10 月 9 日。
先把四个日子摆出来
【原文数据】RC1 按原计划在 10 月 15 日推进。正式版从 10 月 29 日推迟到 11 月 19 日,延后 21 天。发布团队新增 RC2,理由是最近合进各维护分支的修复数量偏多,想让这批东西再走一轮社区验证。
官方把今年称作“不寻常的大版本发布周期”。
不是 AI 写出了烂代码
Peter 先否掉了一个很顺的猜测。他的结论是,这些问题大体上不是 vibe coding 造成的。
受影响并最终被撤回的功能,大多在 LLM 辅助编程和代码审查成熟之前就写完了。也就是说,不存在“开发者让 Claude、Codex 大批量生成 PostgreSQL 代码,然后在 Beta 阶段集中爆雷”这件事。
顺序是反的。是后来的 AI 审查工具变强了,回头去查以前按老流程写出来的代码。
【原文数据】他把发现的问题分成两类。一类真严重,属于架构层面,Beta 阶段短期内修不掉。另一类是长尾,单看都不严重,只在特定边缘条件下才触发。
第二类过去压根不会在发布前暴露。老流程是先发版,然后花几年时间,等真实用户撞上各种罕见组合,再一个个打补丁。Peter 估计,这里面不少问题的原定浮出时间是接下来 5 年。
现在它们几天到几周内被扫出来了。
40 份报告,每个改 3 行
【原文数据】他举了个例子。开发者突然面对大约 40 份缺陷报告。假设平均每个只需要改 3 行代码,改代码本身几分钟就完。
但处理每一个都有固定成本:读报告、定位、判断、写测试、提交、回信。40 份叠起来,人的时间就没了。
Peter 把这个现象概括成一句话,有效质量门槛被抬高了。
这些功能提交的时候,行业还没有今天这样的审查能力。等 19 准备发版,新工具已经能看到过去看不到的东西。原本够格的代码,在新标准下突然不够格。
【个人看法】这一段是整件事里最值得抄下来的一句。工具越强,交付反而越慢。慢的地方不在产出端,在验收端。
数据库偏偏最吃这一套
数据库这种软件特别容易撞上这类问题。
【原文数据】PG 有个特点,开发者期待功能能自由组合。一个 SQL 功能不只要在最普通的情况下跑通,还可能被塞进 domain、复合类型、分区表、视图、安全定义函数、触发器里,而这些能力本身还能继续嵌套。
Peter 举的组合是这样的:domain 套在复合类型上,复合类型里的字段本身又是 domain;domain 带非空约束;某个列被删过又重新加上;表分区 detach 后又按不同列顺序 attach;而这一整套又出现在一个视图里,而这个视图是从触发器中的 security-definer 函数调用的。
理论上都该正常工作。问题是人很难把所有组合枚举出来,更别说逐个手测。
【个人看法】看到这个例子我笑了一下,也理解了他们为什么选择推迟。这种路径靠人力穷举不完,只能让机器去撞。
Tom Lane 赌了一顿晚饭
8 月,社区成员 Robert Haas 做过一件事:让 Claude 根据 feature freeze 之后修复的 Bug 数量和类型,给 19 的补丁做风险评估。
【原文数据】SQL 属性图查询被列为高风险功能之一,当时已经历过 17 次修复。核心开发者 Tom Lane 说,如果这个功能按当时的状态进 19,他愿意赌一顿晚饭,认为发布后还会发现只能留到 20 才能彻底解决的问题。
结局是功能被撤回。
另一位社区成员提到,对这个功能启动 AI 审查之后,又发现了些严重问题,并且做了人工确认。AI 在这次发布周期里不只是“聊天式代码评论员”,它已经进了真实开源项目的风险筛查环节。
AI 也不是唯一原因
Peter 自己强调过这点,我不想把它写成“AI 背锅”或者“AI 救场”。
【原文数据】部分代码的质量和架构设计确实有问题。今年 4 月到 8 月,社区经历了一轮密集的安全问题处理,大量资深开发者都压在这上面,Beta 前期本该做的额外评审和测试被挤掉了。等他们回到 19,很多问题已经到发布周期的后段。PG 自身持续增长的复杂度,也是根子上的原因。
【原文数据】最终撤回的重要功能是 8 到 10 项,看统计口径。不少预计修正后进 PG 20,代表案例就是 SQL/PGQ。有意思的是,社区此前一度认为 PG 20 主要用来修 Bug、不会有太多新功能,现在情况倒过来了:19 撤下来的这批,反倒给 20 留了一批接近完成的候选。
19 本身也没缩成小版本。【原文数据】里面仍有 REPACK CONCURRENTLY、序列的逻辑复制、通过 pg_plan_advice 实现的查询规划器提示。Peter 说,经过这轮额外审查,他反而预计 19 会更稳。
另一派在担心什么
社区里很快分成两种声音。
【原文数据】一派认为瓶颈已经从“发现 Bug”挪到了“给 Bug 分类”。有人建议只把最严重的问题优先送人工。理由很直白:找漏洞和构造异常输入的成本下来了,修复速度没变,两头不匹配。以前安全研究者找一个复杂缺陷要几天甚至几周,AI 可以同时探很多条路,维护者还是只能一个一个确认。
另一派担心真假 Bug 一起涌来。
【原文数据】一位做数据工程的开发者说,他们内部的 AI 代码审查系统,即便模型能读到代码仓库、Confluence 和 JIRA 的上下文,大概只有 八分之一的报告最终被认定有效。换成更通用的审查机器人,比例还会低。另一位熟悉静态分析工具的人提到,误报本来就是自动化分析的老毛病,一旦累到十万级,要求人工百分百确认基本不现实。
也有反过来的例子。【原文数据】有人让 AI 对一个稳定跑了约 10 年的客户系统做集中审查,覆盖脚本、任务和配置,结果发现 39 个问题,其中 30 个被确认真是 Bug,只是从来没被触发过。
【个人看法】那个八分之一让我印象最深。它说明 AI 审查目前还带着很重的噪音税,税是人工在付。
会不会有一天下不来台
【原文数据】有人提到“发布瘫痪”这个词。如果 AI 能从任何复杂代码库里不断挖出新的边缘问题,那理论上永远有下一个 Bug。项目该修到什么程度才算能发,未来可能比“AI 能找到多少 Bug”更难回答。
给出的建议是:与其追求在一个版本里消灭所有问题,不如系统化登记、分级,纳入后续路线。否则没有任何大型软件能做到真正意义上的零缺陷。
【个人看法】这个建议听着务实,但它其实是个组织问题,不是技术问题。谁来定级、谁签字放行、放行之后出事了怎么算,这些都没标准。
我的看法
我更愿意把这件事看成一次位置调换。
过去行业卡的是“能不能发现足够多的问题”,现在卡的是“人有没有足够的判断力去处理这些问题”。三行代码就能修掉的边缘缺陷,值不值得为它推迟一个重要功能。AI 交上来几十条,哪几条意味着架构本身要重写。机器可以没日没夜地找异常,一款软件到底要到什么程度才算够好。
【个人看法】这些问题没有技术答案。它们本来就是人的活,AI 只是把它们从后台推到了台面上。
只推迟 21 天,不算大事。但它露出来的那个新瓶颈,可能比 21 天长。
资料来源
InfoQ《PostgreSQL 19 发不出来?AI“找茬”太快,人类修 Bug 的速度跟不上了》,2026-10-23
https://www.infoq.cn/article/Q6mgHWCSqV6KeZzee3NT
Peter Eisentraut 博文
https://peter.eisentraut.org/blog/2026/10/09/the-reverts-will-continue-until-morale-improves
The Register 报道
https://www.theregister.com/databases/2026/10/16/postgres-19-delayed-after-ai-reviewers-find-more-bugs-than-humans-can-fix/5303471
本文为公开报道整理,文中标注【原文数据】的内容来自上述来源,标注【个人看法】的是作者判断。作者没有参与 PostgreSQL 项目,也没有相关内部信息。