-
 PostgreSQL 19 推迟 21 天:AI 扫出的 bug,人来不及修
PostgreSQL 19 从 10 月 29 日推迟到 11 月 19 日,新增 RC2,8 到 10 项重要功能被撤回。核心提交者 Peter Eisentraut 的说法跟“AI 写出烂代码”相反:问题在于 AI 审查变强之后,原本要 5 年才逐渐浮出的边缘缺陷在几周内被集中扫出来,有效质量门槛被抬高了。
-
 中国电信开源 29B 意图模型:总分赢 9 分,实体检测只赢 1 分
中国电信星辰实验室开源 29B 意图理解模型 Xing4.0-29B-Intent,把一句人话拆成「要干什么」和「具体要什么」。官方评测总分 58,比参评通用大模型的最高分 49 高 9 分。但四类任务拆开看,意图分类领先 17 分,实体检测只领先 1 分。本文还把原文第二张表里一个容易被忽略的现象拎出来:同一个模型换个答法,单选得分从 60 掉到 24,负例从 35 掉到 5。
-
 5520 亿把 1.6 万亿顶掉了,DeepSeek 换掉了自家旗舰
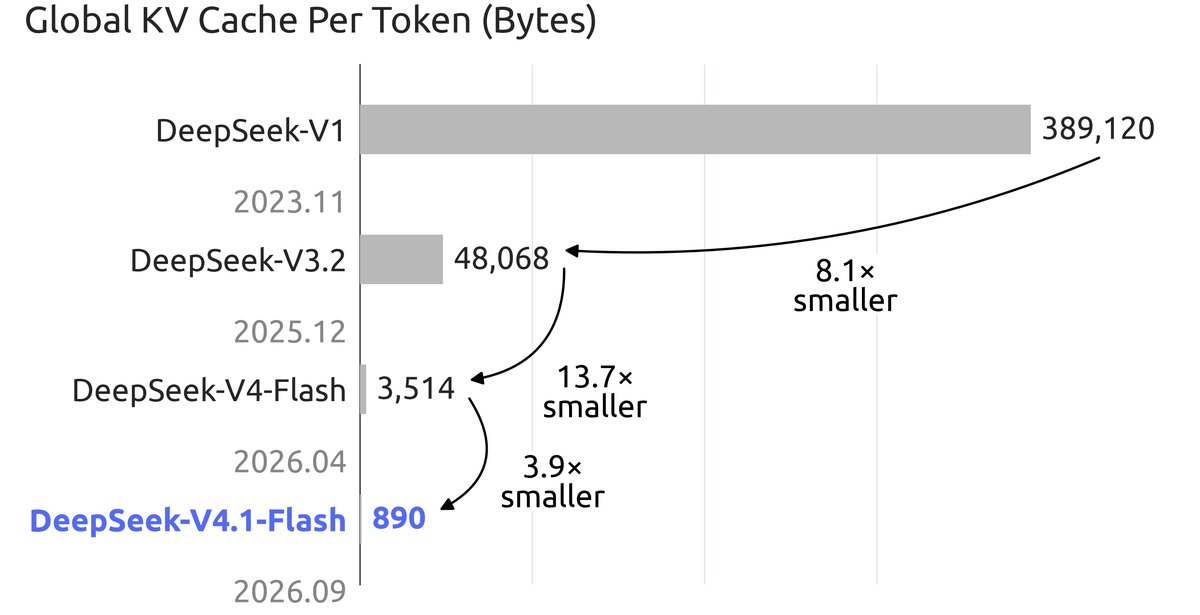
DeepSeek 9 月 10 日发布 V4.1 Flash,并在 4 天后把请求从自家旗舰 V4 Pro 转到它身上。被顶掉的旗舰骨干参数 1.6T,顶上来的这个只有 552B。官方给的理由不是更聪明,而是每 token 的全局 KV 缓存从 3514 字节压到 890 字节,对 HBM 的需求只剩四分之一。同时它输在哪几项也写在评测表上:世界知识、多语、纯数学、长文本理解。
-
 每次跟AI对话都要重讲一遍,这事终于有人管了
腾讯混元开源智能体记忆框架 Hy Memory 2.0,开源专用模型、记忆框架与 MemHub 应用三层能力。框架层负责聊天、工作、代码三类记忆的存储、更新与进化,官方称是业界首个提出工作记忆与代码记忆的框架。官方称在 4 个 Benchmark 上对比 Mem0、MemOS、EverOS 等开源框架均列第一;专用模型 Hy-Memory-30A3B 约 3B 激活参数,宏观平均 55.49%,高于 Claude Opus 5 的 54.62%。SDK 与 MemHub 已在 GitHub 开源,模型权重发布在 Hugging Face。
-
 英伟达这次没堆参数,反而砍到120亿
英伟达发布开放多模态模型 Nemotron 3.5 Super VL,面向需要持续运行、执行多步骤任务的 AI 智能体。MoE 架构,总参数 1200 亿、激活 120 亿,官方称单张 GPU 上执行智能体任务时吞吐量最高可达同规模其他开放模型的 5 倍。企业案例:Scale AI 为 Skydance 定制供应商信用处理智能体,推理成本预计降 97.5%;Ramp 做收据转结构化数据,吞吐最高提升 50%。同时推出端侧 Bolt 74B-A9B,原生 2 位量化压缩至 24GB。
-
 B站把 150 种语言的翻译模型开源了
9 月 30 日,哔哩哔哩 Index LLM 团队发布 Index-Translate 翻译模型家族,2B、9B、35B-A3B(预览版)权重在 Hugging Face 与 ModelScope 开放,覆盖 150 种语言。配套的 Index-Echo 能照着源说话人的声音生成字幕或配音,Index-Homura 能按目标音节数调整译文,Index-NativeLong 管长文档里称呼前后一致。这篇借一个字幕组朋友的眼睛,讲清这套东西解决了哪些老问题。
-
 OpenAI 的收费单上,第一次出现了中国模型
9 月 30 日,美国 AI 基础设施公司 Baseten 与 OpenAI 合作,企业用户在 Codex 里可以调用 Kimi K3、GLM 5.3 等开源模型,这是中国开源模型第一次进入 OpenAI 的企业采购体系。这篇讲清这条消息的分量,以及写代码的上班族接下来会感觉到什么。
-
 开源和闭源大模型差在哪?看完这篇不再纠结
我同事老周,上个月刚把公司客服系统换成大模型。 折腾了三天,最后跑来问我一句话:到底选开源的还是闭源的? 他不是技术出身,就看两样东西,一是好不好用,二是一个月花多少钱。 我给他算了一笔账,他愣了半天。 一枚硬币立在桌面上 先说个反常识的 很多人以为开源的就是免费的。 真不是。 开源模型本身不要钱,
-
 普通电脑也能跑开源大模型?硬件和步骤一次讲清
我同事老周,上周干了件傻事。 他花两千多买了张二手显卡,又熬了三个通宵,就为了在自己那台破台式机上跑一个「小模型」。 结果跑起来了,回答一句话要等四十秒。 他媳妇看他盯屏幕那表情,问他是不是欠了网贷。 老周跟我说这事的时候还嘴硬,说等显卡降价就换。我说你先别换,你连这东西为啥慢都没搞明白。 一台老式