Agent 一跑起来,先卡住的居然是 CPU
去年聊 AI 算力,话题基本绕不开有多少张卡。最近翻到 Arm 的一份技术分享,角度换了,谈的是 CPU。
提出这个说法的是 Arm 云 AI 解决方案架构总监 Ravi Malhotra。
他的判断是,智能体 AI 正在改变 CPU 性能的评价逻辑。Arm 此前发布了一套新评估方法,把工具调用、任务编排、推理支持和端到端任务执行纳入 CPU 性能评价,一起探索的企业包括富士通、Meta、OpenAI。
先弄清一件事:Agent 不是一直在吐 Token
【原文数据】软件智能体的典型流程是这样。用户提需求,模型分析并生成代码,然后智能体要建文件、调编译器、跑测试、看错误,必要时把结果喂回模型,进入下一轮。
中间不是连续生成 Token,而是在模型推理和外部操作之间来回切。
Ravi 把这类负载拆成两块。推理与规划,主要压在加速器上。工具调用与编排,包括代码执行、数据库访问、沙箱运行,大量落在 CPU 上。
【原文数据】他说 Agent 时代 CPU 的关键任务有三类:把生成的 Token 变成动作,为推理提供数据和上下文,负责工作流编排与沙箱隔离。
GPU 为什么会空转
【原文数据】软件开发场景里,编译和测试本身吃 CPU。CPU 排不完队,后面的推理只能等。贵的加速器跟着闲着,这笔账不好算。
Ravi 的原话是,CPU 得尽快把自己那份活干完,把控制权交回给加速器。“如果 CPU 不够快,更昂贵的 GPU 就会处于闲置状态,而这是没有人希望看到的结果。”
【个人看法】这句话对做采购的人最有用。加卡之前先看一眼 CPU 队列,可能比再买八张卡划算。
【原文数据】他也提醒,不是 Agent 越复杂 CPU 负载就越大。不同任务里推理、工具调用、外部等待的占比差得很远。真正要看的是,CPU 是不是卡在整条链的关键路径上。
五类 Agent,CPU 需求差得远
【原文数据】他把代表性应用归成五类:软件工程、企业自动化、科学与金融研究、个人助理、机器人技术。
软件开发类任务长,要编译、测试、做代码分析,吃单核性能和内存访问效率。这类场景里,让单个任务更快完成,可能比多开几个 Agent 更值。
企业自动化是另一回事。客服、库存、供应链里的智能体,频繁访问数据库、调 API、执行短业务操作。单次开销不高,但同时跑的量可能很大,重点转到并发、吞吐和单位资源的请求数。
个人助理介于两者之间。一次日程查询或网页访问很短,可成千上万个短任务同时来,压的是资源管理、I/O 和调度。
【原文数据】针对 Terminal-Bench、SWE-bench 这类软件开发负载,Ravi 说每个 CPU 核心跑 一到两个 Agent 可能就够了。继续加并发能提高利用率,但单个任务的完成时间可能超出 SLA。反过来,企业自动化和个人助理这类短任务,单核上能承载更多并发实例。
【个人看法】最高吞吐量不等于最好的服务能力,这句我认。带过线上服务的人大概都被这个坑过:QPS 上去了,超时率也上去了。到头来用户只记得卡。
那个 1.99 倍,得看清条件
这是他分享里数字最硬的一段,也是最需要小心的部分。
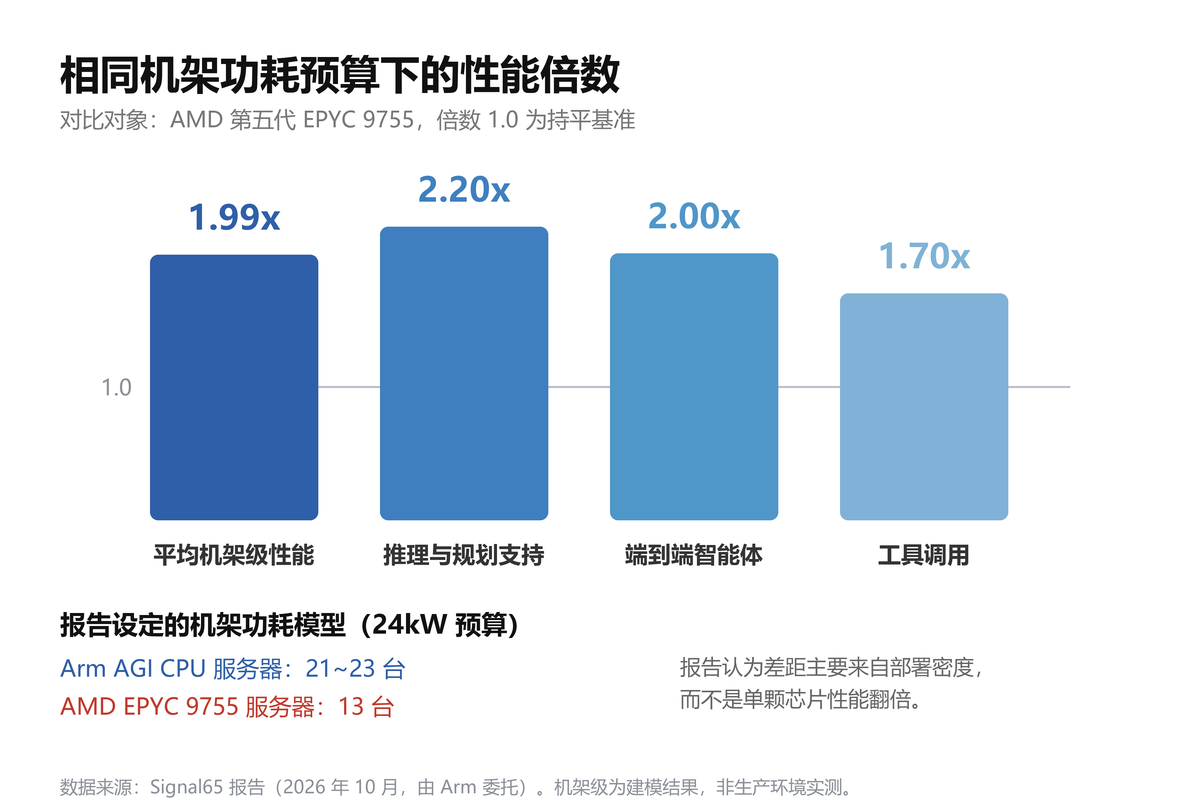
【原文数据】10 月发布的一份 Signal65 研究报告,比较了 Arm AGI CPU 和 AMD 第五代 EPYC 9755。测试覆盖 Web 服务、数据库、向量检索、模型服务支持、智能体任务执行。
结论是,在设定的相同机架功耗预算下,Arm AGI CPU 的平均机架级性能约为对比平台的 1.99 倍。拆开看,工具调用类约 1.7 倍,推理与规划支持类约 2.2 倍,端到端智能体相关负载约 2 倍。
【原文数据】真正的变量是部署密度加上单芯片性能,单颗芯片本身并没有快两倍。按这份报告的机架功耗模型,24kW 预算下能放 21 到 23 台 Arm AGI CPU 服务器,对比配置是 13 台 EPYC 9755。
然后是我必须原样转述的一句。
【原文数据】报告里的机架级结果,是基于芯片实测结果和服务器额定功耗做的建模,不是完整生产环境里的机架实测。研究由 Arm 委托开展,最终性能和成本表现还需要结合实际部署验证。
【个人看法】1.99 可以看,但看的时候得带着两个前提:建模,委托。
换成 Arm 的对手去做同样的测试,配置和权重一改,排名可能就变。报告自己也说了,不同机构的软件、拓扑、并发规模、统计口径并不一样,横向比很难。
沙箱不是免费的
【原文数据】Agent 带来的另一块成本容易被低估:执行环境。能实际改文件、跑代码、访问外部系统的智能体,通常要在受控环境里跑。Docker、Firecracker、gVisor 这些容器和隔离技术因此成了基础设施的一部分。
隔离要花资源。这笔开销藏在吞吐里,不看报表看不出来。
每次建执行环境都吃 CPU、内存和时间。长任务的软件智能体可以把这笔成本摊薄,短任务不行,沙箱启动延迟会直接压到用户体验和系统吞吐上。
Signal65 那份研究专门测了沙箱的冷启动、热启动和高并发开销。
编排系统同样关键。硬件给了你一堆核心,调度层分不出任务、复用不了执行环境、处理不了 Agent 之间的资源竞争,理论并发也变不成有效吞吐。
还没有统一跑分
【原文数据】Arm、AMD、Intel 和研究机构都在建自己的评估方法。问题是软件、部署拓扑、并发规模、统计口径各不相同。数字放一起比不了,谁都想要那个唯一的分数。
Signal65 另一项针对 Intel Xeon 6 和 AMD EPYC 云实例的研究,用 Terminal-Bench 2 的记录回放方式,尽量消掉模型推理结果波动的影响。
重点测的是 CPU 承担的命令执行、容器任务和编排。结论同样是不同处理器在延迟和成本效率上表现不一致。
【原文数据】Ravi 的说法是,Arm 提的是评测方法论,不是行业标准,也不建议给不同智能体场景设统一权重。组件测试和端到端测试要结合,企业按自己的业务选指标。
他也承认,现在的测试大多集中在 CPU 承担的那部分,CPU 与 GPU 之间的网络传输、跨节点调度,以及 DPU 在数据搬运和服务卸载上的作用,还没覆盖全。
我的看法
【个人看法】这份材料里真正能落地的,是那个 1.99 背后的衡量方式。数字本身用不太上。
以前问的是这张卡每秒能吐多少 Token。现在该问的是,修完一次代码、处理一张工单、跑完一条业务流程,要多少时间、多少资源、多少钱。
这两套问题指向不同的采购清单。前者让你继续加卡,后者可能让你先修 CPU 和编排。
【原文数据】Ravi 的收尾我同意:Agent 带来的变化落在协作效率上,谁也取代不了谁。GPU 管密集计算,CPU 管工具执行和编排,DPU 分担网络和存储。这三者接不上,任务就在等。
那个 1.99 倍我看完很快就忘了。记住的是另一句:CPU 不够快,贵的卡就在闲置。
资料来源
InfoQ《AI Agent 正在改写 CPU 的价值:当 Token 变成行动,算力竞争不再只是拼 GPU》,2026-10-23
https://www.infoq.cn/article/AkDgwN6h72cqUOJ35Zok
本文为公开报道整理。标注【原文数据】的内容来自上述来源,标注【个人看法】的是作者判断。作者没有实测过 Arm AGI CPU 或 EPYC 9755,也无法验证那份 Signal65 报告的建模参数。