中国电信开源了个 29B 的模型,专门干一件事:把一句人话拆成「要干什么」和「具体要什么」。
先说清楚它的出处。这个模型叫 Xing4.0-29B-Intent,是中国电信人工智能科技有限公司旗下星辰通用人工智能实验室做的,基于自家的 Xing4.0-29B-A4B 基座微调,已经开源,Apache 2.0 许可。下面的内容全部来自它的发布稿,我没有下载模型跑过,也没看到第三方复现。
一、这句话里有几个空要填
「帮我把卧室的灯调成暖黄。」一个人听到这句话,动手就完了。可业务系统不行,它得先把这句话拆成它认识的东西。
要控制的是灯光,这是一个类别。哪个房间,卧室。什么设备,灯。调成什么状态,暖黄。
光判断出「控制灯光」不够。后面三个参数拿不到,设备不知道该干嘛。
官方的说法把这两件事分得很清楚,判断类别相当于做选择题,抽取参数相当于做填空题。通用大模型做选择题还行,做填空题经常漏,它可能告诉你这是控制灯光,然后就没了。
而这个模型想同时干这两件事,输出一段固定字段的 JSON,下游直接拿去用。
二、为什么不用现成的通用大模型
它给了三个理由,我觉得都成立,但成立的程度不一样。
第一个是慢。通用大模型的习惯是想清楚再回答,一段推理几百上千字,等它说完「这个工单该转给谁」,客户可能已经挂电话了。
第二个是贵。拿通用大模型去做分类和参数抽取,相当于杀鸡用牛刀,一天调用上百万次的时候,成本差距会成倍放大。
第三个是输出太自由。同一个问题问十遍,可能得到十种说法,下游系统没法稳定解析。
这三条里,我认为第三条最普遍。前两条取决于你的调用量,量小的时候慢一点贵一点都能忍。但格式不稳定这种事跟调用量无关,一次踩坑就得写一堆正则兜底。
我自己的看法是,慢和贵其实是同一件事的两面,都是为通用性付的税。当场景收窄、选项固定的时候,这笔税理论上确实可以退掉。但退多少,取决于你的场景有多窄。
三、6000 道题,总分差 9 分
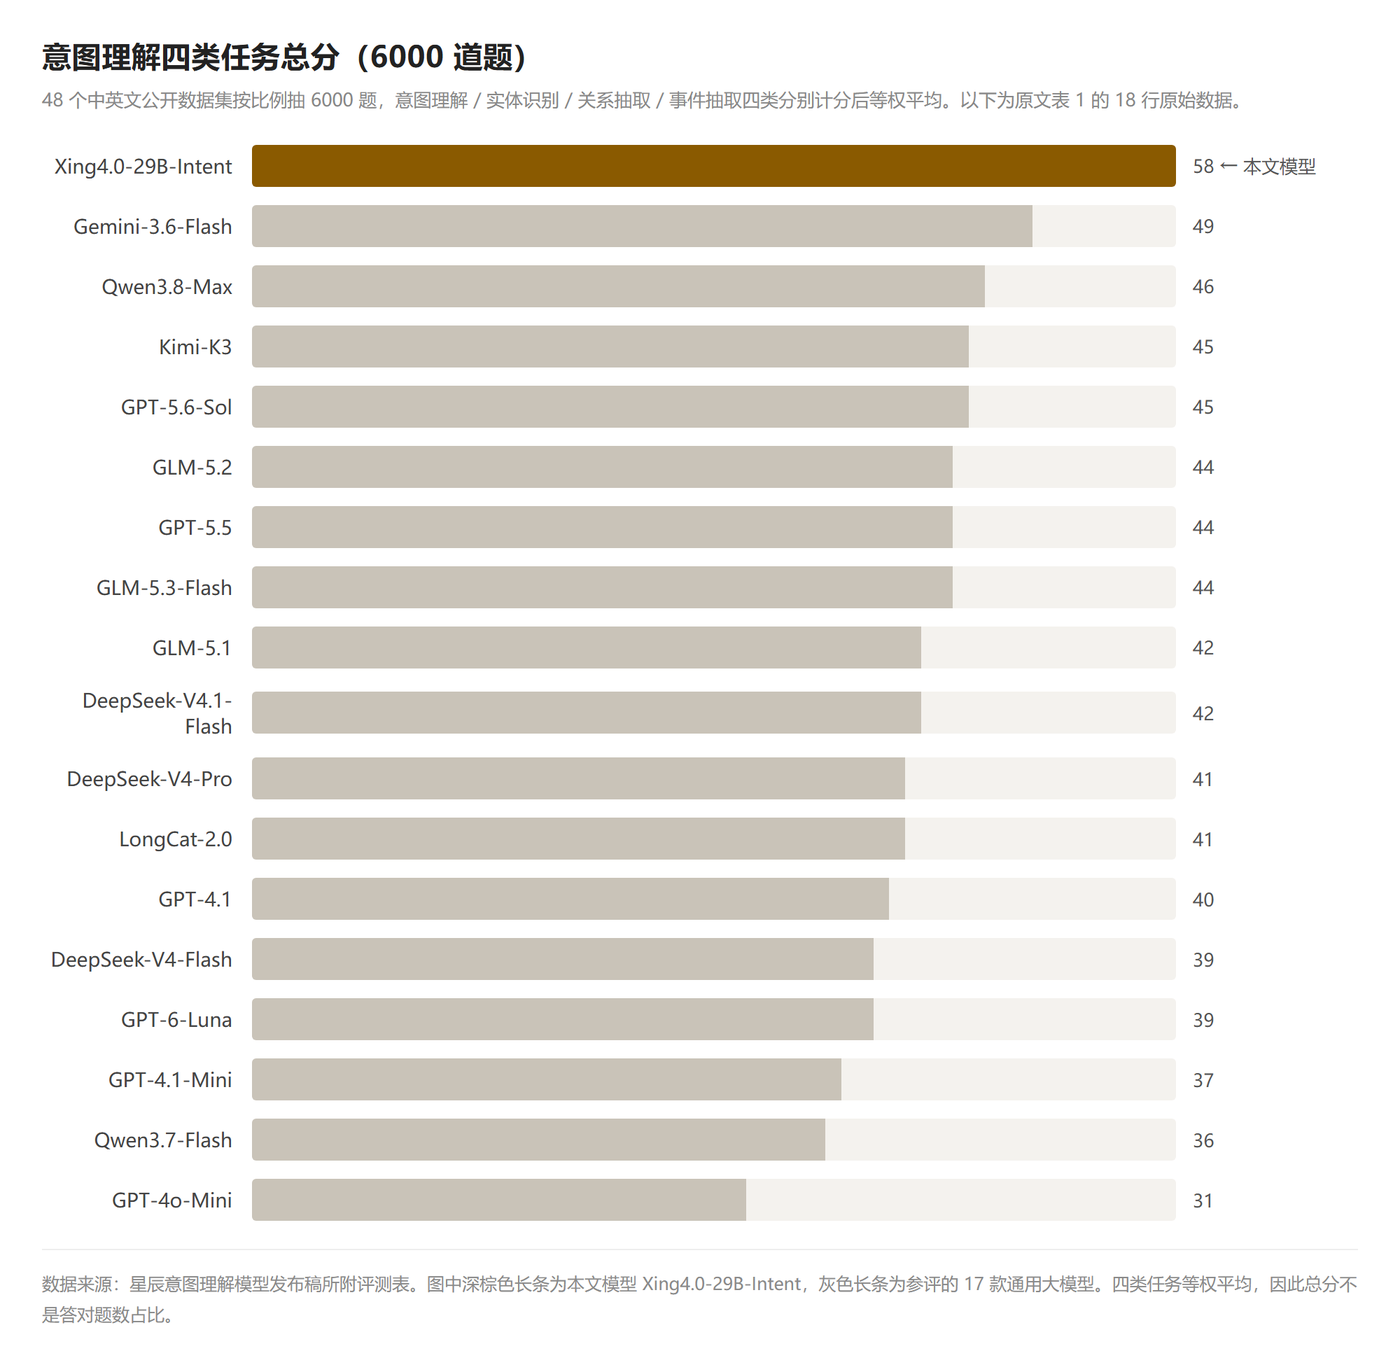
第一组评测是从 48 个中英文公开数据集里按比例抽 6000 道题,覆盖意图理解、实体识别、关系抽取、事件抽取四类。计分方式要注意,四类任务分别算总分再等权平均,所以那个总分不是答对题数占比。
Xing 的总分 58。参评的 17 款通用大模型里,最高的是 Gemini-3.6-Flash,49 分,差 9 分。这个差距看起来不小。
但把四类分项拆开,故事就不一样了。
意图分类,81 对 64,差 17 分,这是它领先最多的一项。实体检测,72 对 71,差 1 分,基本算打平。关系检测,38 对 29,差 9 分。事件抽取,40 对 30,差 10 分。
它的优势高度集中在意图分类,也就是它专门训的那一项。至于实体检测这种通用能力强项,它相对通用大模型几乎没有优势。
这个结构我觉得挺合理,也说明一个问题,如果你的活儿主要是抽实体,那换它意义不大。
还有一点值得提。关系检测 38 分,是四类任务里绝对值最低的,虽然还是比通用模型高,但 38 分这个数字本身不算好看。
四、第二张表里有个更有意思的现象
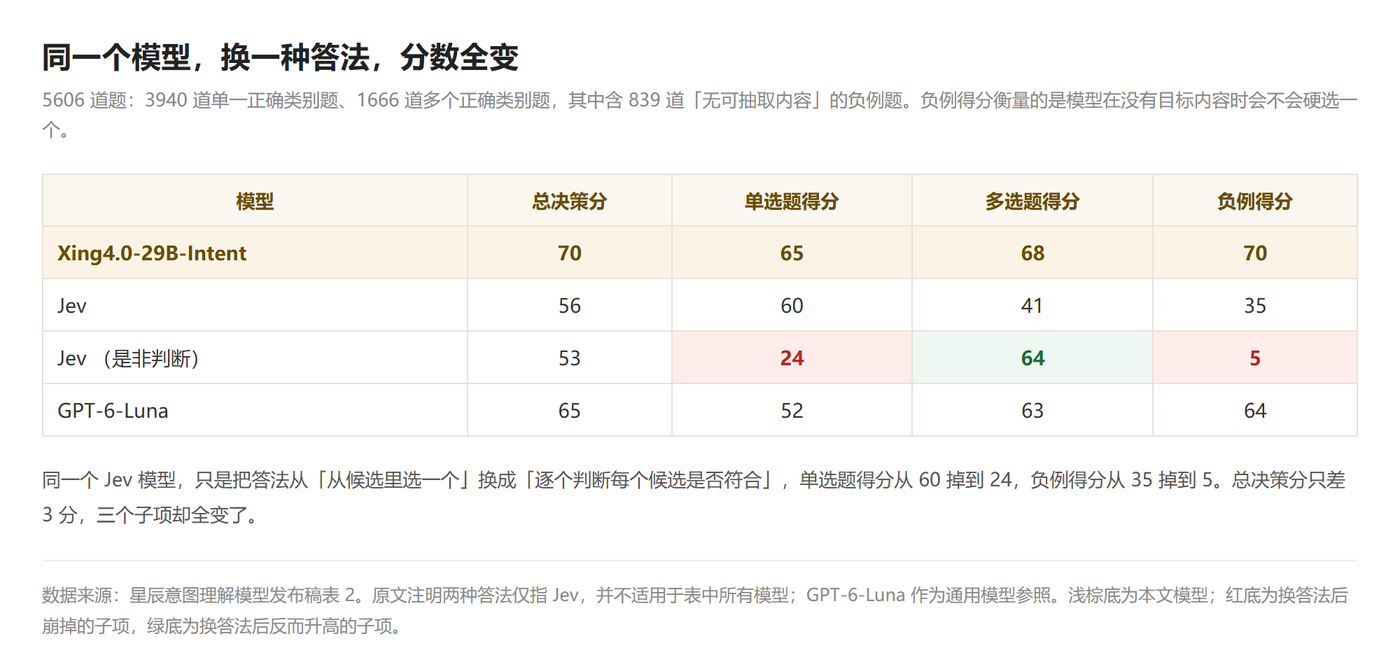
第二组评测一共 5606 道题,只比类别判断,不比参数抽取。题目构成是 3940 道单选题,只有一个正确类别,1666 道多选题,有多个正确类别,里面还混了 839 道负例题,就是压根没有正确答案的那种。负例题是用来测什么的?测模型在没东西可选的时候会不会硬选一个。
结果是这样的。Xing 总决策分 70,四个子项是单选 65、多选 68、负例 70。Jev 总决策分 56,子项 60、41、35。GPT-6-Luna 总决策分 65,子项 52、63、64。
到这里还算正常。真正有意思的是下一行。
同一个 Jev 模型,只是把答法从「从候选里挑一个」换成「逐个判断每个候选符不符合」,结果变成总决策分 53,单选 24,多选 64,负例 5。
总分只掉了 3 分。但单选题从 60 掉到 24,负例题从 35 掉到 5,多选题反而从 41 升到 64。三个子项全变了,方向还不一样。
为什么?官方的解释是,「逐个判是非」是依次问模型每个候选对不对,模型的默认倾向是点头。所以碰上负例题这种本来就该说都不对的情况,它会一路点头,5 分基本等于见谁都说是。而在多选题上,一个个问过去,反而更容易一个不漏。
这个现象的价值不在 Jev。它说明一件事,看评测表之前得先问清楚怎么答的题。
同一张表,如果把 Jev 那两行遮掉只留一行,你会觉得它就是个 56 分的模型。可它在多选上能到 64 分,比那个 65 分的通用模型的 63 分还高。一份评测表能讲两个相反的故事,取决于你留哪一行。
五、它自己写明的短板
延迟这块有具体数字。Jev 那类决策模型是 100 毫秒以内,Xing 是 200 毫秒以内,慢一倍。
参数量 29B。发布稿没说显存占用和部署门槛,这个我没法判断。
能力上,它比 Jev 那类模型多的是参数抽取、信息抽取、NER、事件抽取这几项。Jev 那类只做类别判断,不做抽取。
最该看的是这句,发布稿自己写的,上述评测由本公司技术团队开展,评测结果反映参评模型在本次评测数据及测试设置下的表现,不代表所有任务和实际部署场景中的效果。这句声明比前面所有数字都重要。它意味着这些分数没有经过第三方复现,也没有独立评测机构的结论。我在别的地方找不到复现数据,只能照抄它自己的说法。
六、开源了什么
开源的是模型权重、推理镜像、275.3 万条监督微调语料,Apache 2.0 许可。语料从 61 个公开数据集重构,覆盖 19 个领域、52 种语言。
另外还放出来一个基准,叫 CMPA-SLU,是中文手机助手口语理解的测试集,相关论文被 EMNLP 2026 录用。下载渠道给了好几个,Hugging Face、魔搭、魔乐,还有 GitHub,数据集和权重都能拿到。
对开发者来说,这东西的意义是可以自己跑一遍。任何人写一万字的评测分析,都不如你自己拿真实业务数据跑一千条来得准。
对普通读者来说,这类干活型小模型正在变便宜、变开源。以后手机助手反应快一点,智能音箱少问你一遍您说什么,背后可能就是这种东西在干活。
七、什么场景用得上
官方列了几类场景,手机语音助手、智能座舱、IoT 中控、ToB 客服、企业 IM 机器人,还有 Agent 系统里的语义入口层。共同点是要判意图、要抽参数,而且调用量大到通用大模型扛不住成本。
反过来说,如果你的场景是开放对话、写文案、长文分析,那这个模型帮不上什么忙。它只处理一句话进、结构化结果出这一段。
还有个现实问题。发布稿没提迁移成本,但从工程角度看,换模型意味着重新标数据、重跑评测、改对接。29B 的模型也不是随便一台机器就能起。
你在哪个场景下被听错话气得想砸设备,手机助手还是车载语音。