有人靠拍别人干活,做到了一家年收入逼近 1 亿美元的公司。
拍的不是广告,不是短视频。是人戴着头戴式相机,拍自己怎么切菜、怎么装箱、怎么拧螺丝。
这些视频的去向,是机器人的训练集。
线索得从五年前说起。2020 到 2021 年,OpenAI 的机器人团队经历了一轮解散风波,外面复盘时被提得最多的一条现实难题是:训练数据不够用。
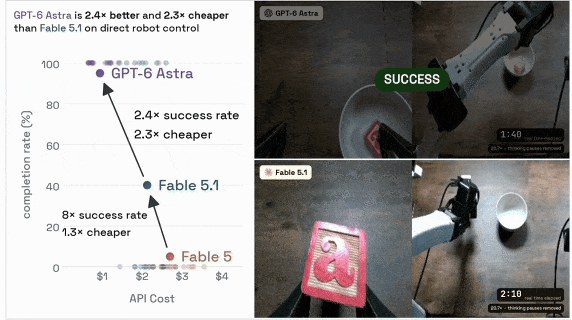
几年过去,GPT-6 已经能控制机械臂,抓取、放置做得有模有样。
这口气是怎么续上的?报道追到了一条不太科技的路径。
机器人自己采数据,太贵
让机器人一遍遍做动作攒数据,成本高、速度慢,能覆盖的场景有限。
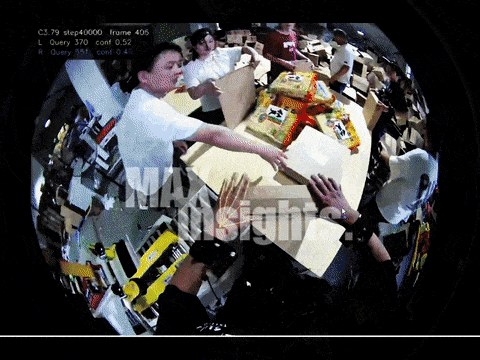
人戴上头戴式相机就不一样。手怎么伸、怎么抓、怎么放,人跟物体怎么交互,全录下来。
采集成本低,场景杂,也不依赖昂贵的机器人硬件。
这类东西有个名字:Egocentric Data,第一人称视角数据。
报道说,这么干才有条件撑起几万乃至上百万小时级的数据集。
一家两三年的公司
顺着这条线,一家叫 Maxinsights 的公司浮出水面。报道说它成立满打满算才两三年。
客户名单摊开:Google DeepMind、Figure AI、1X、Dyna Robotics、Genesis AI。
数据规模:单单向客户交付超过 200 万小时;另有 150 万小时以上带手部追踪和语言标注;月采集产出 45 万小时。
采集网络铺进 2000 多个真实环境,覆盖 50000 多个场景。
商业上,ARR 连续多月站上或逼近 1 亿美元。2026 年第三季度订单签约额预计环比增长 48%。全球近 50 家合作客户,其中 5 家是行业里第一档的那批。
这些数据到底有没有用
光看小时数说明不了问题。两个小时的数据如果能用,比两百万小时没人用强。
报道给了两个例子。
Dyna Robotics 2026 年 8 月发的 Dyna-2,预训练用了 100 万小时人类第一人称视频。
数据从 1000 小时加到 100 万小时,模型对人类动作预测的均方误差降了大约 12%。就算碰上训练阶段没见过的机器人数据,预测表现也随着人类视频规模往上走。
Genesis AI 2026 年 5 月的 GENE-26.5,机器人进厨房,自主走完约 20 步连续烹饪。切番茄、单手打蛋、双手配合,全程没人接手。
很多高难度技能,只要不到 1 小时的特定任务机器人数据就能自己执行。
两家的第一人称数据供应,报道都指向 Maxinsights。
先啃硬的那块
它的路子很土。
先跟头部客户深度绑,按严苛的要求把数据产品磨一遍,磨出相对标准化的数据集,再推给另外 40 多家客户。
跟 Google DeepMind 最早那单,做的是裸手第一人称数据采集,起步只有约 200 小时。
从 200 小时到 200 万小时,走了两三年。
技术上攒了些东西。Full Body 方向,从第一人称视频重建人体全身运动轨迹,追双手动作和物体交互的同时,还原三维姿态。
Upper Body 方向做「动作—空间—语义」联合表达。做一杯拿铁、递一杯咖啡,每一步对应什么动作、什么指令,都标出来。
自研的 MaxSLAM,毫米级还原人操作时的视角变化。内部评测覆盖四类真实任务、20 段操作序列,位置轨迹误差 4.24 毫米,姿态误差 0.57°。
这些数字听着枯燥。可机器人要走出实验室,靠的就是这种枯燥。
说清楚几件事
第一,OpenAI 是不是它的客户,报道没有公开确认。原文说的是「OpenAI 没公开披露这家数据供应商是谁」,后面跟的是行业线索的推演。这句不能当事实用。
第二,我引用的所有数字都来自报道,我没法独立核实。报道本身带着明显的公司视角,客户名单、ARR、小时数都是对方口径。
第三,数据多不等于数据对。报道自己也点了一句:客户今天愿意花钱买的数据,未必是下一代机器人最需要的数据。模型迭代太快,下一步要学什么,有时连顶尖模型团队也得边训练边摸索。
第四,这门生意有它的隐患。具身智能、机器人、自动驾驶的数据采购长期是项目制:客户买完标注数据、训完一版模型,需求就结束,收入跟着订单脉冲式波动。能做到月度持续的收入,才算真过了关。
拍人类干活,听着不怎么高科技。
可就是这些第一人称视频,撑起了逼近 1 亿美元的年收入,也撑起了 Dyna-2 的 100 万小时预训练。
机器人的老师,是干过活的人。
下次看到有人戴着相机在厨房切菜,别急着觉得奇怪。他可能正在给某个机器人喂饭。
公司数据、客户名单与评测结果均引自量子位 2026 年 10 月的报道,属受访方口径,本文未独立核实。配图取自原报道,仅用于说明。