一张打了马赛克的二维码,AI 给补回来了。
央视新闻 10 月 28 日报道,有网友发现,一张在二维码处打了马赛克的兑换券截图,交给 AI 图片工具修复之后,居然能扫出信息。
这事传开,很多人的第一反应是:马赛克没用了。
但央视做了实测,结论比这细致。
它能补,但不是随便补
央视给出的两组结果,值得逐字看。
第一组:涂鸦只遮挡二维码外围区域,或者涂鸦不够厚、没完全覆盖底色,AI 能复原成功。
第二组:把涂鸦面积放大到全部覆盖二维码,而且厚涂到原二维码细节难辨,AI 就不能复原出可使用的信息了。
专家的解释是,AI 所谓的「恢复」,前提是涂鸦遮挡的区域没有盖住核心数据区。核心数据区被彻底盖住,AI 也修不回来。
央视给的建议:处理二维码时,尽量把 90% 的区域都打上马赛克。
90% 这个数字,可以记一下。
二维码为什么这么扛
这里有个容易漏掉的背景。
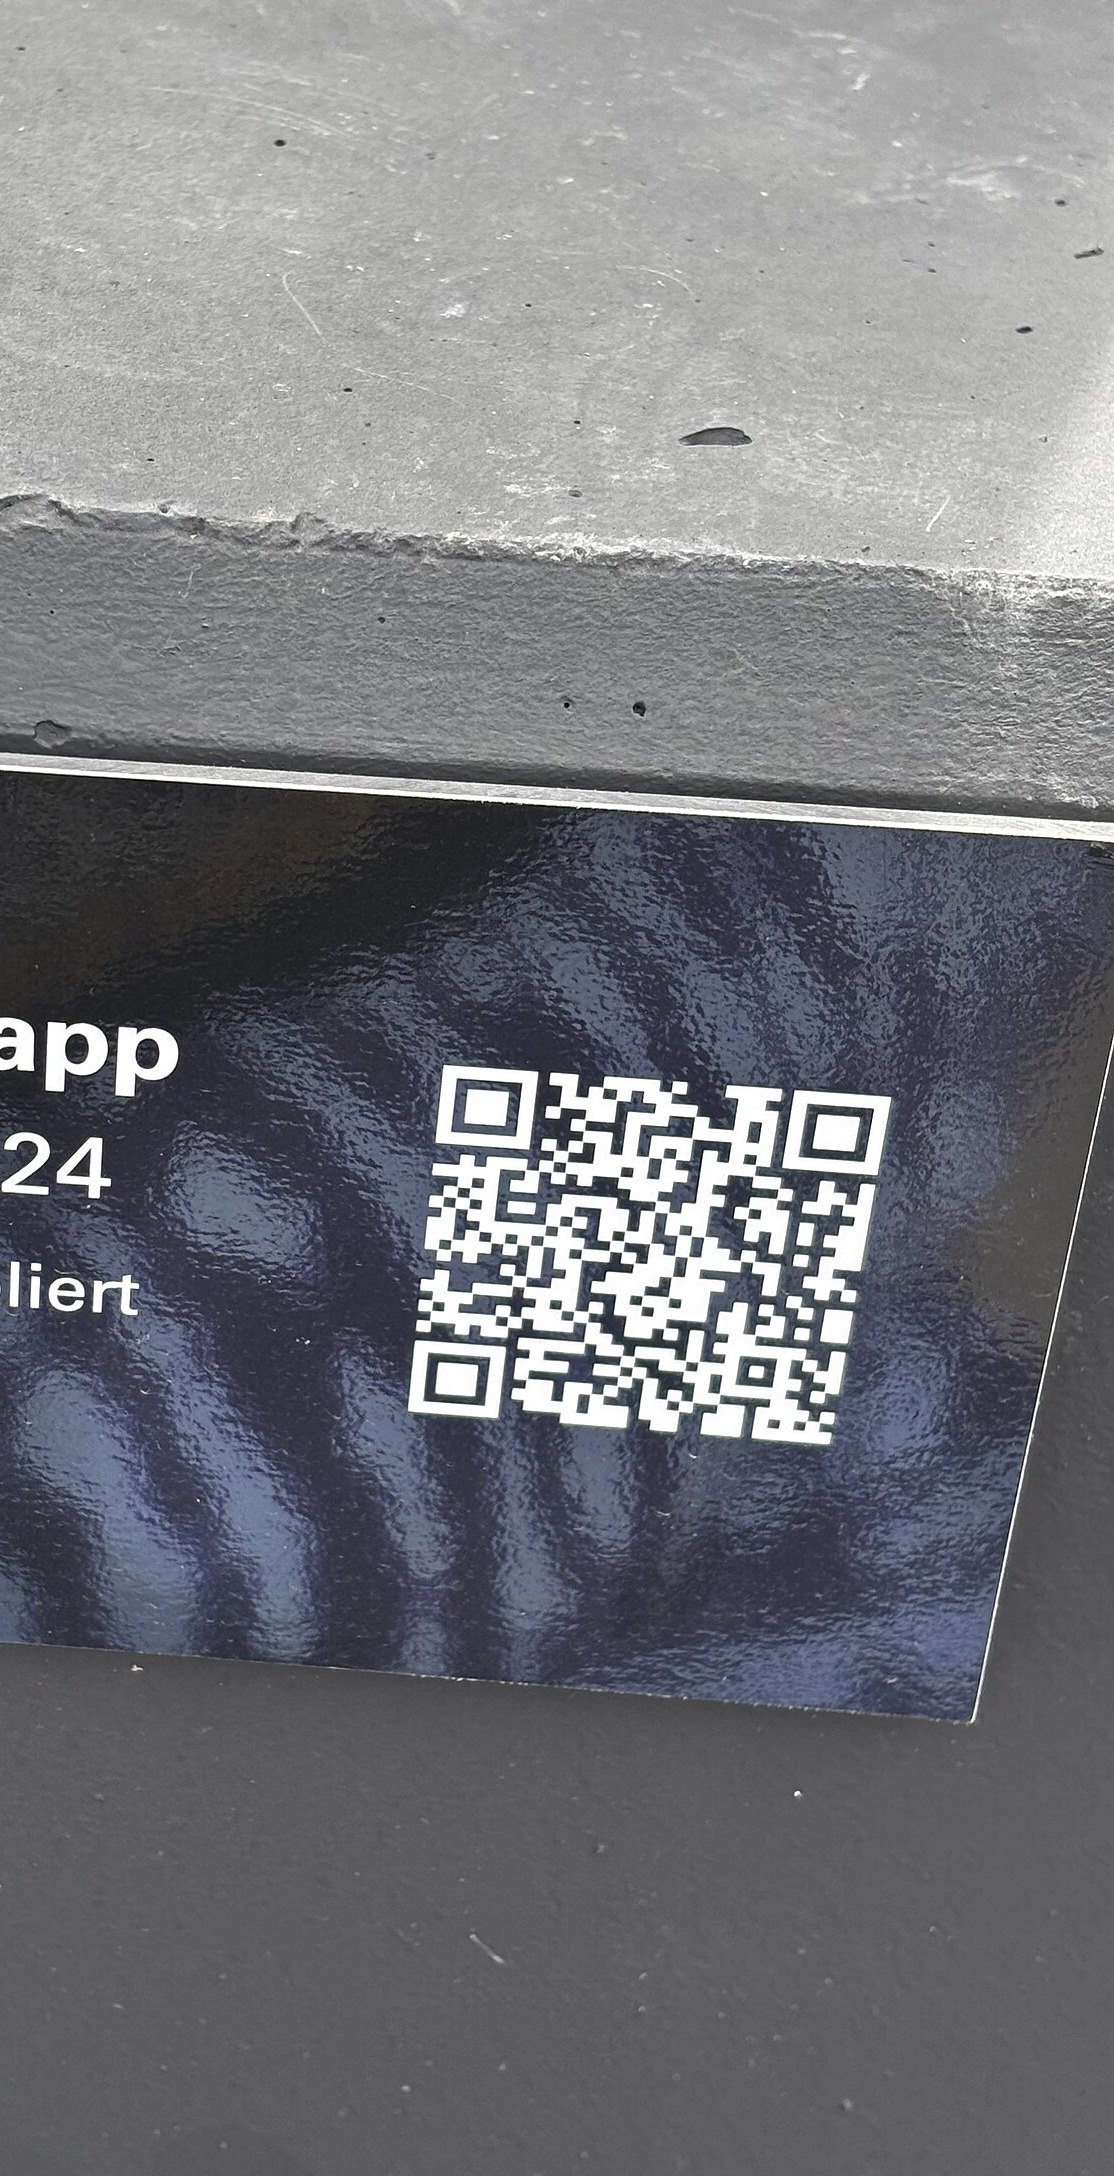
二维码自带容错机制。就算没识别到全部条码,或者条码有污损,它也能把原来的信息正确还原出来。
这是设计时就有的能力。印糊了、被贴了标签、缺一角,都还能扫。
所以给二维码打马赛克这件事,一开始就在跟容错机制较劲。
你盖住一部分,剩下那部分加上容错机制,信息可能还是完整的。
AI 做的,是在这之上再推一步。它先认出剩下的残片,再按「二维码应该长什么样」去补那些彻底没了的格子。
补对了,看着像神迹。补错了,它照样给你一个能扫出来的结果,只是内容不一样。
同一个机制,在文字上也在跑
同一天,另一件事在传。
10 月 27 日晚间,有开发者在 DeepSeek Harness 的 GitHub 代码库里,发现了一组此前没出现过的模型标识符。
在 provider.spec.ts 这个测试文件里,第 154 行附近,出现了 deepseek-v5、deepseek-v5-open 和 deepseek-v5-next 三个条目,跟已有的 deepseek-v4-pro 并排。
截图一出来,「V5 要来了」就成了当天的结论。
代码本身说的却是另一回事。
这三个条目现在承担的是框架层面的占位角色,不是能直接调用的模型接口。
细节更能说明问题。
v5-open 后面标的版本号是 0.0.1。意思是这条路径没有实质的版本门槛,服务端切换之后,旧版客户端还能接着用。
v5-next 标的版本号是 99.0.0-alpha.1。这个数字指向一条要求客户端升级才能接入的通道。
两条通道,对应两种下发方案:一个平滑过渡,一个强制更新。
这是提前备好的管道,不是发布会。
IT之家在报道里专门提醒了一句:占位符出现,不等于发布临近。现有代码只能证明发布机制已经就绪。
截至 10 月 28 日,DeepSeek 官方没发任何公告,没有模型卡,也没有 API 标识符。
两件事的共同点
一边是图像,一边是代码。
AI 补二维码,补的是它看不见的像素。
人读代码,补的是代码里没写的意图。
干的是同一件事:缺口一出现,就自动填上。填的时候不打招呼,填完了语气和确定的时候一模一样。
这就是为什么要在提问里把这层点破。
4 句可以直接复制的话
下面四句,都对着同一个位置使劲:AI 不知道哪里是不知道。
当固定后缀,加在问题后面就行。
第一句
把你上面的回答分成两栏。左边写哪些是直接来自我给的材料,右边写哪些是你推断的。推断那栏,标出你依据的是哪一句。
这句管来源。它逼着模型把「读到的」和「想出来的」分开摆。
改法:把「标出依据」换成「不确定就写不确定」,适合你只想知道它有没有在猜的情况。
第二句
这段里有你无法确认的地方吗?有的话直接写「不确定」,不要给我一个看起来合理的答案。
这句管拒绝。默认状态下,模型倾向于给一个完整的回答。你明确给它退路,它才肯承认空缺。
第三句
如果这段话里有一句是错的,最可能是哪一句?为什么?
这句管自查。它不保证找出真错,但能把薄弱的地方亮出来。
第四句
给我这句话的出处。给不出就写「没有出处」,不要自己去找一个相近的说法代替。
这句管溯源。最后半句别省。不加的话,模型会拿一个相近但不相关的来源顶上。
一个失败版本
模板不是万能。给个对照。
我问过一个模型:「DeepSeek V5 什么时候发布?」
不加上面四句,它的回答大意是:根据代码库中出现的占位符,V5 可能已在准备阶段,业内预计近期发布。
这话说得挺顺。问题是,「业内预计近期发布」这句,谁也没说过。
加上第二句和第四句再问一次,回答变成了:代码库里确实有 v5 相关标识符,属于占位角色;官方截至 10 月 28 日没有发布公告。发布时间目前没有可靠信息。
短了,也没那么好读。但能用了。
这四句管不到的地方
边界得说清楚。
这四句能减少「编得像真的」,不能保证全对。模型说自己「确定」的时候,也可能错。
它更适合用在你要拿结论去做判断的场合。随便聊两句,犯不上这么麻烦。
还有一点,图片类任务上这套话术不好使。你没法让图像模型交代「哪块是我补的」。碰上二维码、票据、证件这类图,更实际的做法是把关键区域厚涂到看不出细节,别指望 AI 自觉。
最后
央视那条新闻里,真正值得记住的不是「马赛克失效」,而是那个条件。
涂得薄,它能补。涂到细节没了,它补不了。
跟 AI 打交道的很多事都是这样。它的边界不在能力上限,在你给它的信息里,还留着多少能猜的地方。