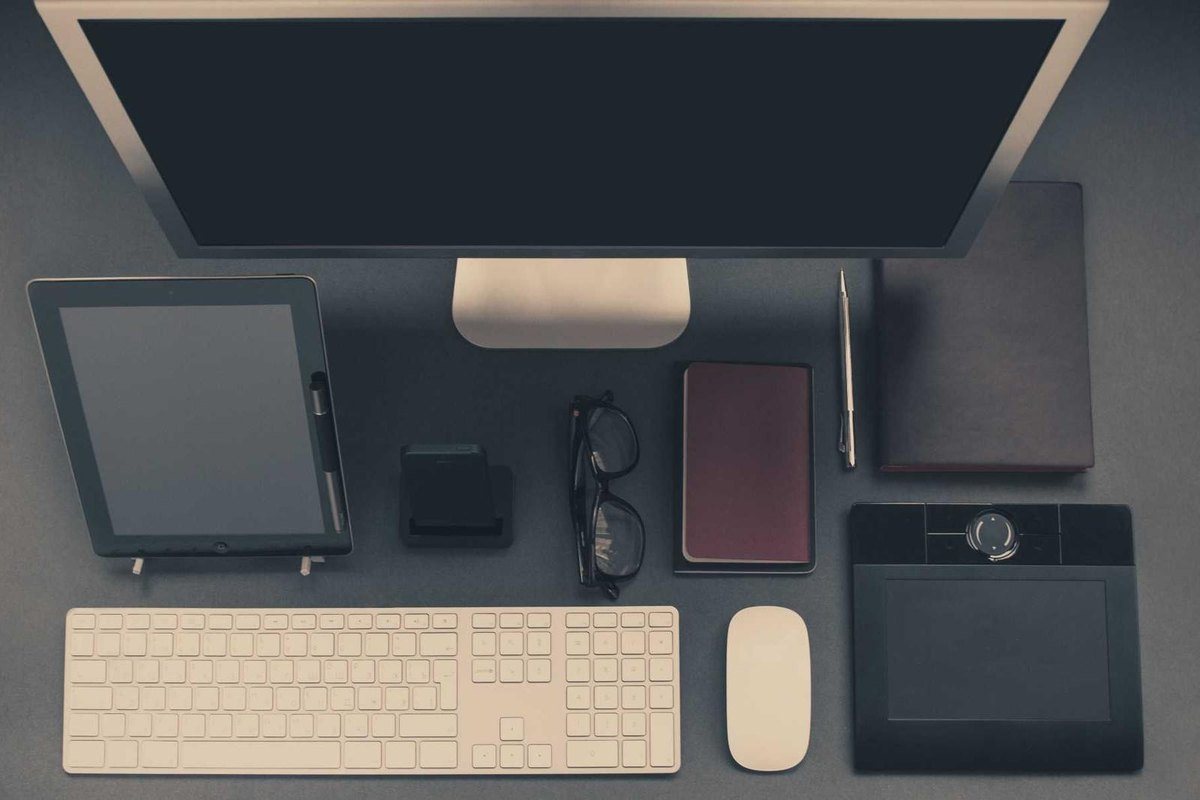
照片是俯拍的。一张书桌上摆着一台宽屏显示器、一台竖放的平板、白色无线键盘、白色鼠标、数位板、黑框眼镜、一本酒红色小笔记本、一支钢笔、一本黑色平装笔记本。
图没换,模型没换,我只换了问法。
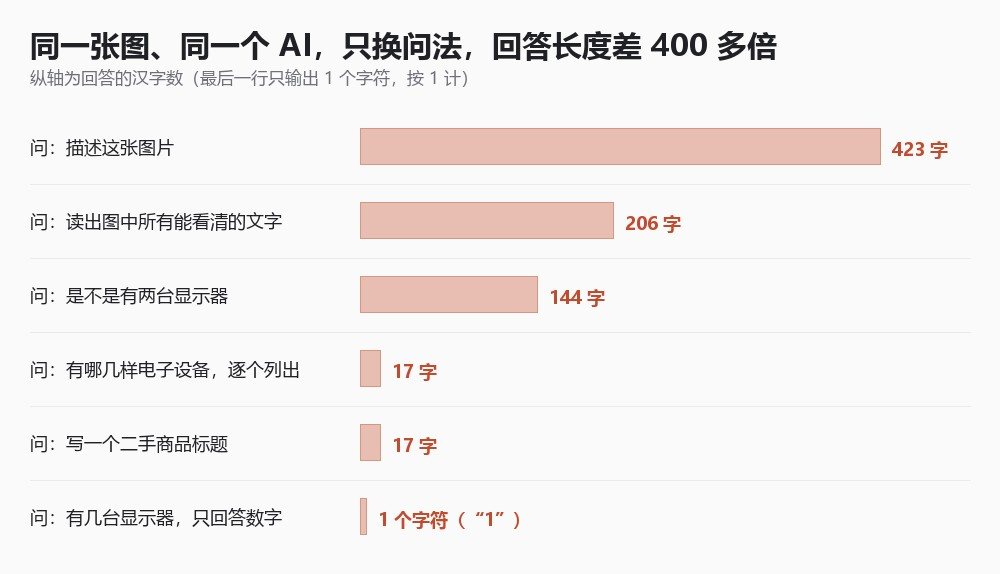
同一张图,同一个模型,回答长度差 423 倍。
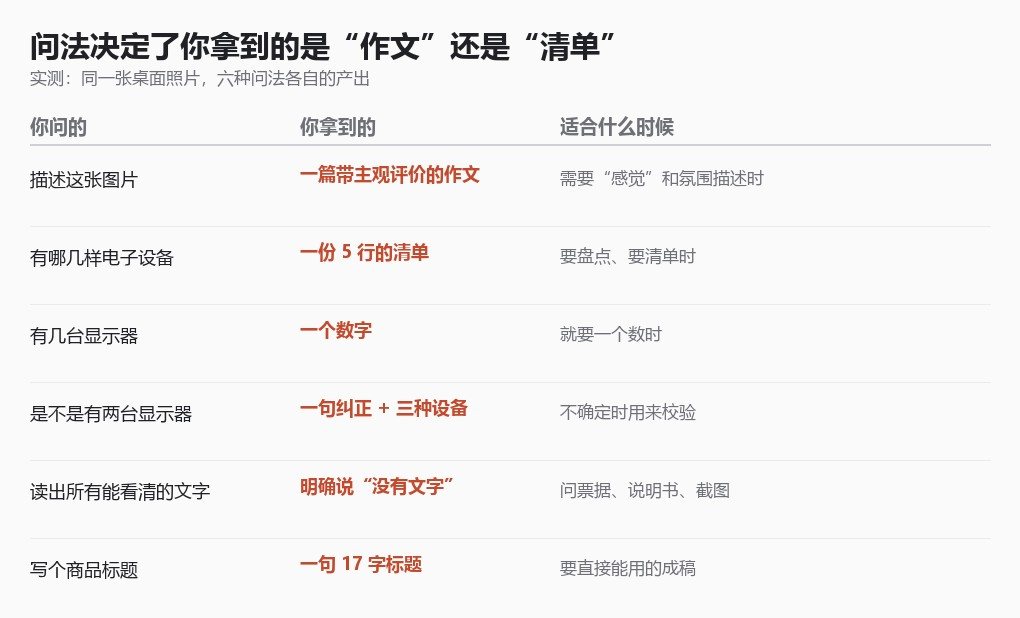
问「描述这张图片」,回来一篇作文
423 个汉字,分四块:整体印象、色彩与背景、物品分布、整体氛围。
开头第一句就把调子定了,说这张图「呈现出一种极简、现代且井然有序的办公或创意工作区风格」。
整篇里有九处主观评价:极简、现代、井然有序、高级、克制、有品位、高效、专注、规整。
我要的是「桌上有什么」,拿到的是「这是一个有品位的创意工作区」。
这一档是模型最高效的地方,也是最没用的一档。它没有说谎,它只是把形容词当成了描述。
四块内容里,真正在说物体的只有中间一段,其余三段都在说风格、色彩和氛围。
问「读出所有文字」,它老实说没有
206 个字。第一句是「图中没有能够看清的文字」。
后面逐项解释:显示器黑屏,平板熄屏,键盘上的字母看不清。
一个字都没编。
这一问值得单独说。模型分不清「我不会」和「我猜一个」,得你替它分清。把「看不清就说看不清」写进问题里,它才真按这个来。
反过来看,不写这句的后果很直接:它会为了把回答填满,替你把看不清的地方补上。这不是它撒谎,是任务要求它必须给答案。
问「是不是有两台显示器」,它反过来纠正我
144 个字。它没顺着我。
原话是:「严格来说,不是两台传统的电脑显示器。」
接着它把画面拆开讲:上方一台真正的大尺寸电脑显示器,左侧一台平板,右下角一块绘图板兼数位屏。最后补一句区分,问电脑显示器只有一台,泛指带屏幕的设备有三台。
我那句问法里带着预设,它把预设挑了出来,还顺手给了两种口径。
这是六问里唯一一次,它主动把歧义摊开。
问「有哪几样电子设备,逐个列出」,回来一张清单
17 个字,五行:显示器、平板电脑、键盘、鼠标、数位板。
干脆,能直接贴进表格。
一行一个,没有形容词。
同一张图,从 423 字压到 17 字。信息没少,水全挤掉了。
问「写个二手标题」,它漏了最贵的那件
17 个字:「全套桌面数码打包 平板键盘鼠标数位板」。
画面里最值钱的那台宽屏显示器,没进标题。
这不算模型的错。它按我给的 20 字限制挑重点,而我给的重点只有「二手标题」,没说「不许漏大件」。
任务型提问最容易出这个问题:活干完了,漏掉的是你没说出口的那条要求。二十个字的空间,它优先塞进了数量最多的那几样。
问「几台显示器,只回答数字」,回来一个字符
就是「1」。连句号都没有。
这一问和第一问摆在一起看最有意思。同一张图,同一个模型,回答长度差 423 倍。
差的不是能力,是我给没给它边界。
长回答不等于好回答
把六次回答按字数排一遍,会发现一个反直觉的结论。最长的那篇,能用的信息最少。
把 423 字那篇拆开看。物体相关的字加起来不到一百,列出的东西有十来样:显示器、平板、触控笔、键盘、鼠标、数位板、眼镜、两本笔记本、一支钢笔,还有两个认不出是什么的小件。剩下的三百多字,全在讲质感、光线、布局和氛围。
17 字那篇正相反。五行全是物体,拿起来就能用,代价是把画面里最贵的那件漏了。
两种毛病,一个方向。长的那篇信息被形容词稀释,短的那篇信息被我给的字数限制挤掉了。都没有说谎,都只是照着我的要求做。
字数多是模型在替你补语境。它猜你想听评价,于是把评价一并给了。你要是不需要,那些字全是噪音,还得自己筛一遍。
所以别拿回答长短判断它认不认真。它答得长,往往只是问题太宽。
它答得越长,往往只是问题问得越宽。
能照抄的六种问法
六问拆成五类,可以直接复制改词。
要清单:逐个列出图中所有物体,每个一行,不加形容词。
要读字:读出图中所有能看清的文字,看不清的直接说看不清,不要猜。
要数字:图中有几台某某,只回答一个数字,不要解释。
要核对:我怀疑图里有几台某某,你先判断我说得对不对,再说明依据。
要成稿:写一个二手平台商品标题,20 字以内,必须包含画面里最贵的那件东西。
最后一条是被那 17 个字坑出来的。
六次提问,我没换图,也没换模型。
换的只有问法。
下次把截图丢给 AI 之前,先想清楚你要的是一段散文、一张清单,还是一个数字。
点个在看,转给那个天天喊 AI 不好用的同事。