同一封信,六种问法
需求是同一件:客户快递晚到三天,写封道歉信。
我把它写成六个版本,从四个字到两百字。然后用分词器各数一遍。
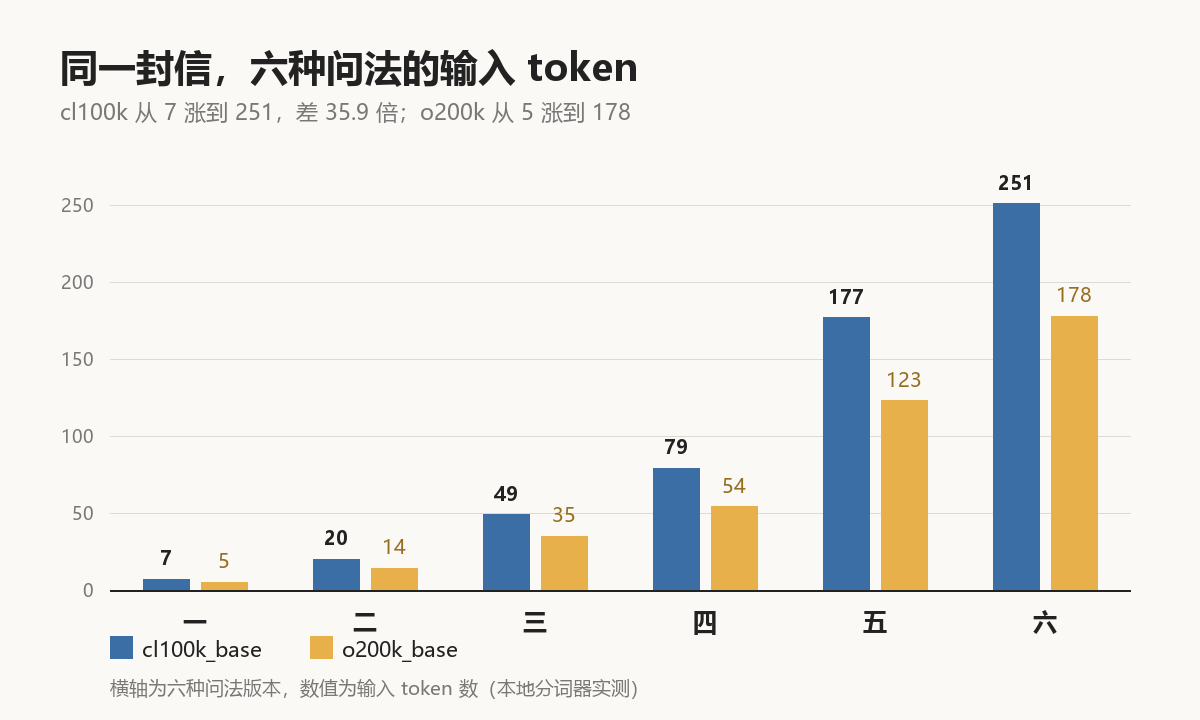
最短 7 个 token,最长 251 个。差 36 倍。
这篇不算钱,也不算效果。只算一件事:你那句话本身,占了多少位置。
一、六种问法
原文都在这儿,你自己也能数。
放大倍数,从第一条算起:
第五步涨得最狠。加一个范例,token 从 79 翻到 177,多了一倍多。
范例是唯一一个「内容换内容」的加法。别的要求都只是几个字。
二、零碎的开销
有些话短得看不出成本,数一下才知道。
那个「请一步一步思考」,八个字,7 个 token。
一句话看不出什么。但如果你在系统提示词里放了 20 条这种要求,就是一百多个 token,每次调用都要付。
三、表格最贵,连写最省
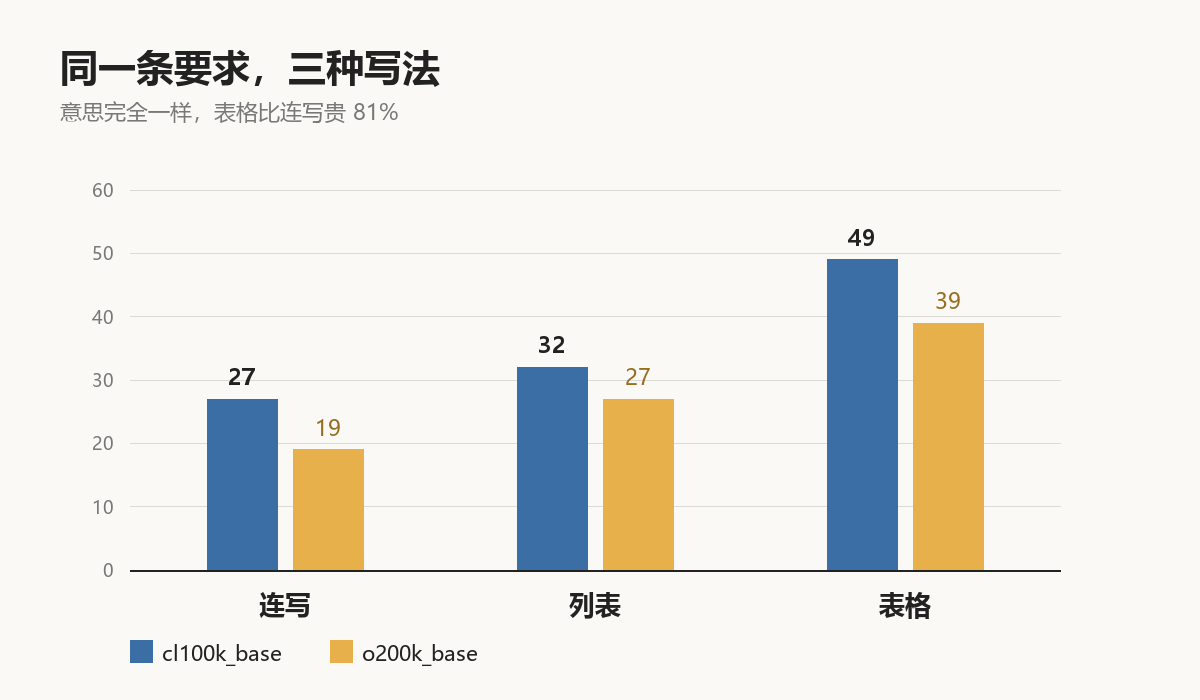
同一条要求,三种写法,意思完全一样。
数出来:
表格比连写贵 81%。
原因很朴素:竖线、横线、重复的表头,全是 token。表格还把同一句话说两遍,一列说禁止什么,一列说怎么处理。
我第一次量到这个数的时候有点意外。我平时最爱用表格。
四、中文比英文贵吗
同一句话,两个语种:
英文写出来长五倍,token 反而少。
按整篇算更清楚。我拿站里第 170 篇的正文数了一遍,1560 个汉字:
新词表比老词表少 26%。同一个汉字,在新分词器里平均少占 0.4 个 token。
所以「中文更贵」这句话,一半对一半不对。按字符算,中文确实贵。按信息量算,一句中文翻成英文,字符数涨五倍,token 只少两成。
五、真正吃上下文的是历史
上面这些都在几十个 token 的量级。真正占地方的不是它们。
按 1.56 这个比例估:
你精心省下来的那 20 个 token,跟一次对话历史比,是零头。
这也是我觉得最反直觉的地方:大家都在研究怎么把提示词写得短,但模型记不住答案,往往是因为你每轮都把前面的全文又贴了一遍。
六、我现在的写法
顺序改了。
第一版永远写最短的。就一句,把需求说清楚,别的都不加。
跑出来不像样,再一格一格加。加语气,加约束,加范例,一次只加一样。
这样能看出是哪一句起了作用。也能看出哪一句白花钱。
用表格之前先想一下:这段真的需要对齐吗。三条以内的要求,连写更省,读起来也不差。
我没验证的地方
这篇一个接口都没调。
所有数字都是本地用分词器数出来的,数的是输入文本本身。我没有真的把六种问法发给任何一个模型,所以「哪种问法写出来的信更好」,我不知道,也不在这篇的范围里。
只数了输入,没数输出。
实际账单里输出通常比输入贵,各家比例不一样。这篇只算你说话的那部分。
分词器只有两个。
cl100k 和 o200k,都是 OpenAI 公开的。国内模型的分词器没公开词表,同一句话在它们那儿是多少 token,我不知道。用这两个数去套别人家,只能当量级参考。
价格一个都没写。
每百万 token 多少钱,各家在改,我没去核对当天报价。这篇只给数量关系:你多写了几个字,多付多少比例。
缓存没算。
有的接口对重复的前缀有缓存价,同一段系统提示词反复用会便宜。具体怎么算、能省多少,取决于厂商,我没测。
六种问法的字数是我自己定的。
换个人写,可能第三版就 80 个 token。这篇量的是我这一版的差距,不是行业标准。
一句话
问得细不一定贵,写得啰嗦一定贵。
真正把账单顶上去的,通常不是你那一句提示词,是你每轮又贴一遍的那堆历史。