朋友收到一封图库网站的邮件,说她三年前上传的几十张风景照,被拿去训练 AI 了。她翻出当年的注册协议,行小字写着:用户授予平台「全球范围内免费使用」的权利。
她愣了半天,回了句:那我拍的照片,到底还是不是我的。
这两天牛津大学那事儿,跟这封邮件是同一个套路。
12.5 万份论文,悄悄成了口粮
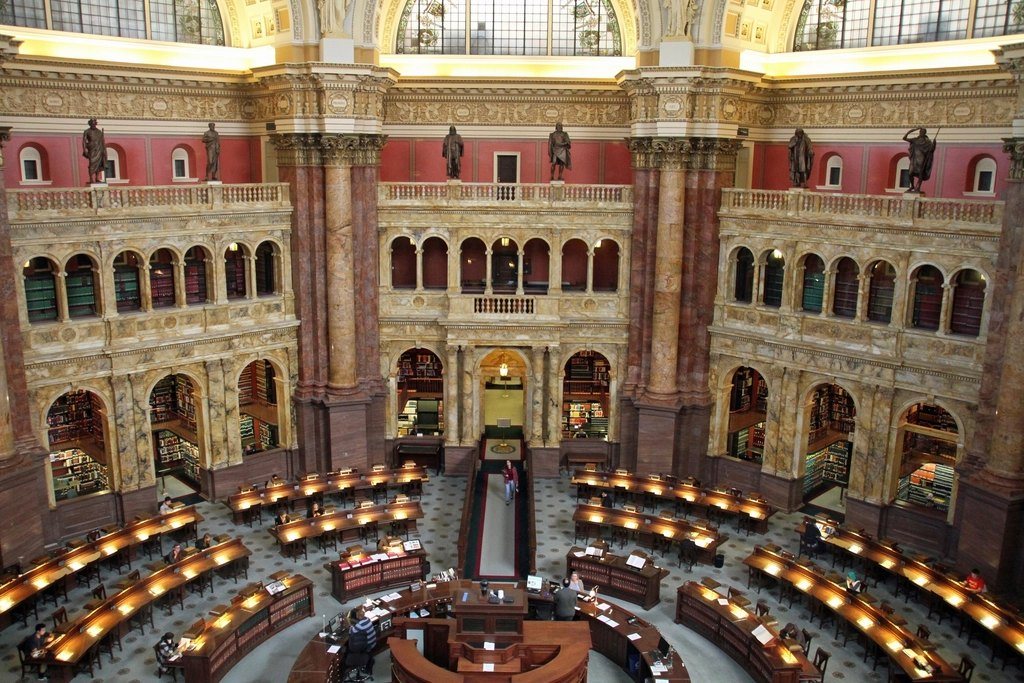
博德利图书馆,牛津的心脏,四百多年历史。它把 12.5 万份历史学位论文交给了 OpenAI 做数字化。
公告发出来的时候,措辞很漂亮。扫描、存档、让知识被更多人看见。
教职员一开始挺高兴。老论文能上网,是好事。
可没过多久,有人发现不对劲。这批数字化内容,被用于训练模型了。公告里,一个字没提。
图书馆的回应是:数字化本身不等于训练。
这话没错。但问题是,训练这一步,谁批准的。
一位牛津的教授说了句大实话:我们把书交出去,图的是让人读到,机器拿去吃掉就变了味。
这事离你我,没那么远
你可能觉得,牛津的事,跟我有啥关系。
那我问你几个问题。
你手机相册里那几千张照片,存在哪。你写的公众号文章,发在哪个平台。你电脑里那份工作文档,是不是也在某个云盘里躺着。
注册的时候,那份长长的用户协议,你点过「同意」没有。
我同事老周,前阵子翻自己云盘的协议。第八条,第六款,授权平台为了改进服务使用用户内容。
他念完,把手机扣桌上了。
「改进服务」四个字,弹性有多大,谁也说不准。今天的服务是修图,明天的服务,可能是训练。
数字化和训练,中间隔着一条线
这条线,很多人分不清。
数字化,是把纸上的东西变成电脑里的文件。扫描、存档、上网。这一步,是为了保存和阅读。
训练,是让 AI 把这些东西读进去,学会里面的规律。这一步,是拿去用,拿去生产。
前者像图书馆把书放到书架上,谁都能看。
后者像把书拆开,喂给一台机器,让它照着写新的。
两件事,差距不小。可在很多协议里,这两件事被一句「使用用户内容」打包了。
牛津那批论文的作者们,很多已经去世了。他们没法出来说一句话。
你我还活着,还能问一句。
三条能马上用的自保动作
说回能做的事。不讲大道理,就三条。
第一,重要文件,别只存一份在云上。硬盘、移动盘,本地留一份。云图的是方便,它可算不上保险箱。
第二,发东西前,花两分钟翻协议。找「授权」「使用」「改进服务」「商业用途」这几个词。看不懂就搜。两分钟,换心里踏实。
第三,敏感内容,上传前处理。身份证、合同、带家人的照片,能打码打码,能不传不传。
我朋友后来把那几十张照片从图库删了。删不掉的授权,她认了。但她把手机相册同步关了。
她说:至少以后拍的,我自己说了算。
牛津的书还在图书馆里。12.5 万份论文,也还在。只是它们多了一个身份,训练数据。
这个身份,没人问过作者愿不愿意。
你的照片,你的文字,你的文档,现在正躺在某个服务器里。
它们有没有多出别的身份,你查过吗。
点个在看,转给那个爱往云盘里塞东西的朋友。