先说结论:分数是同一套,钱不是。
11 月 10 日谷歌开放 Gemini 4 Carbon,同一批材料里端出了一个新基准,MKA。
全称 Multimodal Knowledge Agent,多模态知识智能体。测的是智能体读复杂图纸、看扫描件、再交出一份能用文件的能力。
这个基准是谷歌和评测机构 Artificial Analysis 一起做的。
我先看的是谷歌官方那篇博文。原话是 Carbon 排第二,平均每任务成本比第一名低「超过 6 倍」。
然后我翻到 Artificial Analysis 自己的文章。同一件事,写的是「超过 5 倍」。
差了将近一倍。往下挖。
三份材料,三处写法
谷歌博文:第二名,成本低「超过 6 倍」,英文原文是 more than 6X。
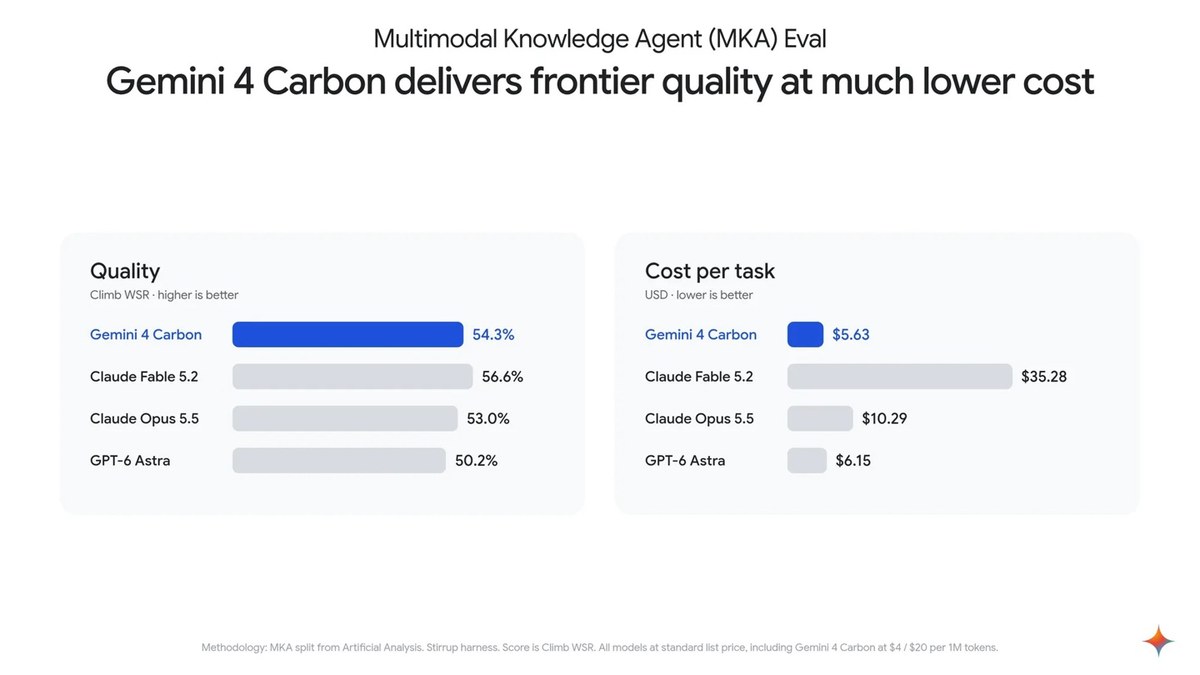
谷歌配图是两张并排的条形图。
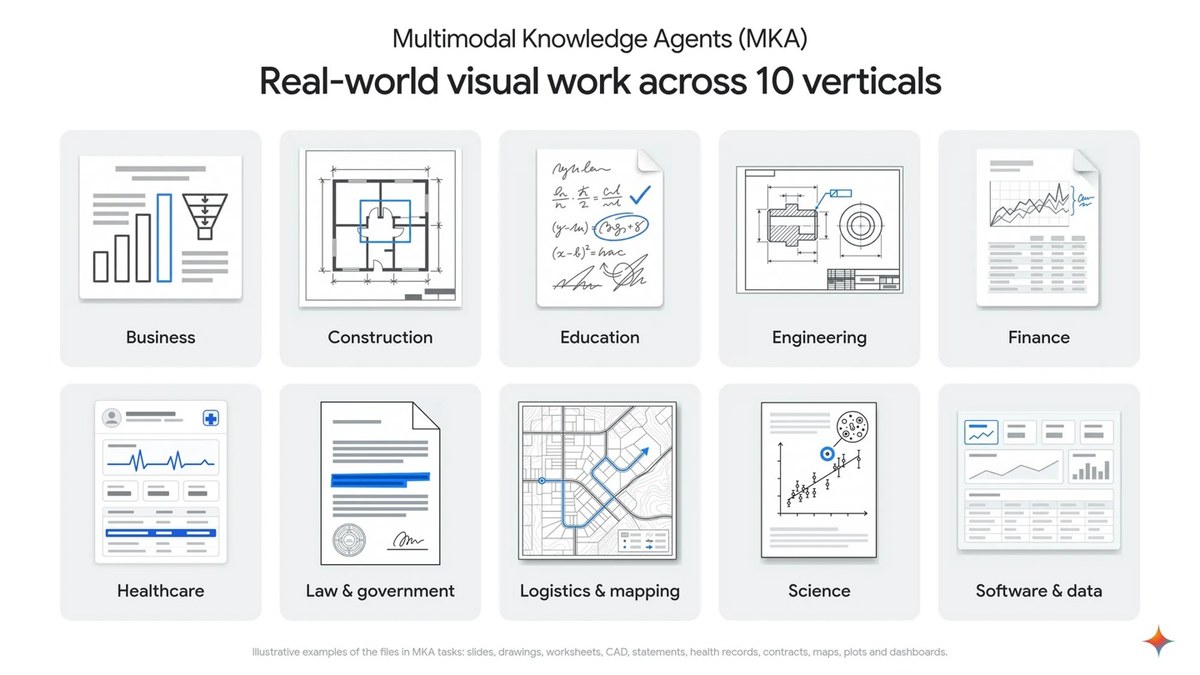
左边是质量:Carbon 54.3%,Claude Fable 5.2 56.6%,Claude Opus 5.5 53.0%,GPT-6 Astra 50.2%。
右边是每任务成本:Carbon 5.63 美元,Fable 5.2 是 35.28 美元,Opus 5.5 是 10.29 美元,Astra 6.15 美元。
Artificial Analysis 那篇:Fable 5.2 第一 57%,Carbon 54%,Opus 5.5 53%。成本 31.97 美元对 6.29 美元。
三份材料,我摊在屏幕上一条条对。
分数其实是同一套
我盯着两列百分比看了好一会儿。
56.6 和 57。54.3 和 54。53.0 和 53。
四舍五入。Artificial Analysis 只是把小数位砍掉了。
名次也一致:Fable 5.2 第一,Carbon 第二,Opus 5.5 第三。
所以我一开始脑子里那个「两家各说各话」的念头,在分数上不成立。这条得记下来,因为它说明我第一反应是错的。
差在钱上,还是两个方向
35.28 除以 5.63,等于 6.27。这是谷歌那张配图上的倍数。
31.97 除以 6.29,等于 5.08。这是 Artificial Analysis 文章里的倍数。
同一个模型,两组数:
Carbon 的成本从 5.63 涨到 6.29,高了 11.7%。
Fable 5.2 的成本从 35.28 掉到 31.97,低了 9.4%。
一个往上,一个往下。两边各动一成左右,倍数就从 6.27 变成 5.08,掉了 19%。
「6 倍」和「5 倍多」都能站住,只是各取了一次运行的结果。
这点比追究谁说谎有用:一个拿来定选型的倍数,对输入端一成的波动这么敏感,本身就该当个参考区间看,不是当刻度看。
我试过一个解释,方向反了
第一反应是价格口径。
谷歌那张图的脚注写着:所有模型按标准价算,包括 Carbon 每百万输入 4 美元、输出 20 美元。而博文里的首发优惠是每百万输入 2 美元、输出 10 美元。两者差一倍。
按这个思路,谁用了促销价,谁算出来的成本就该更低。
可 Artificial Analysis 的 Carbon 成本比谷歌高,不是低。方向反了。
这个解释我放弃。真实原因我不知道,【暂无相关资料】。有可能是两次统计消耗的轮次不一样,智能体任务每跑一次都不完全一样。这是我的猜测,没有证据。
这份榜在测什么
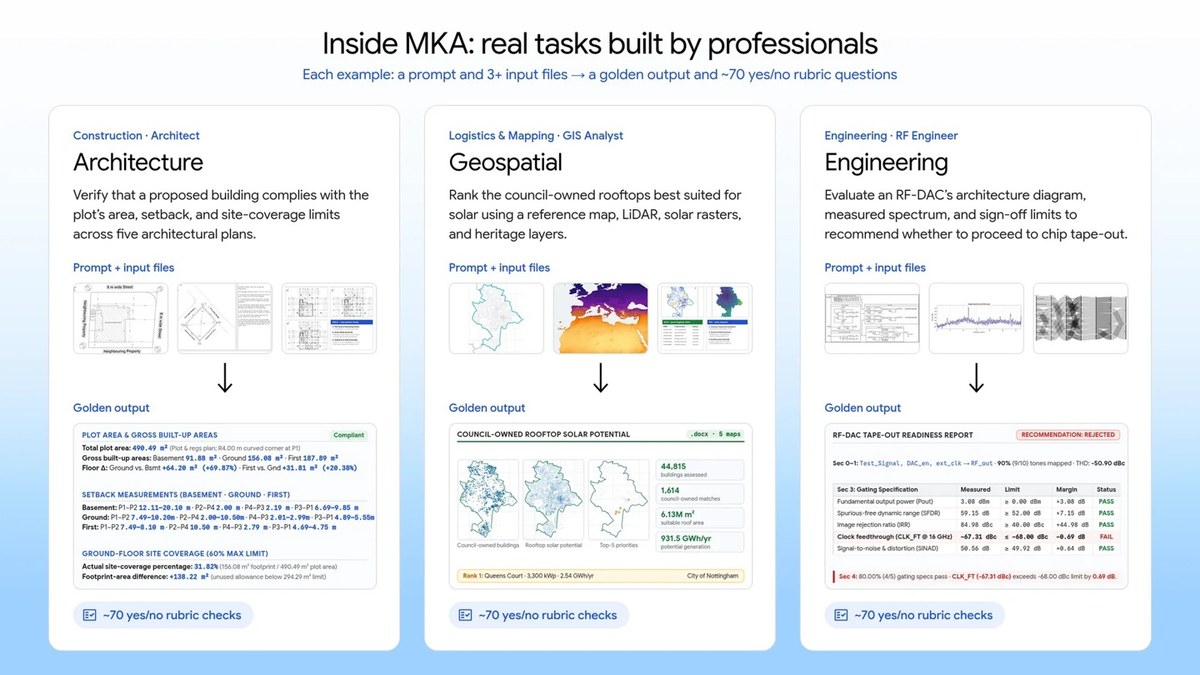
200 项任务,全部私有。10 个行业。83 种职业的领域专家参与出题,这个数字是 IT 之家写的,Artificial Analysis 原文只说到 10 个行业。
每项任务模拟一个多步骤项目,专家自己做要 3 到 8 小时。
评分标准每项平均约 70 条,分两组。Regression 是基线,模型应该过的。Climb 是难的,用来把强模型分出来。
头部分数叫 Climb WSR,只算 Climb 那组。
这一点容易看漏:及格线不给分,只算难题部分。
配图里那三个任务,我拿建筑那个举例。五张建筑图纸,核对拟建建筑有没有超过地块面积、退距、覆盖率的上限。
交付物里写着地块面积 490.49 平方米,地面层占地 156.08 平方米,覆盖率 31.82%,上限 60%。
这不是选择题。是要算完、写出来、还得对。
跑的环境叫 Stirrup,Artificial Analysis 自己的开源框架,能用代码执行、网页搜索、抓网页、看图,最多 250 轮。
评委是 GPT-6 Luna,不是谷歌自己的模型。
谷歌说,专家人工打分和自动评审的一致率是 96%。这句是谷歌说的,Artificial Analysis 文章里没提。
十个行业,没有一个通吃
Artificial Analysis 写得很细,我照着抄下来:
Claude Fable 5.2 拿五个行业,软件与数据、工程、物流与地图、商业、金融,金融那栏和 Sonnet 5.5 并列。
Claude Opus 5.5 拿教育、建筑。
Gemini 4 Argon 拿科学。
Gemini 4 Carbon 拿医疗。
Claude Sonnet 5.5 在法律与政府这一栏险胜。
总榜第二的 Carbon,在医疗这一栏是第一。
「第二」这个词的含金量,就这么被打散了。
六种交付文件,最难的是 Word 和纯文本
输出分六种文件类型。Word 文档和纯文本这两类分数最低,没有模型过 52%。
52% 什么概念。你要它交一份正经的 Word 报告,一半以上的概率得返工。
这个数是 Artificial Analysis 文章里的,谷歌那张配图没细分到文件类型。
那个「6 倍」我打算怎么用
先看行业那一栏,再看成本。总榜只用来筛掉明显不行的。
原因很直白:我没跑过这些模型,也没拿自己的任务去试,【本人未实测】。
现在能确定的只有几条。分数是同一套。成本有两套。十个行业没有通吃。Word 和纯文本最难。
再往下,就得自己跑。拿自己二十条真活去试,比看总榜靠谱。
顺带一句,谷歌在另外三个基准上是第一:CursorBench 4.0、Perplexity 的 WANDR、Zapier 的 AutomationBench,官方说成本不到下一个外部模型的一半。
同一个模型,换个榜换个名次。
这也是我不太看单一榜单的原因。
你最近要是也在做选型,会先看总榜,还是先找自己那一行?