11 月 5 日,GitHub 发了一篇工程博文,讲他们把 Git 的存储层整个换掉了。署名 Karthik Raman 和 Brian Celenza,标称 16 分钟阅读。
我先看的是数字。
单个仓库,5000 个智能体同时干活,每秒 7200 次推送,读延迟还是稳的。这是官方内部压测的结果。
另一头是这样的:今天 GitHub 上最繁忙的仓库,一秒最多也只写几十次,而且是断断续续的短脉冲,不是持续输出。
我把官方那句原话抄在这儿。原文:Instead of planning for the next increment, we set a target of at least two orders of magnitude more scale.
不按下一档规划,直接按至少两个数量级做。两个数量级,一百倍。
这两个数不能直接相除
先说清楚一件事:几十次和 7200 次不是一个东西。
几十次是真实仓库当下的需求。7200 次是新架构内部压测能撑住的上限。
一个是水位,一个是坝高。
我自己没跑过这类系统的压测,也没接触过 GitHub 的内部环境。下面所有理解,都是从这篇博文和 IT之家 的报道里读出来的。【本人未实测】
我试着除了一下:把「几十」按 30 估,7200 ÷ 30 得 240。这个 240 倍没有任何官方依据,纯粹是我自己按的,别当数据用。
有意思的是动手的时点,不是那个 7200
老架构有个很具体的瓶颈,博文写得不含糊。
博文里那种写法,是把一个仓库所有引用的状态,做成一份索引在单个 blob 上的预写日志。每次更新,都是对这个 blob 的一次条件写。
而同一个 blob 同时只能有一个条件写在路上。
所以哪怕把一次写入期间到达的所有推送批处理成下一批,仓库的写入天花板也就是「一次写入一个来回」。
实测结果,官方原话:In practice, this netted us write throughput in the mid-hundreds per second.
中几百次每秒。
这里才是我觉得值得看一眼的地方。
把「中几百」按 500 估,把真实需求「几十」按 50 估,两者之间还差着大约十倍。这两个取整都是我自己的,官方没这么算。
也就是说,离天花板还有相当一段距离的时候,他们就把地基刨了重铺。
理由博文里也写了:智能体是 7×24 小时不间断跑的,等那批短脉冲变成常态化的持续写入,再动手就来不及了。
一次提交,会引出多少读
这一段我建议非技术的读者也看一眼。
推一次代码,不只是一次写。CI 流水线立刻起来跑,部署系统紧跟着拉一遍新提交,旁边还有别的智能体拉下来当上下文。
官方管这个叫 read fan-out,读的扇出。原话是 a large amplification effect on overall traffic that scales with writes,对整体流量形成很大的放大效应,而且放大倍数跟着写入量一起涨。
具体放大了多少倍,官方没给数字,我也没有数据可以量。【暂无相关资料】
但博文放了一张图。
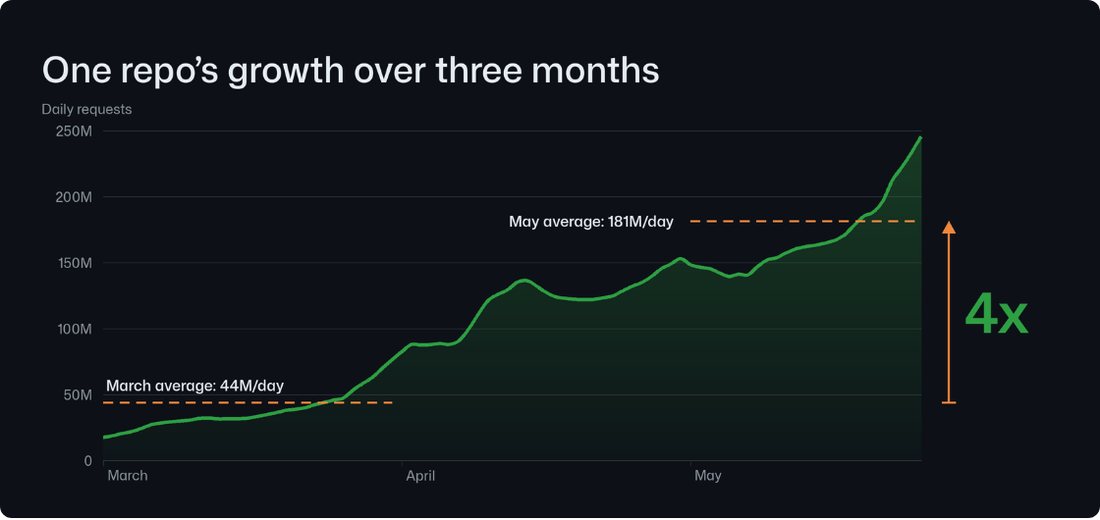
一个仓库,3 月到 5 月,日请求从 4400 万涨到 1.81 亿,官方标的是约 4 倍。181 除以 44 等于 4.1,对得上。
这两个数是我从图里读出来的。图内标注字很小,手机上看要放大,正文里我已经写全了。
博文还补了一句:此后这条曲线仍在指数级上升。
能这么改,是因为 Git 二十年前就把答案埋好了
技术部分我尽量说人话。
Git 的对象不可变,按内容命名。同一份内容算出来的名字永远一样。
所以两个写者同时存对象,根本不用商量,因为它们不会写到同一个位置去。
一次推送里真正需要商量的,只有引用更新,也就是把分支指针挪一下。而引用更新按官方说法是 tiny in comparison,小得多。
老架构的毛病就出在这儿:它把整个仓库的引用当成一个 blob 来条件写,一次只能一个在飞。一个很小的协商步骤,卡住了整条流水线。
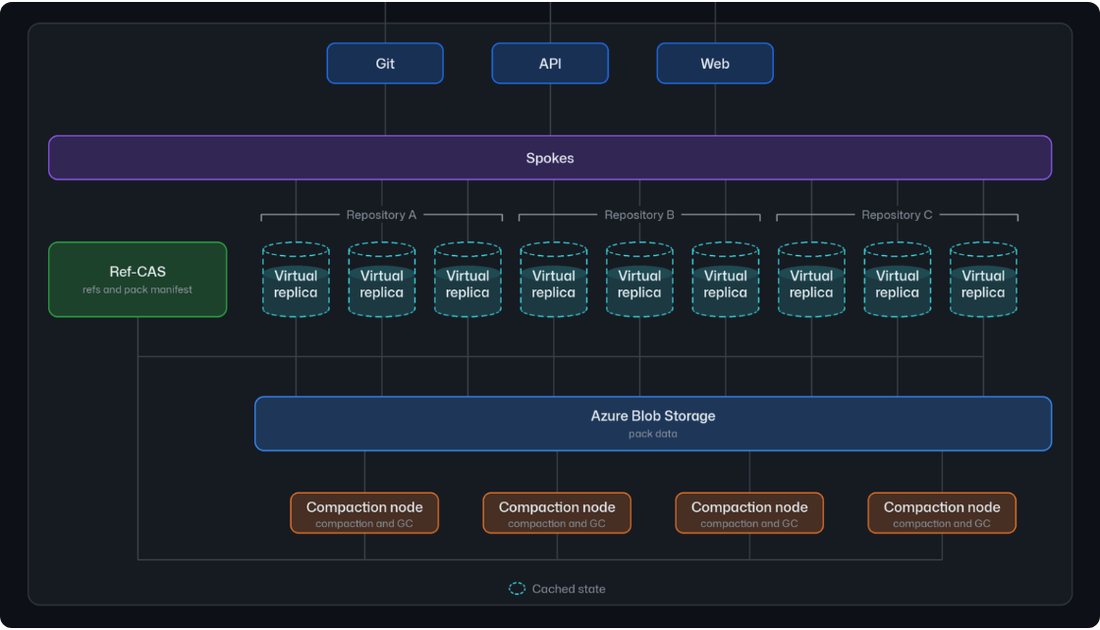
新架构叫 Ref-CAS,Reference Compare-and-Swap。每次引用更新是一次比较并交换,由多数派提交。事务只锁它碰到的那几个引用,核对值没被人改过,多数副本记下来就生效。
博文里有句话我认为是整篇最有信息量的:Agents mostly push to their own branches, so most updates don't contend, and they replicate in parallel.
智能体大多推自己的分支,所以大部分更新根本不冲突,可以并行落地。
读的那一头也是同一个思路。虚拟副本先报自己手上的版本号,如果版本还是最新的,回复里根本不带引用。原话是 an unchanged repository costs a single comparison。
没变化的仓库,代价就是一次比较。
代号 Rubicon
架构代号叫 Rubicon,卢比孔河。
官方给的解释是:a nod to the point of no return the industry crossed with agentic development。说的是这个行业已经跨过的那条不可回头的线。
凯撒渡河那段历史是我自己联想的,博文没提,我只是觉得这名字起得挺准。
设计从 2026 年 5 月起步。这个时点有点意思,上一篇文章讲的 Azure 迁移刚落地,99.99999% 的仓库迁进 Azure,紧接着就开始画新图纸。
跟你有什么关系
说句实在的,如果你不维护大型仓库,可能真没什么直接关系。
IT之家 的报道说,这套架构目前是小范围定向内测,计划明年初逐步扩大开放范围。
但有一条我觉得可以记一下。
以后你抱怨「CI 怎么又慢了」,原因可能不再是机器不够快。可能是同一份代码,读它的东西变多了,而其中一部分读者不是人。
至于具体哪个项目、什么时候会撞上这个问题,【本人未实测】,博文没给,我也没数据。
我读完之后留下的一句
7200 这个数本身不稀奇,硬件堆上去总能到。
稀奇的是时点。真实需求才几十次每秒的时候,去造一个 7200 次每秒的东西,理由不是「现在不够用」,是「再过一年就不够用」。
这种决定通常做不出来。做成了,事后叫有远见;做砸了,就是过度工程。
这次算哪一种,得等明年开放之后才知道。
你手上有没有那种「写得不多、但被疯狂读」的仓库?