先说三组数
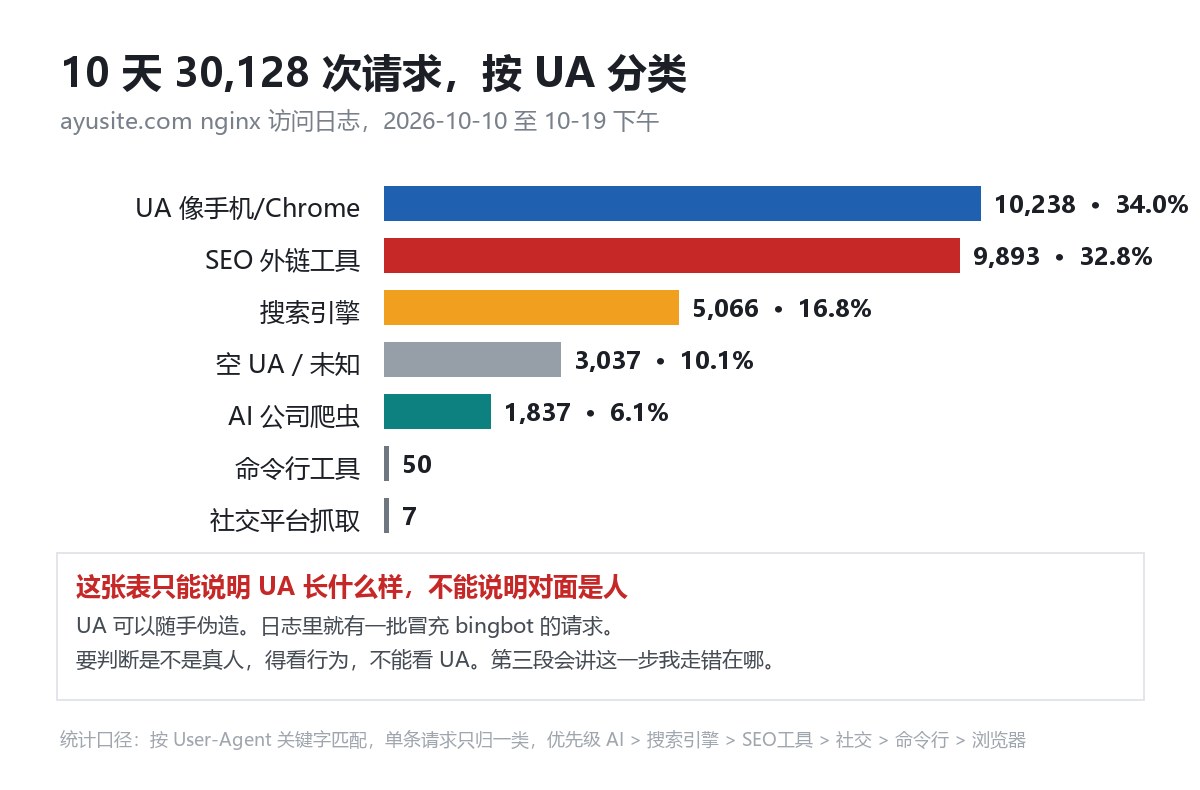
10 天,30,128 次请求,来自 9,263 个 IP。
按 User-Agent 分类:AI 公司的爬虫 1,837 次,占 6.1%。卖外链的 SEO 工具 9,893 次,占 32.8%。状态码 404 的占 43.1%。
我原本最关心第一条。查完发现,最值得说的不是它。
还有一件事得放在前面:这篇文章里有一个我一开始用错、后来被迫推翻的判据。 我会原样把过程写出来,因为它比结论更有用。
日志怎么算的
素材是站点 nginx 的 access 日志,2026 年 10 月 10 日到 10 月 19 日下午,10 个文件,逐行解析。
每行能拿到的字段:来源 IP、时间、请求路径、状态码、Referer、User-Agent。
分类靠 User-Agent 里的关键字。我没装现成的分析工具,自己写了一份对照表,把爬虫分成“AI 公司 / 搜索引擎 / SEO 工具”三组。
单条请求只归一类,优先级从高到低:AI、搜索引擎、SEO 工具、社交平台、命令行、浏览器。
我第一版把 52.3% 算成了 AI
第一遍跑出来的结果是:AI 爬虫占 52.3%。
当时的分类表里,我把 MJ12bot、AhrefsBot、PetalBot 全算进了“AI 爬虫”。因为它们的名字里都带 bot,抓得也特别勤。
后来翻 UA 原文看到这一行:
`Mozilla/5.0 (compatible; MJ12bot/v1.4.8; http://mj12bot.com/)`
点进去才知道,这是 Majestic 的外链分析工具。AhrefsBot 是 Ahrefs 的,做同样的事。
这两个跟大模型没有一毛钱关系。
重做分类之后,AI 爬虫从 52.3% 掉到 6.1%。
所以下面这些数字,都是修正过的口径。
AI 爬虫 1,837 次,按公司拆开是这样
字节跳动 491、Anthropic 472、Meta 312、OpenAI 234、Amazon 207、Common Crawl 121。
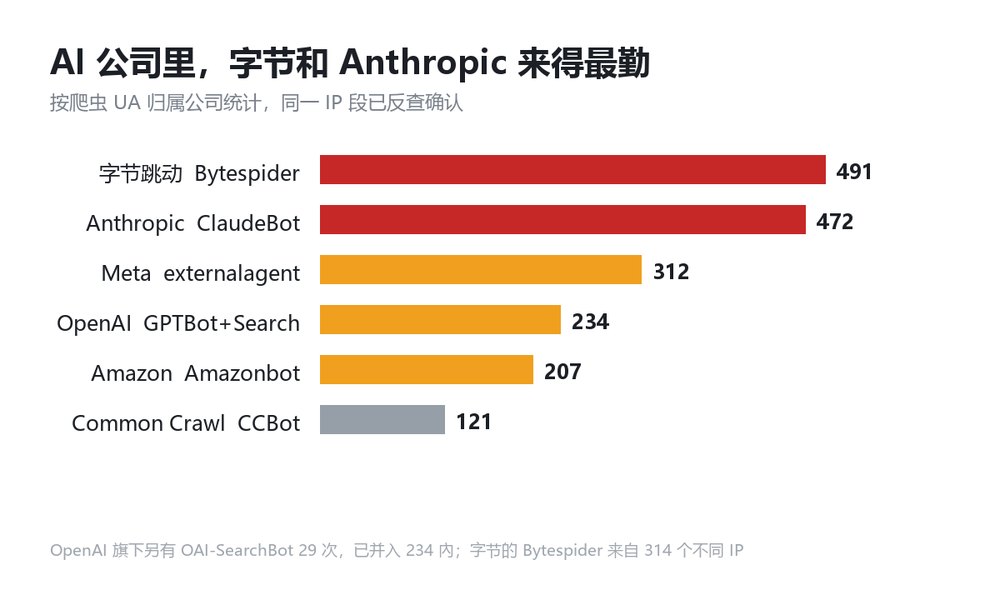
这些数我没只看 UA 就信。UA 能伪造,我这个站的日志里就有一批冒充 bingbot 的。
所以我拿 IP 去反查了归属。有几台带 PTR 记录,域名直接把身份写明了:
- `bytespider-122-14-227-34.crawl.bytedance.com`,字节
- `petalbot-114-119-130-253.petalsearch.com`,华为
- `18-97-14-85.crawl.commoncrawl.org`,Common Crawl
- `3-220-70-171.crawl.amazonbot.amazon`,亚马逊
GPTBot 和 ClaudeBot 那批没有 PTR,落点分别是 Microsoft 和 Amazon 的网段。OpenAI 用 Azure、Anthropic 用 AWS,跟它们各自公布的做法对得上。
这里是我的判断,不是日志能证明的事实。 我认为它们可信,理由是 UA、IP 段、访问路径三样能对上。要伪造到这个程度,成本已经高于收益。
真正的大头,是卖外链的
Majestic 4,580 次,Ahrefs 4,554 次,Semrush 518 次,还有一个 Reflectionbot 241 次。
加起来 9,893 次,32.8%。是 AI 爬虫的 5.4 倍。
这两家干的事,是扫全网的链接和排名数据,打包卖给做 SEO 的人。它们每天准点来,抓得很整齐,抓完就走。
说不清是好事还是坏事。至少说明这个站进了它们的索引,做优化的人查得到。但它们消耗的带宽,是我在付钱。
搜索引擎里,华为来了 4,038 次,百度 15 次
PetalBot 4,038 次,只用了 9 个 IP。
同一时间段:Apple 429 次,Google 248 次,Bing 180 次。
百度 15 次,来自 12 个不同 IP,平均每个 IP 来 1 次多一点。
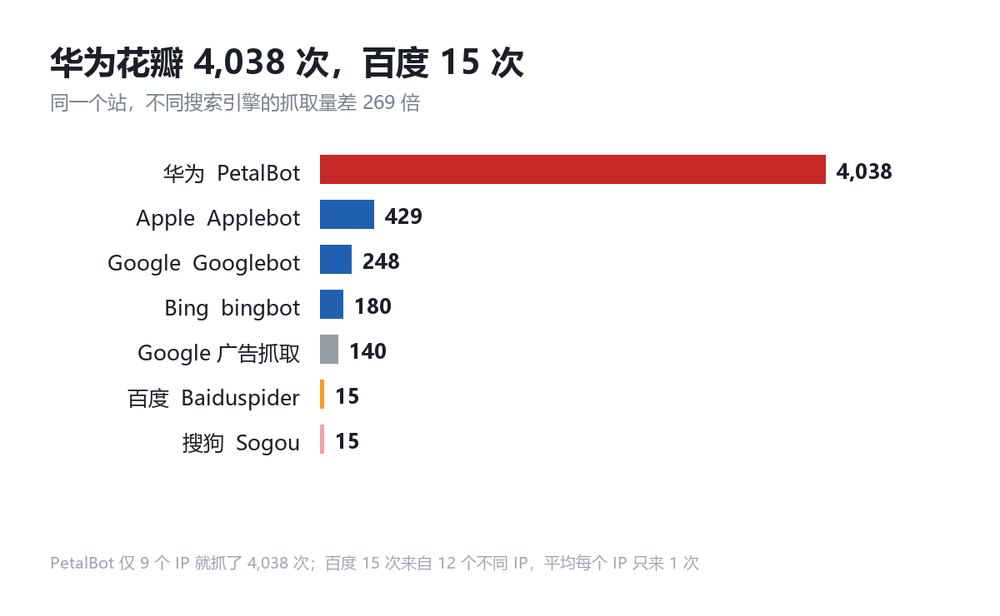
这个对比我不想过度解读。抓取频率跟站点权重、提交渠道、robots 设置都有关,我不掌握百度的调度逻辑。
但 15 次这个量级,基本等于没抓。
接下来这一段,是我搞砸的地方
按 UA 分完类,下一个问题自然是:那 10,238 次“UA 像手机、像 Chrome”的请求里,到底有多少是活人。
我的想法很直接:真人打开网页,浏览器会一起要 CSS 和 JS。爬虫只要 HTML。所以只要看“哪个 IP 请求过样式表”,就能筛出真人。
跑出来第一个数就让我停了:10 天,CSS 请求只有 2 次。
30,128 次请求,样式表被要了 2 次。这不可能是真的。
我去翻了 nginx 配置,找到了原因:
样式表和图片的访问日志,被我自己关掉了。
`/uploads/` 也是一样,`access_log off`。
当初关掉是为了减少日志量、省磁盘。现在报应来了:这个站最关键的判据,恰好落在日志的盲区里。
所以那个“CSS 只被请求 2 次”不是事实,是我看错了。任何基于“有没有加载样式表”的结论,在这个站上都算不出来。
换成 favicon,能算,但要打折
样式表在 `/assets/`,favicon 在根目录,没被关日志。
10 天里 `/favicon.ico` 被请求 150 次,来自 143 个 IP。
同期,取过 HTML 页面的浏览器类 IP 有 7,023 个。
143 比 7,023,是 2%。
按道理,真人用浏览器打开页面,几乎必然会请求一次 favicon(除非之前缓存过)。所以这 143 个 IP 是最接近“真的打开过页面”的一组。
但我得说清这个数的两个问题:
第一,爬虫也会请求 favicon。 有几个抓取工具会把首页资源一并取走,所以 143 里混着机器。
第二,7,023 这个分母本身不干净。 它的判定依据只有“UA 里带 Mozilla 且不带 bot 字样”,而 UA 是随手能改的。日志里就有一批明显的例子:某个 IP 用手机浏览器的 UA,10 天里来了 433 次,却从没请求过任何资源文件。
所以更准的说法是:7,023 个自称浏览器的 IP 里,只有 143 个留下了“打开过页面”的行为痕迹。 剩下那些,UA 写着浏览器,做事却像脚本。
6,637 个 IP,10 天只来过 1 次
这个数本身就很说明问题。
浏览器类请求分布在 7,144 个 IP 上,其中 6,637 个只来了一次,占 92.9%。
一个真人如果对站点内容有兴趣,翻两页、点开一篇文章、回头看一眼,请求数都不止 1。只来 1 次、只要 1 个 HTML、不要任何资源,这个组合更像脚本。
顺带提一句,还有 2,949 次请求完全不带 UA,来自 25 个 IP。其中一个 IP 单独贡献了 392 次。
43% 的请求,目标是根本不存在的页面
状态码分布:200 正常返回 8,274 次,占 27.5%。302 跳转 8,437 次,占 28.0%。404 不存在 12,992 次,占 43.1%。
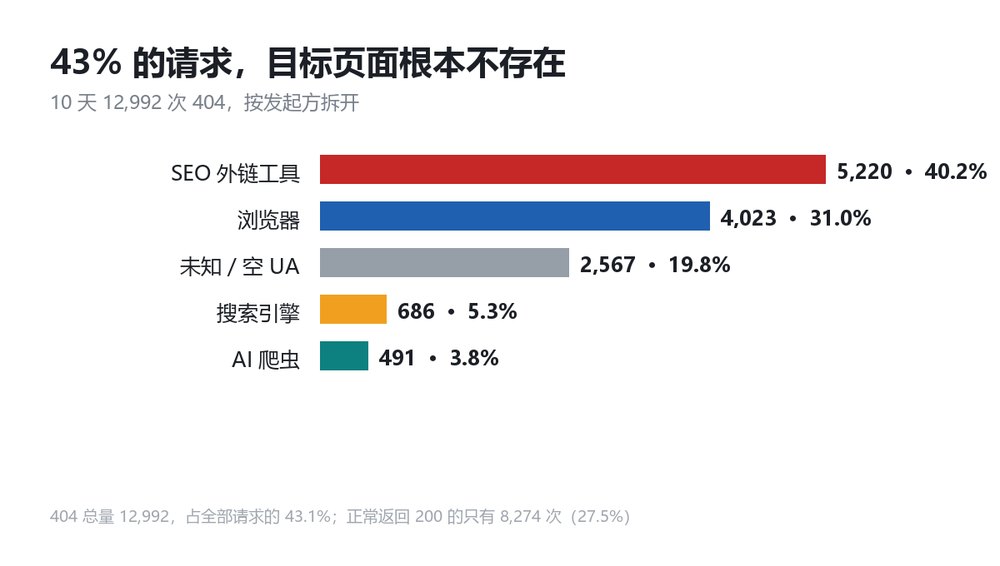
404 里最大一块是 SEO 工具,5,220 次。抓得最多的地址是 `/tag/`,565 次,这个路径在我站上不存在。
其次是浏览器类 4,023 次,未知来源 2,567 次,搜索引擎 686 次,AI 爬虫 491 次。
还有人在扫 WordPress 漏洞:`/wp-content/plugins/hellopress/wp_filemanager.php`、`/xmlrpc.php`、`/1.php`、`/this_is_a_new_hello_world.php`。这个站是 PHP 自己写的,跟 WordPress 无关,这些请求全部 404。
CCBot 那 121 次里,86% 抓的是 `/Detail/...` 这类老 ASP 路径,也全 404。看着像它库房里还留着这个域名很多年前的旧索引。
我现在的判断,以及还没搞清的
能确定的:AI 爬虫占 6.1%,卖外链的占 32.8%,404 占 43.1%,这三个数用不同方法交叉验过,站得住。
不能确定的:到底有多少真人。我能给出的最严谨的说法只是“7,023 个自称浏览器的 IP 里,143 个留下了行为痕迹”,这既不是真人数的上限,也不是下限。
其中一半原因在我的配置上。 关掉静态资源日志这个决定,让这个问题从“能算但费劲”变成了“算不出来”。
我打算改两件事:把 `/assets/` 的日志打开(只记 css 和 js,不记图片,控制量);统计口径从“总请求数”换成“有资源加载的会话数”。
改起来是几分钟的事。难的是改完之后,面对那个会小很多的数字。
顺带说一句,我原本担心的方向也偏了。我以为 AI 爬虫在大量抓内容,实际它们 10 天只来 1,837 次。反倒是卖外链的来了近一万次。
担心错对象了。
你手上要是有自己的站,先去看一眼 nginx 配置里有没有 `access_log off`。有的话,你手上那份日志可能也缺了最重要的那一半。
看完欢迎在评论区说一声你那边是什么情况。