把一篇文章里的字随机换掉三成,用 SimHash 去查重,只有一半能查出来。同一批样本,换成 MinHash 是九成五,换成 Jaccard 是十成。
这组数字来自 360 个正样本对和 600 个负样本对。正样本是同一篇文章被改动之后的样子,负样本里有一半是毫不相干的文章随机配对,另一半是同题材的两篇不同文章。
负样本怎么选,决定这张表可不可信
先说这个,因为它是整组测试里最容易做假的地方。
如果用不相干的文章当负样本,五种算法都能拿到满分,这种结果没有信息量。真实的误报风险来自同题材文章:两篇都讲大模型原理、都用同一批术语、引同一批概念,字符二元组的重合度天然就高。所以我按每篇最高频的 60 个二元组的重合度,挑出 300 对最像的不同文章作为困难负样本。这一轮挑选只用了频次统计,没有用后面要评测的任何分数。
正样本有四种改法。按比例替换字符,比例取 1%、2%、5%、10%、20%、30%;插入 3 句别处的句子;删掉连续的 15%;把段落顺序打乱。
衡量方式用两条。AUC 看排序能力,不受阈值影响;检出率固定在误报率 1% 的位置上算,这个更贴近实际部署,因为线上不会允许 5% 的正常文章被误判成抄袭。
五种算法的成绩
| 算法 | AUC(困难负样本) | 误报1%时检出率 | 耗时 | 正样本最低分 | 困难负样本最高分 |
|---|---|---|---|---|---|
| Jaccard 二元组 | 1.0000 | 100.00% | 0.16s | 0.3109 | 0.1576 |
| Jaccard 三元组 | 1.0000 | 100.00% | 0.20s | 0.1974 | 0.0825 |
| 余弦 TF-IDF 二元组 | 1.0000 | 100.00% | 0.88s | 0.5893 | 0.3823 |
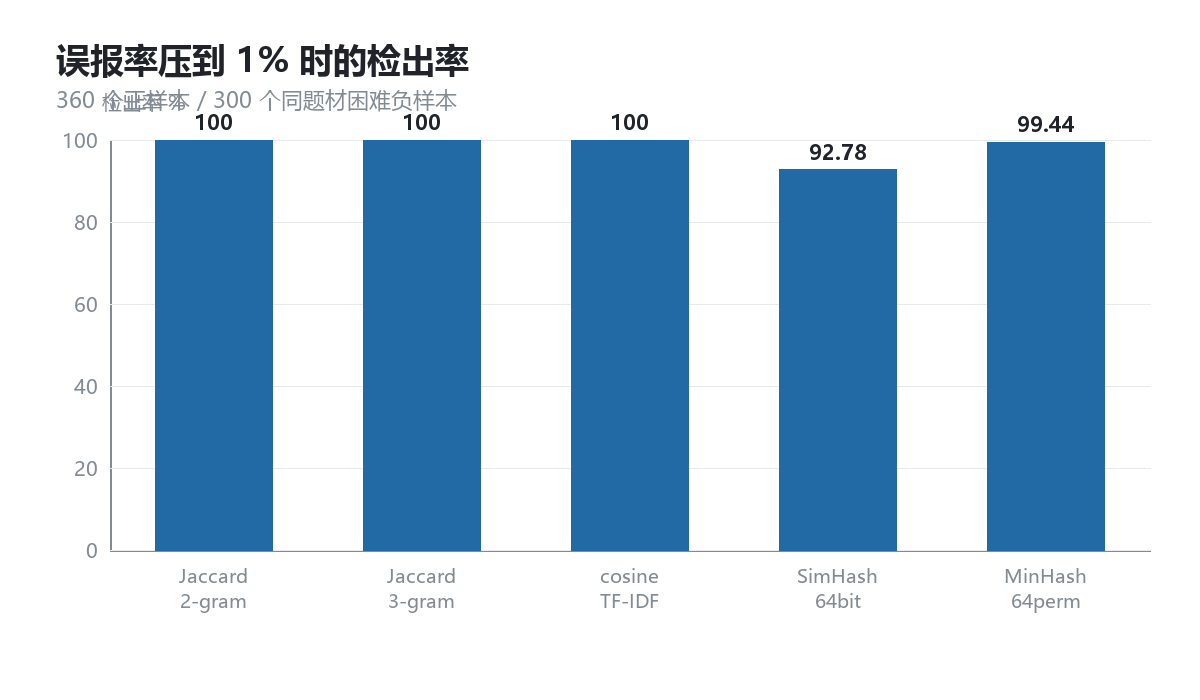
| SimHash 64 位 | 0.9939 | 92.78% | 0.02s | 0.5938 | 0.7344 |
| MinHash 64 排列 | 0.9999 | 99.44% | 0.02s | 0.1094 | 0.1562 |
三种集合类算法把两类样本完全分开了。正样本最低分都比困难负样本最高分高出一截,中间留着一大片空档,阈值怎么定都不会错。
SimHash 那一行最后一列是 0.7344,比正样本最低分 0.5938 还高。这意味着在分数轴上,最不像重复的正样本和最像重复的负样本是交叉的。你把阈值定在 0.59 想全收,误报立刻爆掉;定在 0.74 想压住误报,一半以上的正样本漏掉。调参救不了这一维,特征本身就分不开。
改到三成,SimHash 掉到一半
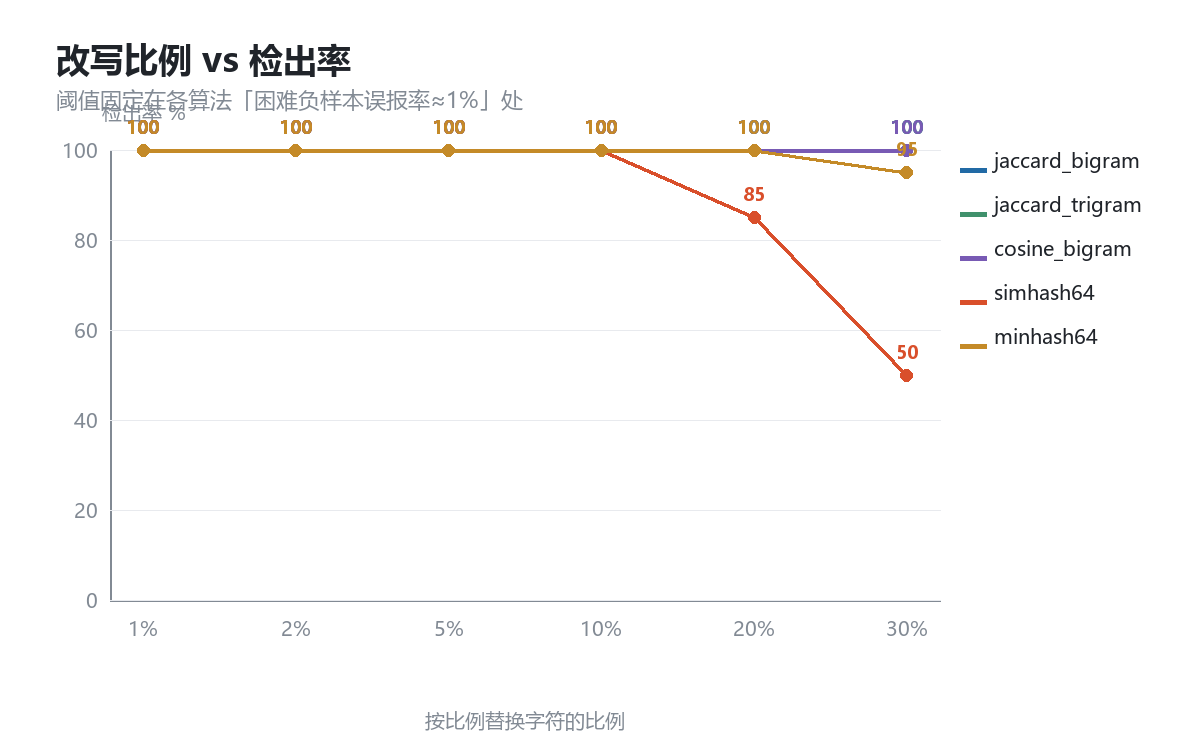
把阈值固定在各自困难负样本误报率 1% 的位置上,再看不同改动强度下的检出率。
| 算法 | 1% | 2% | 5% | 10% | 20% | 30% | 插3句 | 删15% | 打乱段落 |
|---|---|---|---|---|---|---|---|---|---|
| Jaccard 二元组 | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
| Jaccard 三元组 | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
| 余弦 TF-IDF | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 |
| SimHash 64 位 | 100 | 100 | 100 | 100 | 85.0 | 50.0 | 100 | 100 | 100 |
| MinHash 64 排列 | 100 | 100 | 100 | 100 | 100 | 95.0 | 100 | 100 | 100 |
改动在 10% 以内的时候,五种算法都能全收。分水岭出现在 20% 之后。SimHash 在 20% 掉到 85%,30% 掉到 50%。MinHash 到 30% 还有 95%。
插句、删段、打乱段落这三种改法,五种算法都是满分。算法没多厉害,是这三种改动几乎没动字符本身。句子被挪到别处,字符二元组的集合基本不变,打乱段落的余弦相似度是 0.9994,跟原文几乎一样。这类算法对结构完全不敏感,所以它判断的是文字重复而不是文章抄袭。同一篇文章换个顺序,它照样认成重复,这在查重场景里是对的,在判断原创性时就不够。
速度差 40 倍,但省下的时间不值钱
余弦那档 0.88 秒,Jaccard 二元组 0.16 秒,SimHash 和 MinHash 都是 0.02 秒。
这个差距看着悬殊,放到实际量级上就没了意义。这批数据是 399 段文本、1000 对比较。真要处理十万篇文章,两两比较是五十亿对,那时候单次快 40 倍已经不重要,关键是能不能避免两两比较。做法是先粗筛再精算:用 MinHash 或者 SimHash 的分桶把候选压到千分之一,剩下的才用 Jaccard 精算。
这个组合其实把两边的优点都用上了。SimHash 分桶快,但分桶之后的精算不能靠它自己。我测的这一轮里,把 SimHash 当唯一判据的地方,正是它掉到 50% 的那一档。
选哪个
如果只想要一个能直接用的,MinHash 64 排列性价比最高。误报 1% 时检出 99.44%,速度跟 SimHash 一个量级,分数轴上正负样本还留着空档。代码量比 Jaccard 多一点,但没有到麻烦的程度。
如果文章不长、数量也不大,直接用 Jaccard 二元组。0.16 秒,满分,实现只有几行,好排查。
SimHash 我建议只用在两个地方:一是海量数据的第一层粗筛,二是改动幅度明确很小的场景,比如同一篇文章的不同排版版本。拿它当唯一判据去抓 AI 改写稿,30% 那一档会漏一半。
这组测试没覆盖什么
改动方式只有字符替换、插句、删段和调序,都是机械改动。真实的 AI 改写会换同义词、变句式、重排论证顺序,字符层面的重合度下降得更快,但也可能出现一种情况:意思一样而字面全变,这时候五种算法全部失效。要抓那一类需要语义比对,光靠字面特征做不到。
语料是 40 篇中文技术文章,同一个题材域。困难负样本是我按高频二元组重合度挑的,挑法本身可能带偏。换到新闻、小说、论文这些题材,阈值要重新定,不要直接搬这组数字。
还有一点,报出来的都是相对指标。360 个正样本里每种改动强度只有 40 个样本,30% 那一档 SimHash 掉到 50%,是 40 个里有 20 个漏掉。数量不大,方向可信,小数点后面的精度别当真。