站里发文章前要过一遍敏感词。我一开始写的版本就两行,一个 for 循环,一个 in 判断。
后来有人跟我说,词库上千条就该上 AC 自动机了,那是标准做法。
我就量了一下。
量完发现,这话对一半。
先说清楚我拿什么在测
语料是真的。
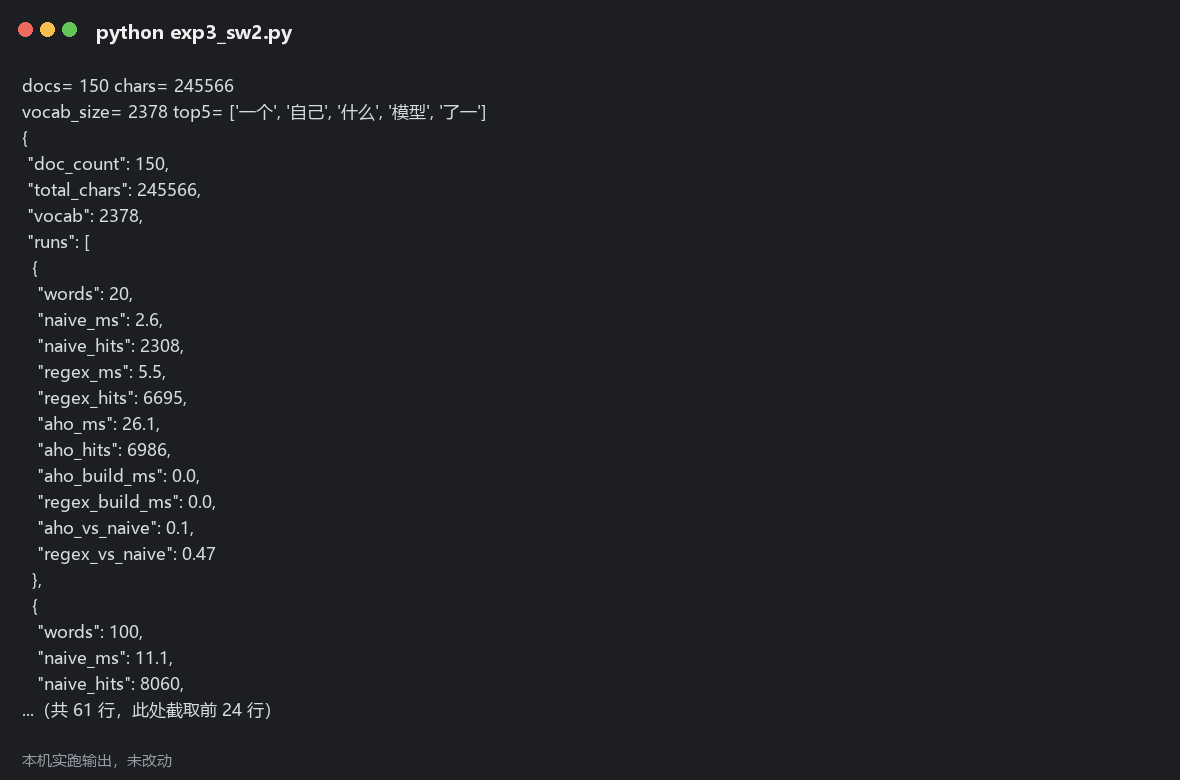
从站里数据库导出 150 篇已发布正文,去掉标签,一共 245566 个字。
词库是假的。真实的敏感词表我拿不到,就用这三万多字里出现频率最高的中文子串凑了一份,2378 条,长度二到四字。
换成真词表,耗时量级不会变,因为决定耗时的只有两件事:语料多长、词库多大。
命中多少个词,对速度几乎没有影响。
这点得摊开说,不然下面那张表就成了拿假数据装真结论。
词库 20 条:最笨的写法最快
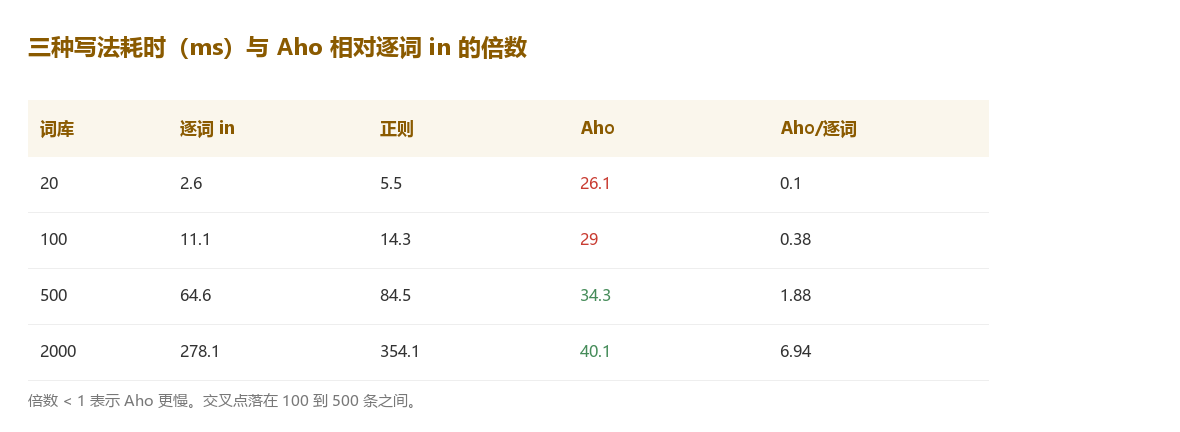
20 条词的时候,逐词 in 扫完 150 篇要 2.6 毫秒。
正则合并 5.5 毫秒。
AC 自动机 26.1 毫秒。
也就是说,教科书推的那个算法,比最笨的写法慢 10 倍。
我没预料到这个数。
我原本以为 AC 会一直赢,只是赢得多少的问题。
词库长到 500 条,才第一次反超
100 条的时候,逐词 in 是 11.1 毫秒,AC 是 29.0 毫秒。还是慢,慢 2.6 倍。
500 条的时候,逐词 in 涨到 64.6 毫秒,AC 是 34.3 毫秒。
第一次反超,快 1.88 倍。
2000 条的时候,逐词 in 278.1 毫秒,AC 40.1 毫秒。
快 6.94 倍。
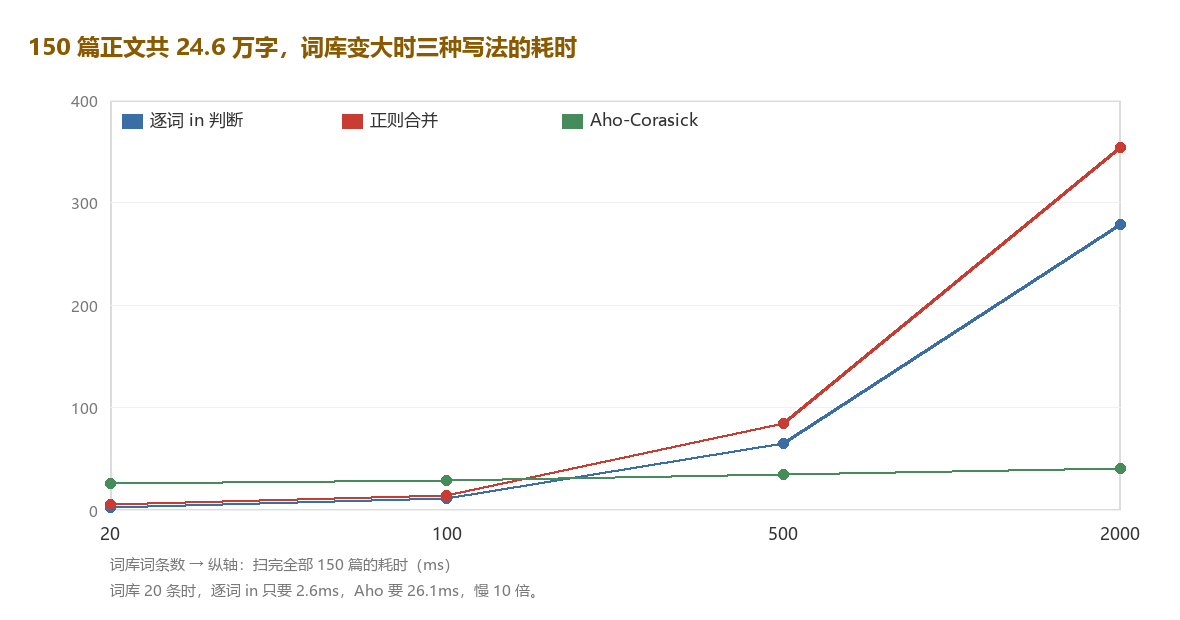
AC 的曲线几乎是平的。
20 条到 2000 条,它从 26.1 毫秒到 40.1 毫秒,涨了一倍多。逐词 in 从 2.6 涨到 278.1,涨了 107 倍。
这就是它们形状上的差别:逐词 in 的耗时跟词库大小成正比,AC 基本跟词库大小无关,只跟语料长度有关。
为什么会这样
Python 里的 in 是字符串查找,底层跑的是 C 写的子串匹配。
你在 Python 里写一行 in,实际那个循环是 C 在跑。
我那版 AC 是纯 Python 写的。
每读一个字,都要走一次字典查找、可能还要沿失败指针往上跳。
两边比的不是算法,是语言。
C 的常数因子把 O(词库大小乘语料长度) 这个劣势扛住了,只要词库不够大,它就赢。
词库大到一定程度,C 的常数也救不了,这时候算法才说了算。
一个必须说明的口径问题
表里三种写法的命中数不一样,而且差得很多。
2000 条词的时候,逐词 in 记到 46054 次,AC 记到 70899 次。
不是哪个算错了。
逐词 in 每篇每词只记一次,一个词出现十遍也只算一次命中。AC 走的是每个位置都报,出现十遍就记十次。
所以这三列的命中数不能拿来互相比,只能比耗时。我一开始想拿命中数当正确性校验,发现对不上,才回头查的原因。
还有一点:正则从头到尾都不划算
20 条时 5.5 毫秒,2000 条时 354.1 毫秒。
除了跟 AC 比在 20 条时快一点,它自始至终没赢过逐词 in。
正则的编译成本也低,2000 条才 1.1 毫秒,所以慢不在编译,在匹配。
这个我没细究【暂无相关资料】,只记下现象。
我自己怎么用的
【个人看法】站里的敏感词库现在不到一百条,我留的是逐词 in 那版。等到词库上千,再换 AC。换的时候有现成代码,改一个函数名的事。
为了几十条词去上自动机,除了让代码看起来更专业,没什么别的用。
没测的部分
只用了 Python 3.12,单核。
没测 PyPy,没测 re2 或者 Hyperscan 那种 C++ 引擎【本人未实测】。
真上生产,Hyperscan 这类大概率是另一个量级。
语料是 150 篇中文。
英文、代码的字符分布不同,结果会变。
也没有测多线程和并发,只测了单次扫全量。
一句话
选 AC 还是逐词 in,看词库多大。
一百条以内,别急着上算法。
你们那边的词库多少条?
如果已经上千,我很想知道实际跑起来差多少。