报价单只告诉你单价
要估「发一篇 1500 字的稿子,输入多少钱」,缺的是中间那一步:这 1500 字到底是多少 token。
报价单不会说。它只写每百万 token 多少钱。
所以这篇写的就是那一步。装包、数、换算,三步。命令都是我本机跑出来的,输出原样贴。
一、装
`pip install tiktoken`。
我这台机器上跑完是这样:
显示 already satisfied 是因为我早装过了。你第一次装会多几行下载信息,结尾一样。
顺手确认版本,0.14.0。
二、数
最小能用的版本就三行:
换成文件跑也没区别,把 `enc.encode(...)` 里的字符串换成 `open(...).read()` 就行。
我实际跑的那版多打印了两个东西:两个分词器都数一遍,另外把 token 的 id 号也打出来。
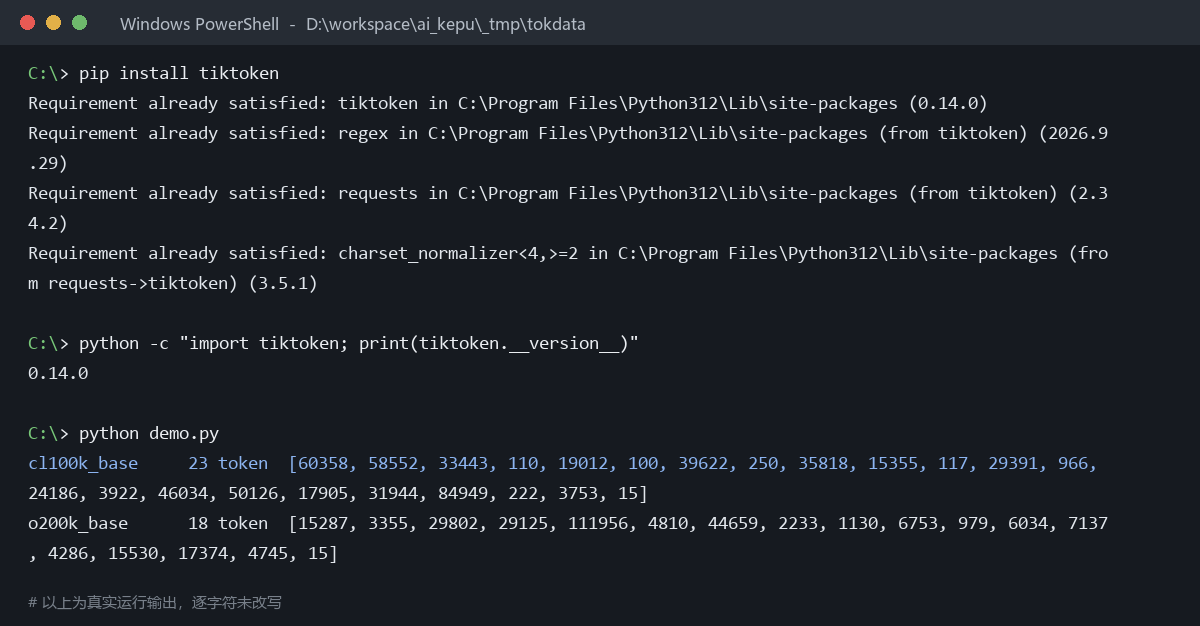
id 号本身没什么用。但想看清一个汉字到底被切成几块,它是唯一的证据。上一篇里那个「六个字切成九个 token」,就是靠这串数字拆出来的。
三、换算
有 token 数,剩下是乘法。价格我用的是 DeepSeek V4.1 Flash 官网标的三档:输入命中缓存 0.02,输入未命中 1.00,输出 4.00,单位都是元每百万 token。
价格是 2026 年 9 月页面上的。我只看了标价,没有实际调用接口验证过。
1500 字,按 1.575 token/字 算,2,362 个 token。
发过去、没命中缓存,¥0.0024。命中了,¥0.00005。让它吐同样长度,¥0.0094。
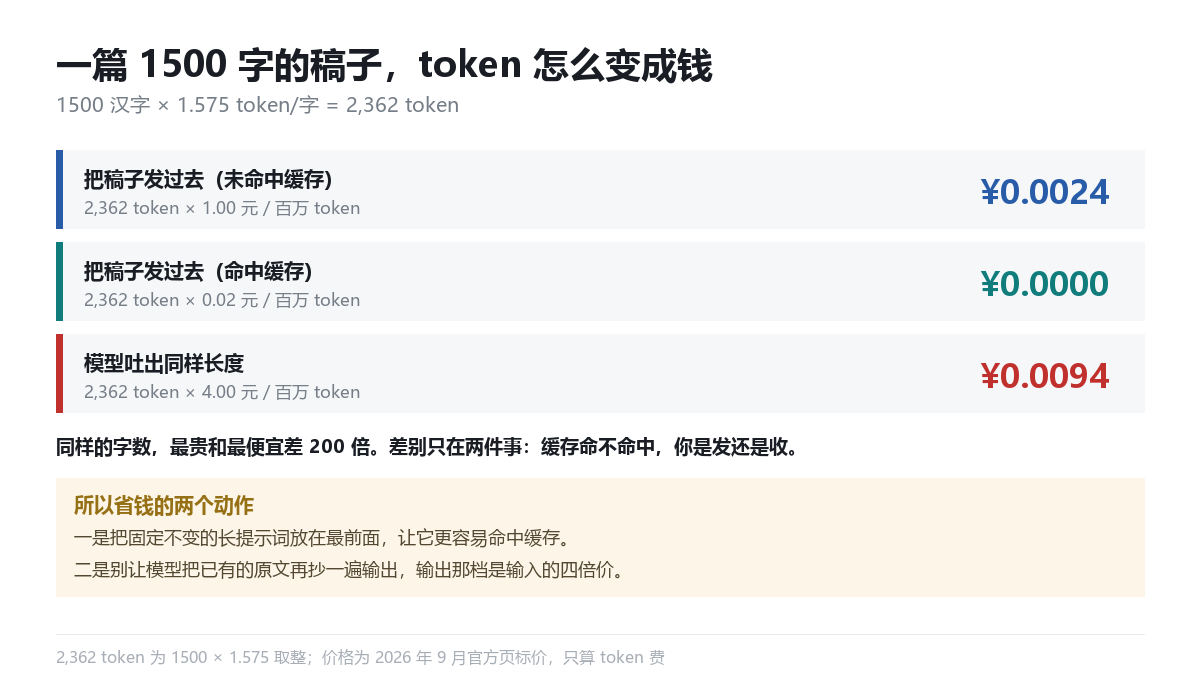
同样的字数,最贵和最便宜差 200 倍。差别只在两件事:缓存有没有命中,你是「发」还是「收」。
所以省钱的动作也就两个。一是把固定不变的长提示词放在最前面,让它更容易命中缓存。二是别让模型把已有的原文再抄一遍输出。
第一条我没法验证。缓存怎么算命中,官方只说「前缀相同」,具体边界我测不出来。
一张经验表,省得每次都跑代码
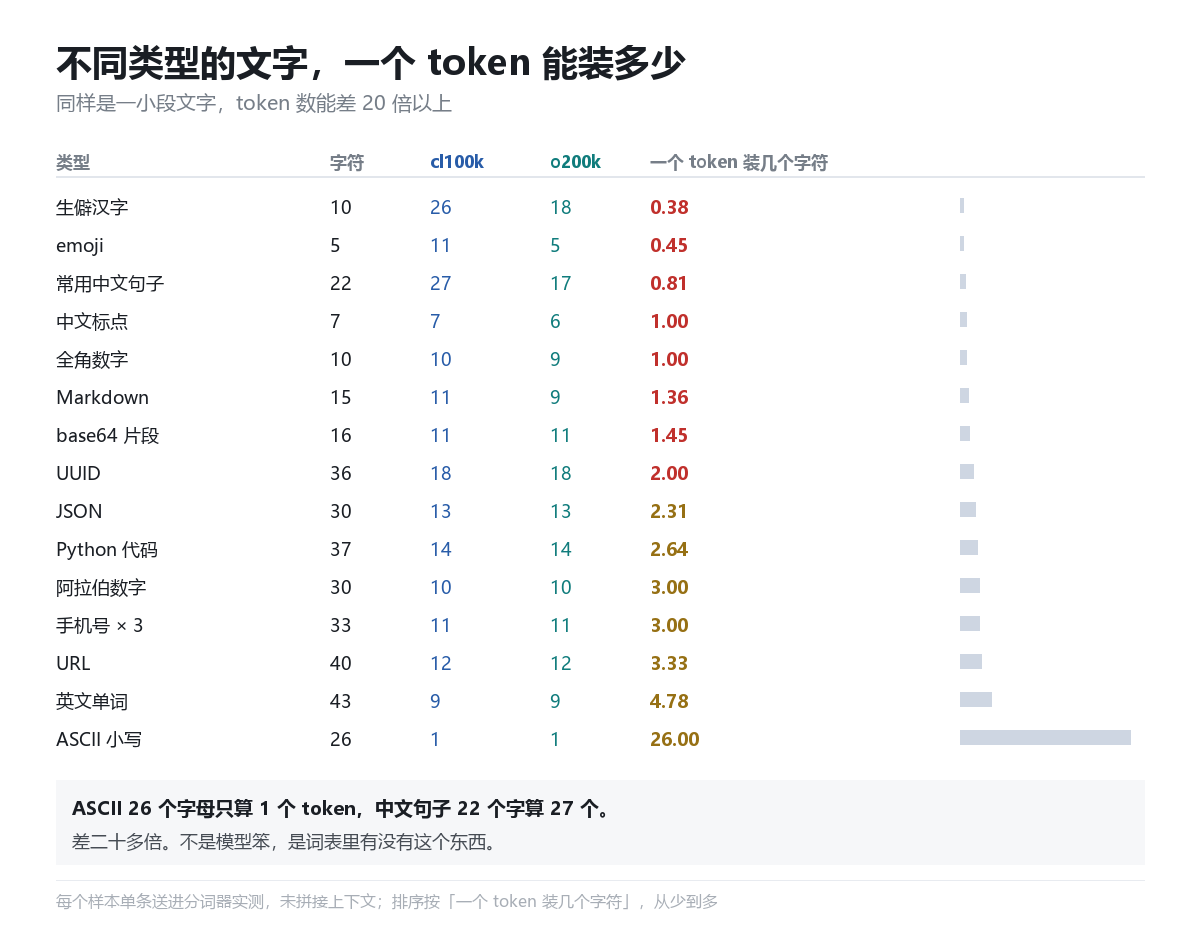
这张表是我挨个测的,每种只有一小段样本,所以它是「手感」,不是「标准」。
拿它估的时候注意一件事:别拿字符数当 token 数。
中文一个 token 装 1.2 到 1.6 个字符,英文单词能到 4.8,Python 代码 2.6,纯小写字母串 26。混着来的时候,估出来的误差会很难看。
反过来,最吃亏的是生僻字和表情符号。十个生僻汉字能吃掉 26 个 token,五个 emoji 在 cl100k 里是 11 个。
顺手测的一件事:中文是不是天生比英文贵
这句话我听了很多年。这次拿三组提示词试了一下,任务说明、输出格式、角色设定,各写一版中文一版英文,意思尽量贴近。
cl100k 底下:中文 151 个 token,英文 100 个。中文是英文的 1.51 倍。
o200k 底下:中文 108,英文 100。1.08 倍,基本拉平了。
所以「中文更贵」这句只在老分词器时候成立。词表里收了中文词之后,这个差距自己就消掉大半。
这三组是我自己写的一对一对译,不保证语义完全等价,样本也只有三组。当参考,别当结论。
几个我没验证的地方
接口返回的 usage。
各家接口一般都会返回 `prompt_tokens`、`completion_tokens` 这类字段,按理说那个数最准,比我这样本地数强。但我这次没有调接口,也没读返回,所以这段我没有实测,只能说到这儿。手上有 key 的话,跑一次就知道。
图片的 token。
我只测了纯文本。同一张图在不同模型里折算成多少 token,我没测,也不知道。
上下文里还有别的。
system prompt、历史对话、工具定义,这些全要占位置。这篇只算了正文。具体占多少,取决于你的框架怎么拼,我没法替它算。
tiktoken 只对 OpenAI 系准。
国内模型的分词器没公开,用它数出来的只能当参考。上一篇我比过两个公开分词器的差:同样的中文,能差 26%。国内模型的差多少,我不知道。
最后
装个包,三行代码,比猜准。
真要严谨,还是得以接口返回的 usage 为准,本地这步只是让心里有个数:到底是几百 token,还是几万。