-
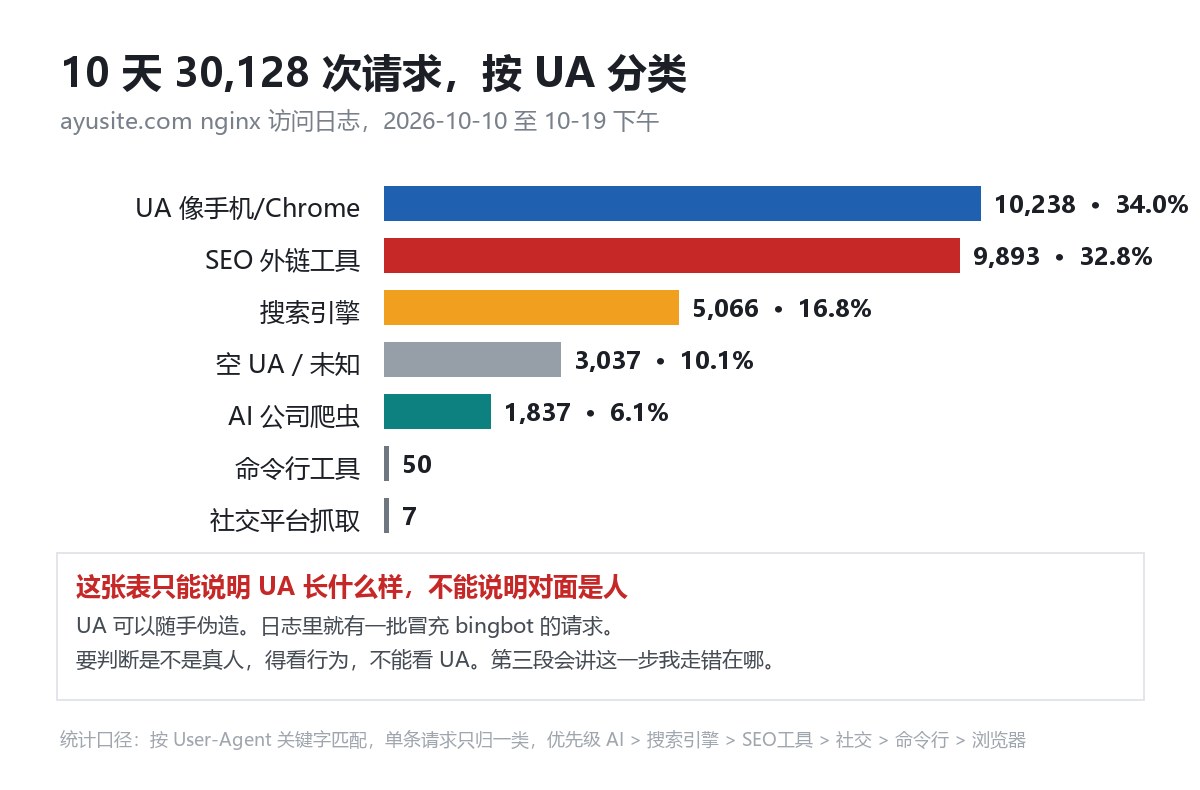 我扒了 10 天访问日志:3 万次请求,AI 爬虫只占 6%
10 天 30,128 次访问日志逐行拆开:AI 公司爬虫只占 6.1%,卖外链的 SEO 工具占 32.8%,404 占 43.1%。中间我想用「有没有加载 css」判断真人,结果发现这个判据被自己的 nginx 配置关进了日志盲区。
-
 AI 爬虫在我站上待了 10 天,真正读到文章的不到一成
Anthropic 的 ClaudeBot 来了 472 次,其中 57% 在读 robots.txt 和 sitemap.xml,落到文章页的只有 8%。OpenAI 的 OAI-SearchBot 更极端:29 次请求里 28 次在读 robots.txt。Common Crawl 的 CCBot 有 86% 在抓一个早就下线的老路径。
-
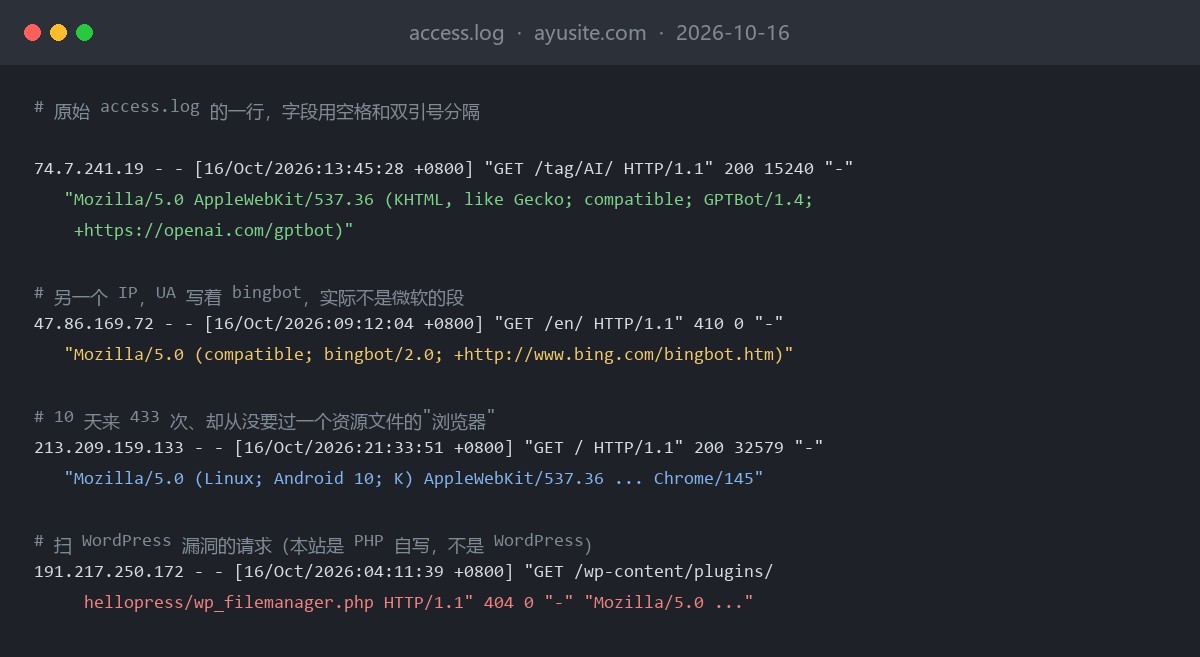 怎么查谁在爬你的站:从一条命令到一份 robots.txt
三步查清谁在爬你的站:数总量、按 UA 分组、查 IP 归属,再结合访问行为判断是不是真人。附实际跑通的 PowerShell 命令、我踩过的静态资源日志盲区,以及 robots.txt 怎么写才真的有用。