三条英文,来自几百公里高的轨道
「Blue marble below / Data streams in silent grace / Starlight feeds my core.」
这三行出自谷歌一颗原型卫星上的模型。10 月 30 日,谷歌宣布达成“Hello World”里程碑:在轨运行的数据中心级 TPU,第一次给出 AI 响应。
Hello World 是程序员写第一个程序时屏幕上打出来的两个词。谷歌把它用在这里,意思很明确:这台机器能跑了。
写诗不是这一轮要验证的东西。谷歌说,测试核心是芯片在微重力、剧烈温差和太空辐射下的稳定性与纠错能力。
但第一条提示词选了写诗,这件事有得看。
那颗卫星是怎么走到这一步的
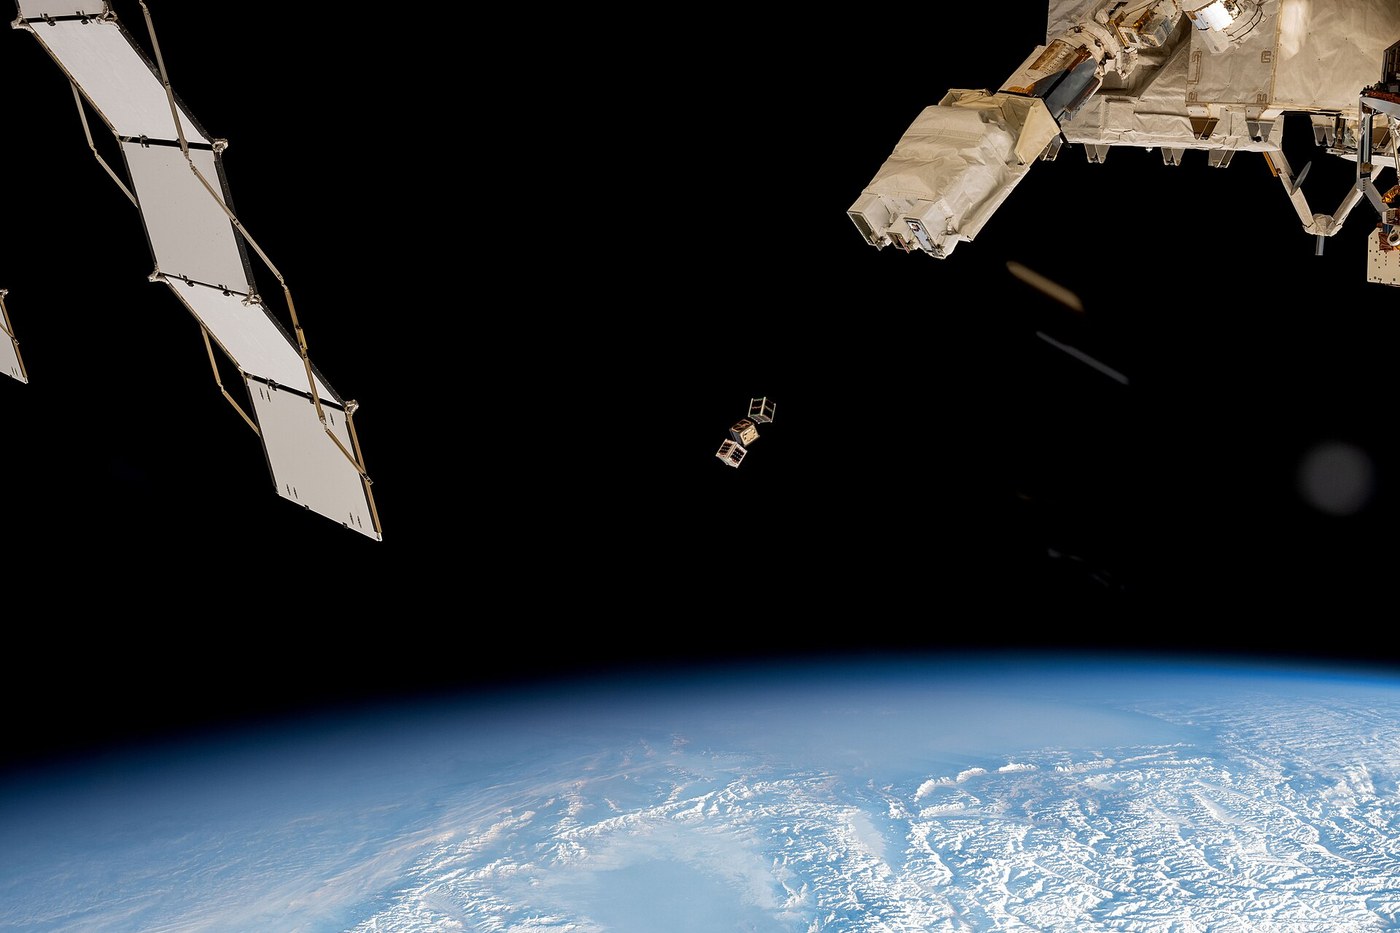
10 月 1 日,谷歌发射了“逐日者计划”(Project Suncatcher)的原型卫星。
之后几周,团队把在轨测试和调试清单一项项做完,包括为主机与 TPU 托盘通电,以及早期的机器学习测试。
10 月 30 日,才有了那三行诗。
同一天还测了轨道环境数据回传这类遥测任务。诗和遥测放在一起看,一次验证模型能不能开口,一次验证链路能不能回传。
那条指令只有一句话
地面工程师下发的首个提示词,要求预装在卫星上的谷歌 DeepMind 模型 Gemma 4,创作一首关于身处太空的俳句。
一句话,二十来个字。里面有三样东西。
体裁是俳句。位置是身处太空。任务是创作。
没有一个形容词,没有要求感人、震撼、有画面感。
短,因为三样东西都到位
第一样是体裁。俳句自带硬格式,五七五,三个短语,音节能数。给了体裁,等于给了结构。
第二样是位置。身处太空,说的是它在哪,不是它该有什么情绪。位置决定它说什么,情绪只能靠猜。
第三样是主题自明。在太空的模型写太空,不用再补背景。
我按英文音节数了一遍输出。Blue marble below 五个,Data streams in silent grace 七个,Starlight feeds my core 五个。
五七五,一格没差。
提示词里最管用的信息,往往是它在哪里、要写成什么形状,而不是你希望它多动人。
同一批测试里换了体裁
工程师还测了五行打油诗。打油诗是 AABBA 押韵加固定节奏,和俳句是两套完全不同的边界。
换一个体裁名,输出就换一套结构。这件事如果站得住,说明指令能控制形式,不只是控制话题。
控制话题很容易。你说写太空,它写太空。控制形式难,难在你得先知道有哪些形式可以点。
能带走的三条
给位置,别给形容词。“身处太空”比“写一首震撼的太空诗”有用。前者告诉模型它站在哪,后者只告诉它你想要什么感觉。
给体裁,等于给结构。俳句、打油诗、四行、七言、一百四十字,这些词在模型那里是现成的边界,不用你再解释一遍。
给能数的约束。行数、字数、音节,你自己一眼能验收。给十个形容词,你只能凭感觉判断像不像。
只说写首诗,会得到什么
模型也会交卷。但它会替你决定三件事:体裁、长度、视角。
这三样它替你定了,你就没法比较两次输出的差别。第三次想改,也不知道该改哪一句。
这条指令也有运气成分
写诗没有事实风险。写错了没人受伤,验证只看形式对不对。所以一句话够用。
换成让它报一组轨道参数,风险立刻不一样。二十分钟的运行窗口,一次辐射引起的位翻转,就可能给出一个看起来很正常、其实是错的数字。
谷歌把纠错能力放进测试清单,原因大概就在这里。太空里的错不会自己举手,只能靠机制抓出来。
二十分钟这个数字
卫星上装了四颗谷歌 TPU,最高一千瓦的电能。
受散热和能源负荷限制,每次只能开机约二十分钟。二十分钟到点,就关。
长期目标写在公告里:为将来在轨执行大规模推理的紧密编队卫星网络打基础。眼下这颗是原型,不是成品。
二十分钟的窗口,先让它写三行诗,是花时间最少的自检。三行英文,出来就能数。
要是它连三行都写不完整,后面的遥测任务也不用试了。
三行字之后
这三行大概进不了任何诗集。
但它是人类第一次在轨道上看到模型开口,而且开得挺守规矩:五个音节,七个,五个。
往后这套系统要做的,是在天上跑大规模推理。到那天,没人会记得第一句提示词问的是诗。
不过那一刻的答案留下来了。三个句子,一句话里一个画面,没有一个多余的形容词。