我给站里 151 篇文章做语义搜索,第一件事是把文章切块、变成向量。
真正卡住我的不是模型。
是检索这一步。
按网上的说法,十万级的向量扫一遍也就几十毫秒,随便优化一下更快。
我先量了没优化的那一版。
先说清楚这批数据是什么
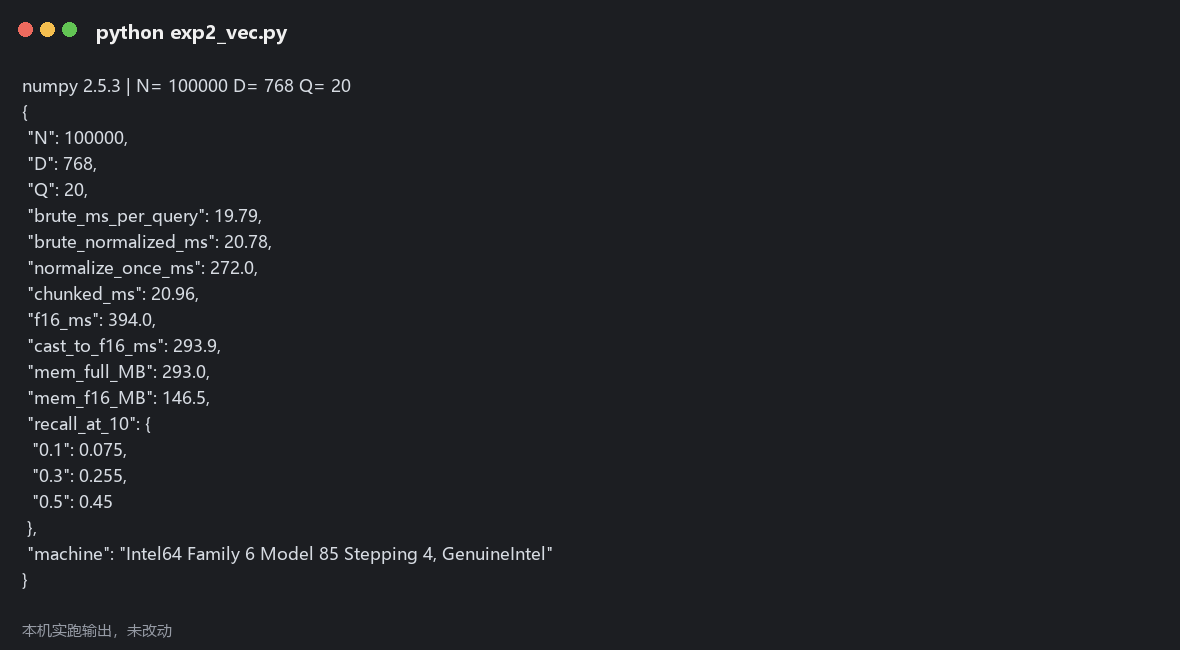
10 万个向量,每个 768 维,float32。
这批向量是随机数生成的,不是真实文章算出来的。
所以下面的耗时是真的,检索结果有没有语义,这批数据证明不了。
这点得先讲。
不然后面那些毫秒数就是在装。
单条查询 19.79 毫秒
20 次取均值。
10 万个向量、每个 768 个数,一次查询要做 10 万乘 768 次乘加。乘加算两次浮点运算,一共 1.536 亿次。
19.79 毫秒跑完 1.536 亿次,大概是每秒 77.6 亿次浮点运算。
我不打算夸这个数字。
它只说明一件事:这台机器上一个普通 CPU 核心,算这么点量不算费劲。
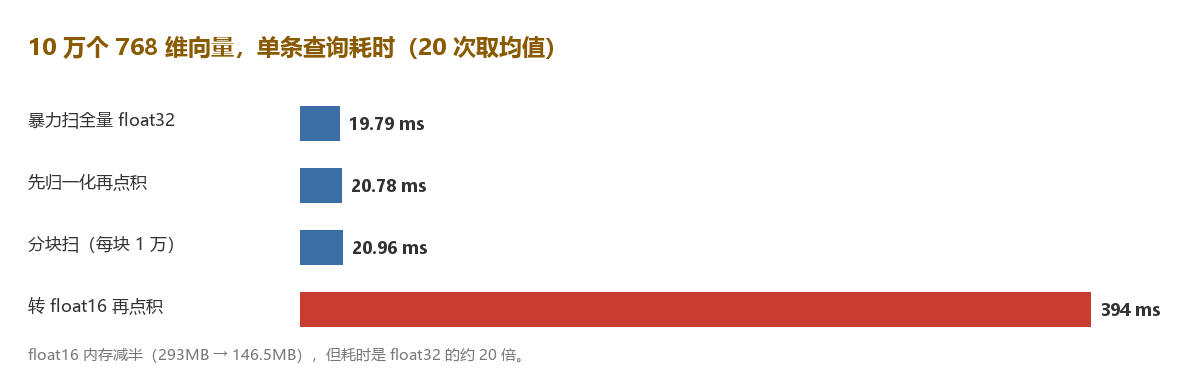
转了 float16,慢了 20 倍
网上不少帖子说 float16 能省一半内存,还能加速。
内存确实省了。
293.0 MB 变成 146.5 MB,正好一半。
耗时呢。
float32 是 19.79 毫秒,float16 是 394.0 毫秒。
慢了将近 20 倍。
我还量了转换本身:把 10 万个向量转成 float16 花了 293.9 毫秒。
光转换一次,够 float32 算十五次查询。
为什么会这样,我能确认的只有一条观察:numpy 在 CPU 上做 float16 运算时,很多情况要先转成 float32 算,算完再转回去。具体哪些运算会转、哪些不会,我没读 numpy 源码【暂无相关资料】。
这不是说 float16 没用。
它显存省一半,GPU 上另有说法。
我这次只测了 CPU。
分块扫不会更快
有人说数据太大要分批扫,避免一次性占内存。
我按每块 1 万个分了 10 块,20.96 毫秒。
和一次性扫的 19.79 毫秒比,基本一样,还略慢一点点。
分块解决的是内存峰值,不是速度。
这两件事经常被混着说。
只扫一半数据,前十条只捞回 45%
这个坑比前面几个都实在。
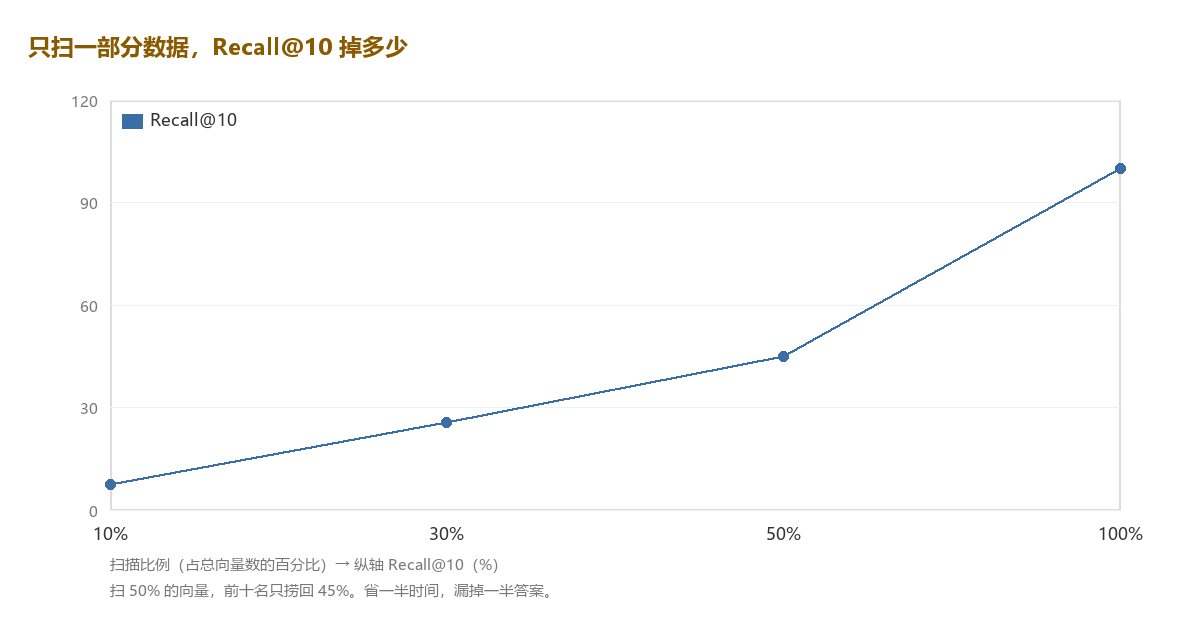
我拿全量扫出来的前十名当真值,再只扫前面一部分数据,看能捞回几个。
扫 10%,Recall@10 是 7.5%。
扫 30%,25.5%。
扫 50%,45%。
扫一半的数据,答案漏一半多。
「少扫一点提速」在纯暴力检索里行不通,除非你有别的手段先把候选集缩小,比如倒排、聚类、图索引。那些手段我这次没测【本人未实测】。
一个计时上的坑
第一次跑的时候,把 10 万个向量做归一化用了 1019.6 毫秒。
第二次同样的代码,272.0 毫秒。
差 3.7 倍。
同一台机器、同一份数据、同一段代码。
差别就在第一次要分配内存、要摸数据布局。Python 里一次性的计时,尤其带大内存分配的,单跑一遍基本不可信。
我后面的数都是 20 次取均值。归一化这种一次性操作没法取均值,只能把两个数都记下来。
到这里能确认的
10 万个 768 维向量,这台机器上单条查询 19.79 毫秒,大约每秒 50 次。
float16 在这条路上不划算:省一半内存,慢 20 倍。
只扫一部分数据会掉召回,掉得比想象中多。
我个人怎么用
【个人看法】十万级这个规模,先老老实实全量扫。20 毫秒对搜索框来说够用了,用户感觉不到。真到了百万、千万级再上索引,那时候一次性投入建索引才划算。
为了 20 毫秒去搭一套索引系统,我觉得不值。
不过这也看查询量。
每秒几十次和每秒几千次,是两种账。
你们那边检索是多大向量、多少查询量?
说个数,我按你们的量级再算一遍。