-
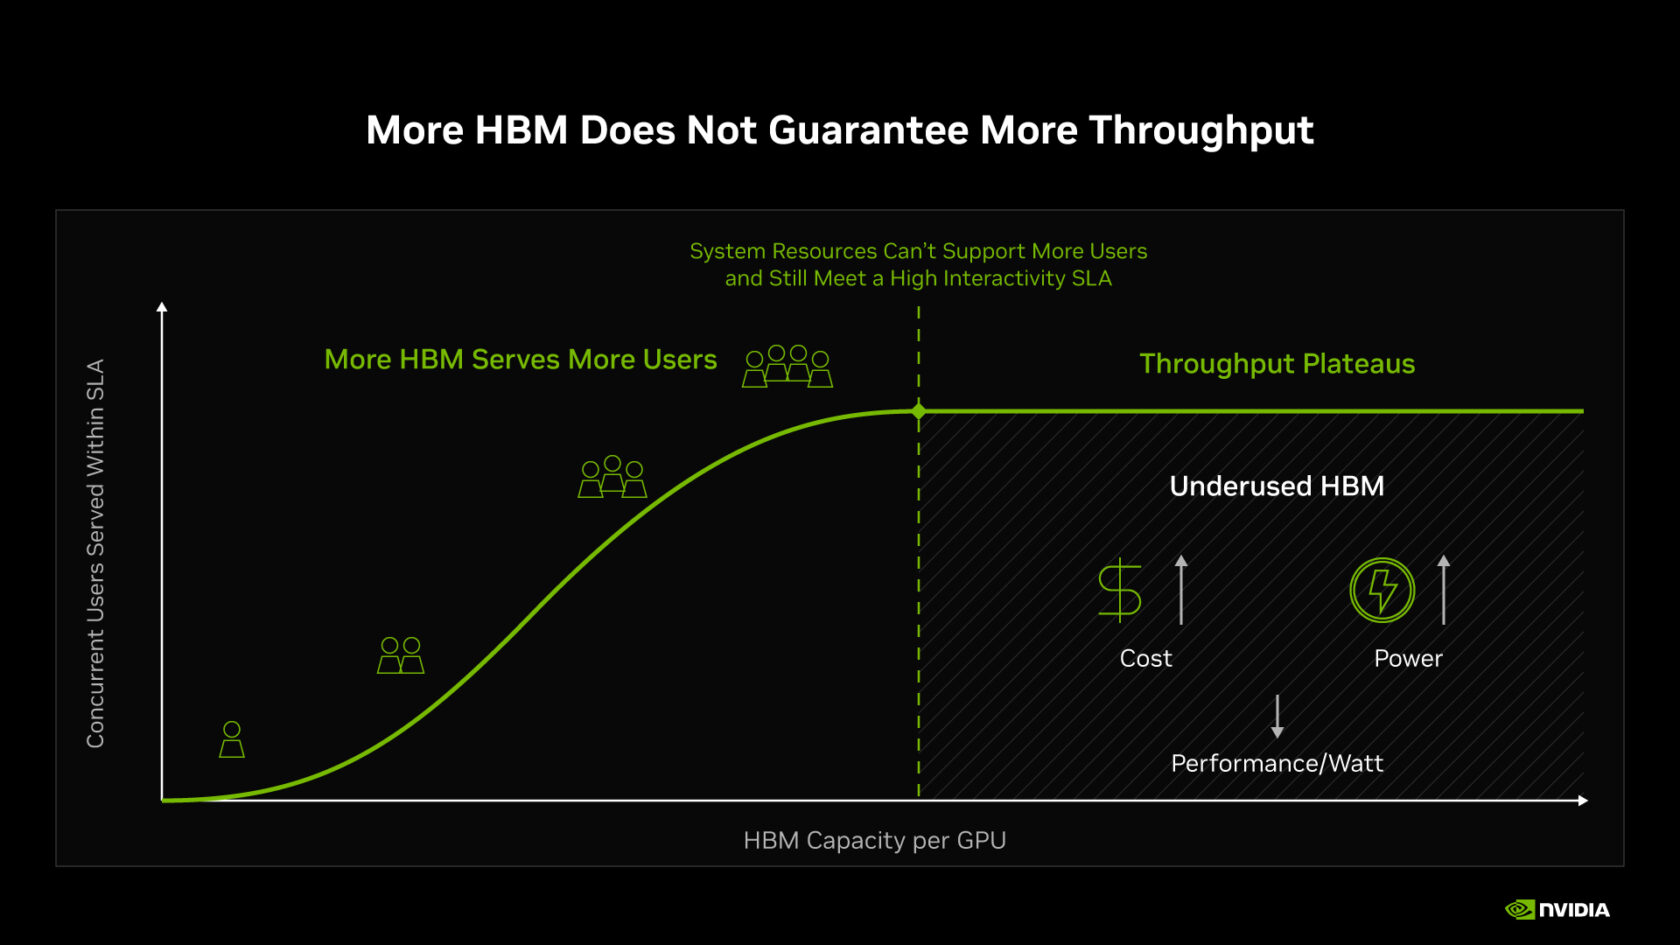 显存只加了 3%,每美元能跑的智能体多了 30 倍
英伟达 11 月 5 日发布技术解读,讲 AI 的内存瓶颈:推理时 HBM 既要装模型权重,也要保存 KV 缓存,智能体在多次调用间要一直带着历史上下文,部分场景要处理多达 300 万个 token。它的办法是 NVFP4 压缩、NVL72 把权重分到最多 72 颗 GPU、Vera CPU 的 LPDDR 做就近缓冲、Dynamo 把不活跃上下文迁到 CMX。据 SemiAnalysis 的 AgentX 基准,每用户每秒 125 token 时,Vera Rubin NVL72 比 GB300 NVL72 每美元智能体吞吐量最高提升 30 倍,而每 GPU 的 HBM 容量只增加约 3%。文中也标了厂商没区分、我没验证的部分。
-
 智驾芯片的 254 TOPS,一半是“吹牛算力”
英伟达 Orin X 的标称算力是 254 TOPS,同一颗芯片只算稠密算力,是 127 TOPS。差的那一倍来自稀疏化:硬件碰到矩阵里的 0 就跳过去不算,标称值因此翻倍。10 月 30 日,地平线创始人余凯在微博上把这层纸捅破,说中国科技行业在 PPT 算力上已经卷到无底线,业界把标称吹到稠密算力的 6 到 7 倍,还起了个名字叫等效算力。他宣布地平线今后同时标注两个数,并把另一种直呼为“吹牛算力”。文章讲清 TOPS、稠密与稀疏的区别,给出看懂芯片宣传数字的三个动作。
-
 英伟达这次没堆参数,反而砍到120亿
英伟达发布开放多模态模型 Nemotron 3.5 Super VL,面向需要持续运行、执行多步骤任务的 AI 智能体。MoE 架构,总参数 1200 亿、激活 120 亿,官方称单张 GPU 上执行智能体任务时吞吐量最高可达同规模其他开放模型的 5 倍。企业案例:Scale AI 为 Skydance 定制供应商信用处理智能体,推理成本预计降 97.5%;Ramp 做收据转结构化数据,吞吐最高提升 50%。同时推出端侧 Bolt 74B-A9B,原生 2 位量化压缩至 24GB。
-
 AI 智能体跑偏了,现在有东西能在毫秒内把它关掉
英伟达发布 AI 智能体安全平台:OpenShell 给智能体划边界,Sentry 跑在 BlueField-4 DPU 上、能在毫秒内隔离越界智能体,Anthropic、SpaceX、Scale AI 已接入。这篇讲清智能体越权到底怎么发生,并给出三条今天就能画好的权限边界。