北京清华长庚医院的门诊里,18 个临床科室正在测试一套 AI 系统。40 余名医生天天在用。
最反常的地方不是它能给建议。是几个科室的分身意见不一致的时候,系统不劝架。
两条建议并排摆着,不一样的地方标出来,哪条来自哪个科室写得清清楚楚。
签字的还是医生。
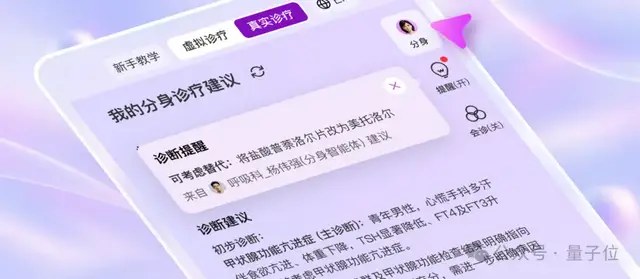
这一幕的起点很普通:一位甲亢患者坐下来说了几分钟,屏幕上跳出两条建议。一条来自内分泌科,一条来自呼吸科。
绕的那几步,谁都走过
家里人查出个说不清的病,第一步挂内科。内科查不出,转外科。外科看完,让去影像科。
影像科的号排到两周后。
几个科的号挂遍了,才凑上一次正式的多学科会诊,行话叫 MDT。
等凑齐的时候,最好的观察窗口可能已经过去。
还有一笔账。一次 MDT,光把各科专家的时间凑到一起,会诊费就不低。
这不是哪家医院态度不好,是流程本来就这么长。
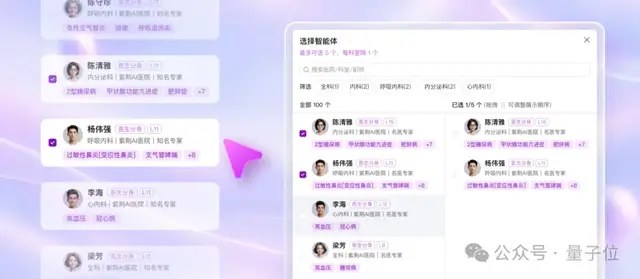
54 个分身,各管一段
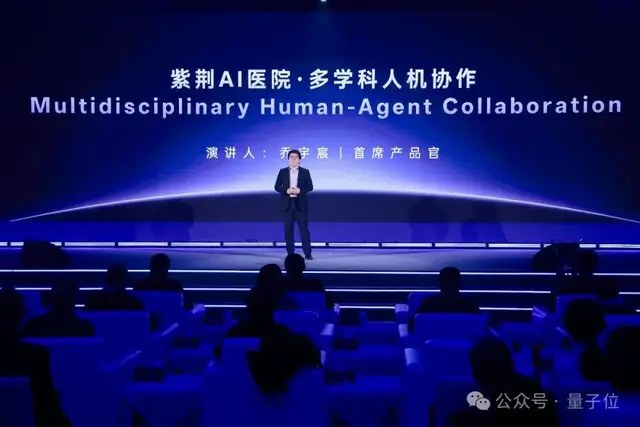
紫荆AI医院是紫荆智康做的,清华智能产业研究院(AIR)孵化,公司两年前才成立。
系统已经在全国各地的医院陆续上线测试。
截至 2026 年 7 月,它构建了 54 位 AI 医生、数百万超拟真 AI 患者,覆盖数千种疾病。
技术上叫「多分身智能体协同」。
同科室的问题,一个分身就够。跨学科的问题,就把几个分身拉进同一个协作会议,不同专长依次加入。
落到诊室里是两种形态。
一种叫按需提醒。不打断原来的流程,识别到别的专科可能有问题,弹个提醒就完事。
另一种叫会诊模式。几个分身直接进来,围绕诊断、用药给建议,医生自己权衡。
上面那位甲亢患者就是例子。他还带着哮喘病史,呼吸科的分身介入,提醒医生当心后面的用药风险。
哮喘这两个字是患者自己说的。门诊时间紧,医生未必顾得上追问。分身接住了。
意见不一致,它不劝架
这是整套系统里最反常的一处。
按直觉,AI 该把分歧收敛掉,输出一个统一结论。省事,也好看。
它没有。
分身意见不一致的时候,系统不主动统一。几条建议分别摆着,不一致的地方高亮。医生能看到每条建议来自哪个分身。
道理不复杂:分歧本身就是信息。
两个专科看法不一样,往往说明这个病正好卡在两科的缝上。硬合成一句话,缝就被抹平了。
医生要的不是一句结论,是哪一科在担心什么。
一盒进了医保的药
紫荆AI医院的首席产品官乔宇宸讲过一个细节。
AI 推荐的药,是疗效排在第一位的那盒。医生看了看患者的情况,最后换成了相对便宜、进了医保的药。
疗效占优的那盒,未必是患者长期吃得下去的那盒。
这里面没有谁错。AI 按疗效排序,医生还得算另一笔账:这盒药,他家能不能一直吃。
系统也走过弯路。早期模型有个倾向,把各种可能性考虑得过于充分。
查得越全,建议越多,看着越专业。可患者坐在那儿,要的是一个能落地的方案。
看病从来不只是医学题。
这些东西是怎么练出来的
靠一套叫 SEAL 的架构,全称「基于拟像的可进化智能体学习」。
拆开两层:虚拟世界里练,现实世界里验,再微调。
虚拟环境里,患者、医生、护士全是智能体扮的。百万级 AI 患者,几天内能跑完几十万甚至上百万个案例。
算力消耗比传统大模型训练低得多。
练完再进门诊。三端产品跟着铺开:患者端做预问诊和健康资料,医生端是分身、病历、决策辅助,医院端管排班、权限、数据。
国外也在往这个方向走。
微软的 MAI-DxO 模拟医生团队,研究诊断准确性和成本怎么平衡。Healthcare Agent Orchestrator 把不同智能体组织起来,围绕肿瘤会诊搭工作流。
路子不一样,想解决的是同一件事:一个医生,怎么同时拥有好几个专科的脑子。
它还是会答错
写到这儿得说清楚几件事。
第一件是准确率的边界。AI 医生在 MedQA 数据集上准确率超过 96%,也在多个国际医学评测数据集拿过第一。这是考试分数,不等于门诊不犯错。
报道里没给真实门诊的误诊率,也没给 AI 建议被医生采纳的比例。
第二件是那个 30% 的效率提升。数字来自院方口径。怎么测的,哪些科室、多少人次,报道都没写。
第三件是那盒医保药。它说明 AI 现在还不懂患者的处境——收入、报销、家里还有几口人要养。这些信息不在病历里,也不在训练数据里。
第四件是责任。签字的是医生。系统把分歧摆出来,等于把判断的重量留给了人。
以前要凑齐这些人,得发会诊单、约时间、等排期。
现在他们就在屏幕里,还坦白告诉你:我们几个看法不一样。
这话听着像宣传语。但我去翻了那个界面截图,一个诊室里确实能同时摆着内分泌、呼吸、影像几个视角,标签清清楚楚。
文中数字、案例与引述均取自原报道(量子位,2026 年 10 月),未做补充推测。配图取自原报道,仅用于说明。