-
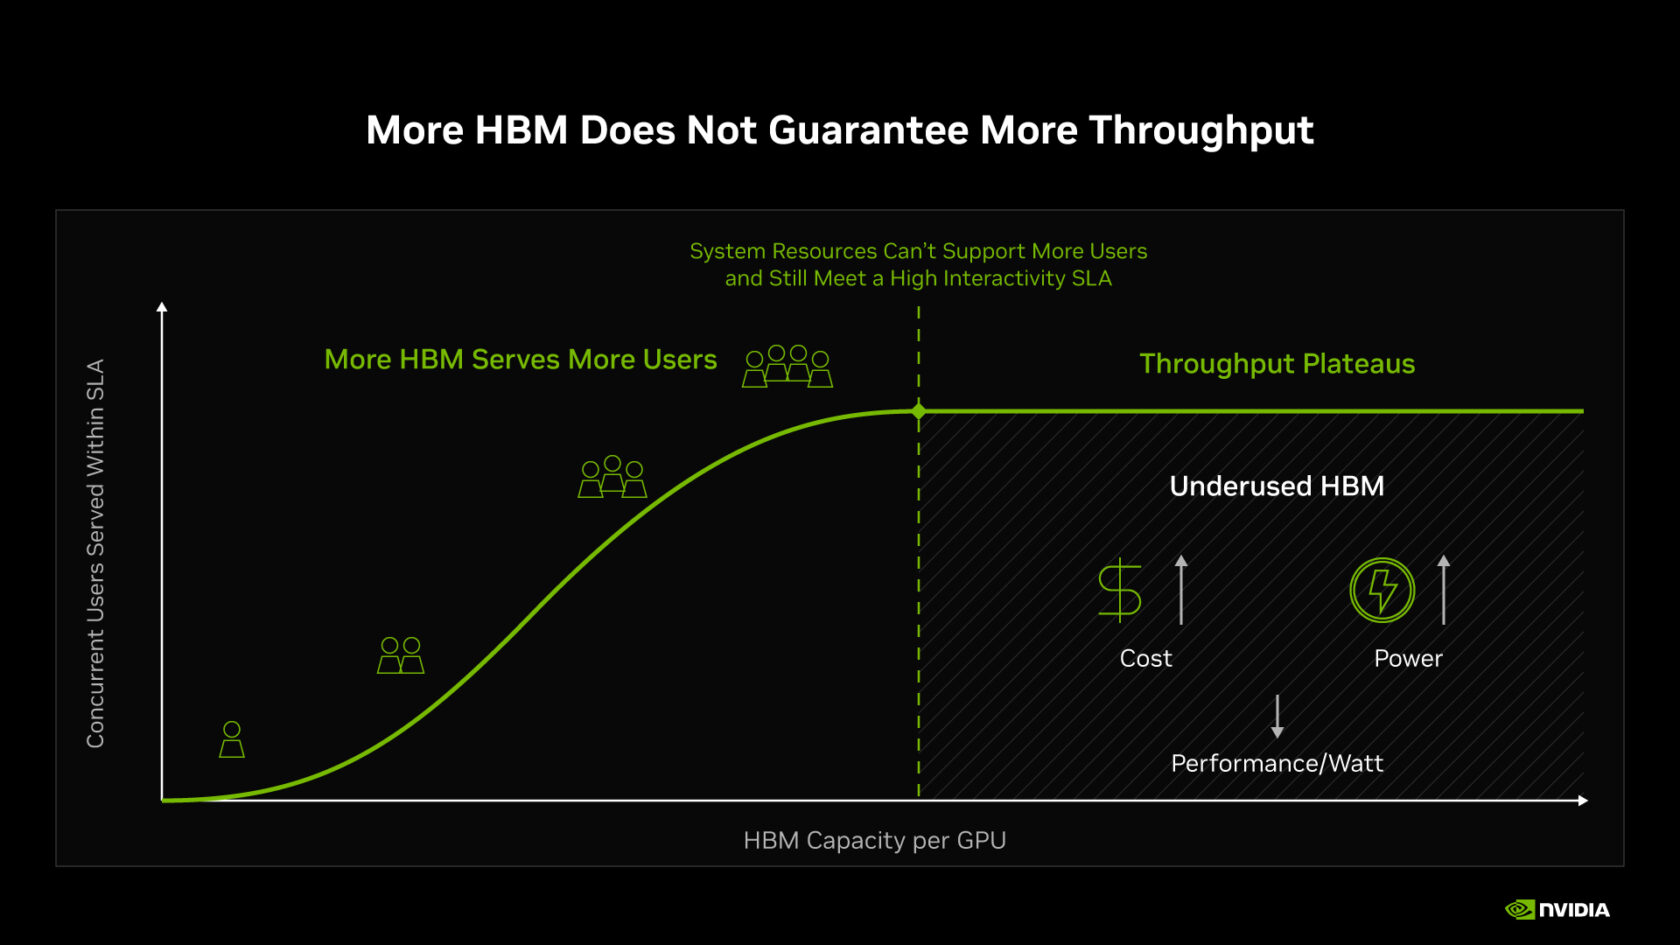 显存只加了 3%,每美元能跑的智能体多了 30 倍
英伟达 11 月 5 日发布技术解读,讲 AI 的内存瓶颈:推理时 HBM 既要装模型权重,也要保存 KV 缓存,智能体在多次调用间要一直带着历史上下文,部分场景要处理多达 300 万个 token。它的办法是 NVFP4 压缩、NVL72 把权重分到最多 72 颗 GPU、Vera CPU 的 LPDDR 做就近缓冲、Dynamo 把不活跃上下文迁到 CMX。据 SemiAnalysis 的 AgentX 基准,每用户每秒 125 token 时,Vera Rubin NVL72 比 GB300 NVL72 每美元智能体吞吐量最高提升 30 倍,而每 GPU 的 HBM 容量只增加约 3%。文中也标了厂商没区分、我没验证的部分。
-
 基辛格又开炮:HBM是糟糕的内存,AI算力卡在哪
前英特尔CEO基辛格在a16z专访中批评HBM,称其位密度低、散热差、海岸线带宽受限,对AI这类内存计算密集型负载是灾难性的。报道同时提到,整摞堆叠后每平方毫米的累计密度其实更高。
-
 2027 年 HBM 要涨 121%,你的下一台电脑更贵了
集邦上调 HBM 2027 年价格展望,预计同比涨 121%;AI 服务器抢走产能,通用内存也被挤;AI 芯片改用 8Hi 低堆叠,成本仍高 10% 到 20%。这篇讲清这笔账怎么一路传到装机单和手机上,以及换不换机该怎么判断。