-
 显存只加了 3%,每美元能跑的智能体多了 30 倍
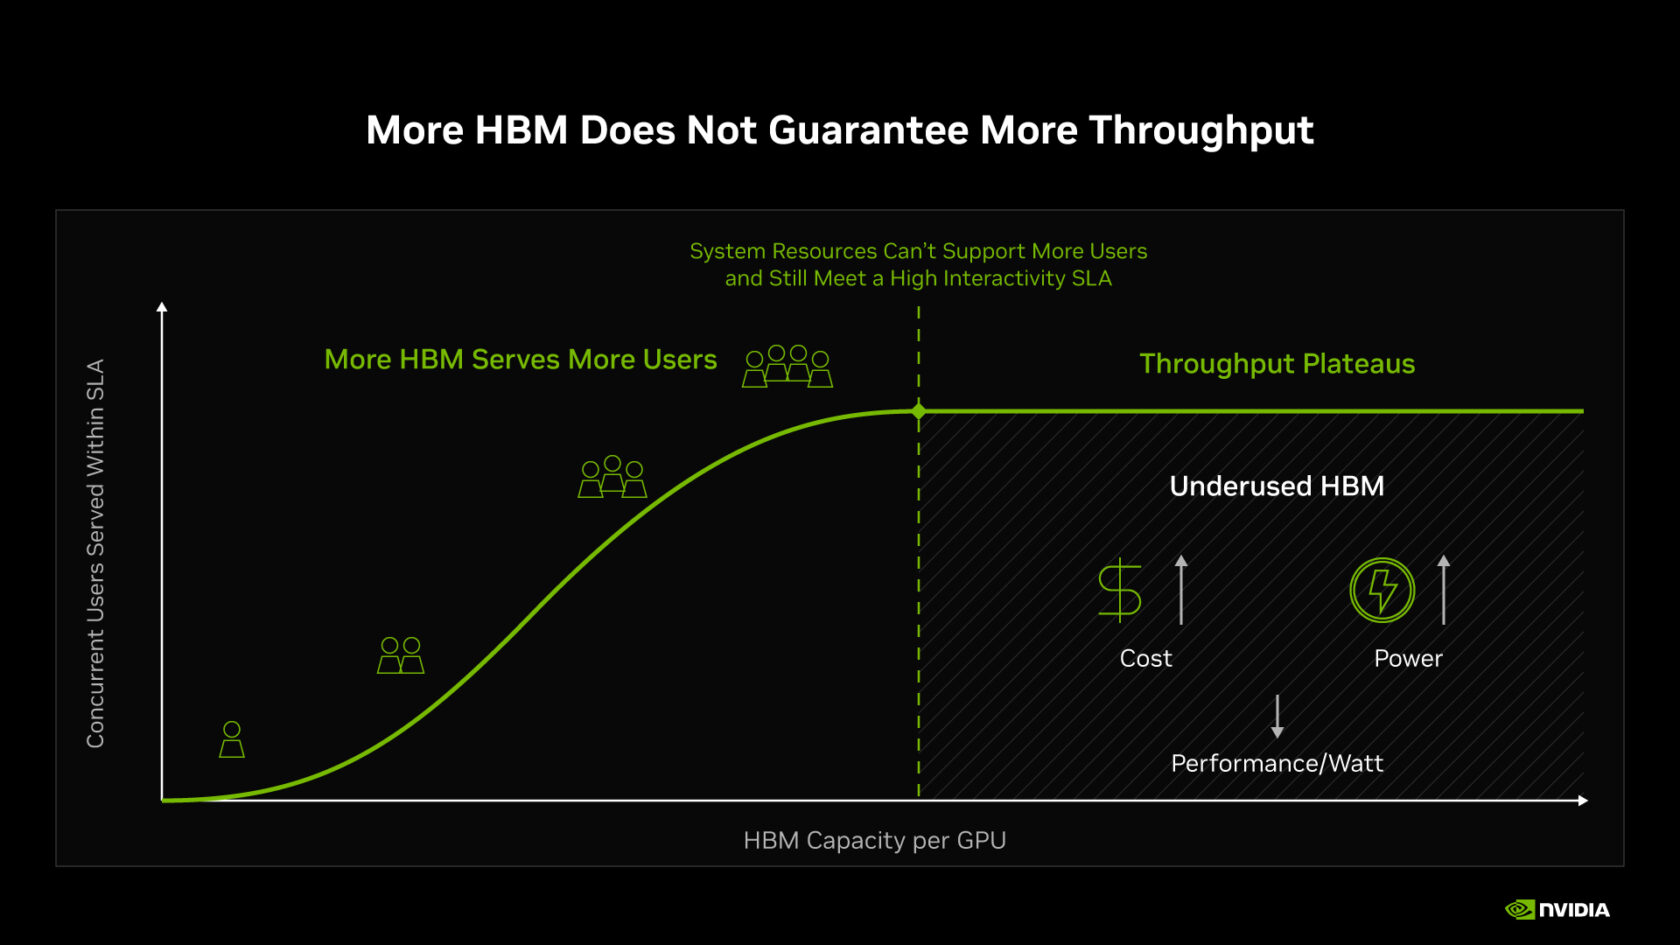
英伟达 11 月 5 日发布技术解读,讲 AI 的内存瓶颈:推理时 HBM 既要装模型权重,也要保存 KV 缓存,智能体在多次调用间要一直带着历史上下文,部分场景要处理多达 300 万个 token。它的办法是 NVFP4 压缩、NVL72 把权重分到最多 72 颗 GPU、Vera CPU 的 LPDDR 做就近缓冲、Dynamo 把不活跃上下文迁到 CMX。据 SemiAnalysis 的 AgentX 基准,每用户每秒 125 token 时,Vera Rubin NVL72 比 GB300 NVL72 每美元智能体吞吐量最高提升 30 倍,而每 GPU 的 HBM 容量只增加约 3%。文中也标了厂商没区分、我没验证的部分。